
【scrapy】使用方法概要(一)(转)
【请初学者作为参考,不建议高手看这个浪费时间】
工作中经常会有这种需求,需要抓取互联网上的数据。笔者就经常遇到这种需求,一般情况下会临时写个抓取程序,但是每次遇到这种需求的时候,都几乎要重头写,特别是面临需要抓取大数量网页,并且被抓取网站有放抓取机制的时候,处理起来就会很麻烦。
无意中接触到了一个开源的抓取框架scrapy,按照introduction做了第一个dirbot爬虫,觉得很方便,就小小研究了一下,并在工作中用到过几次。
scrapy的文档是英文的,网上相关的说明很少,使用的过程中也遇到过很多问题,大部分都是在 stack overflow 上找到的解答,看来这个工具国外的同行们用的会更多些。鉴于国内关于scrapy的文章甚少,笔者希望能用自己的一些浅显的经验希望帮助大家更快对scrapy入门,作为笔者的第一篇分享文章,很难一气呵成完成,本文将分为几个部分,按照我自己的学习曲线作为组织,如果有错误,希望大家指正。
首先简要终结一下我认为scrapy最便利的几个地方:
1. 代码分工明确,一个抓取任务只需要在几个位置固定的地方增加代码,很容易就能写出基本的抓取功能。
2. 框架隐藏了很多抓取细节,如任务调度,重试机制,但并不是说框架不够灵活,例如框架支持以添加中间件的方式更改隐藏的细节,满足特殊需要,如使用代理ip池进行抓取,防止服务器封掉ip。
好啦,下面正式开始,从安装开始
笔者的运行环境是:linux python2.5
包管理使用的是:apt-get
安装流程:
1. 首先去官方网站下载源码
https://github.com/scrapy/scrapy/tarball/0.14
2. 安装scrapy以来的python库
sudo apt-get install python-twisted python-libxml2 python-pyopenssl python-simplejson
3. 安装
tar zxf Scrapy-X.X.X.tar.gz
cd Scrapy-X.X.X
sudo python setup.py install
4. 执行
scrapy
如果出现
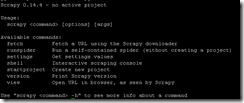
恭喜你,安装成功。
【未完待续~~~~~】
【scrapy】使用方法概要(一)(转)的更多相关文章
- Python3 Scrapy 安装方法
Python3 Scrapy 安装方法 (一脸辛酸泪) 写在前面 最近在学习爬虫,在熟悉了Python语言和BeautifulSoup4后打算下个爬虫框架试试. 没想到啊,这坑太深了... 看了看相关 ...
- 【scrapy】使用方法概要(三)(转)
请初学者作为参考,不建议高手看这个浪费时间] 前两篇大概讲述了scrapy的安装及工作流程.这篇文章主要以一个实例来介绍scrapy的开发流程,本想以教程自带的dirbot作为例子,但感觉大家应该最先 ...
- 【scrapy】使用方法概要(二)(转)
[请初学者作为参考,不建议高手看这个浪费时间] 上一篇文章里介绍了scrapy的主要优点及linux下的安装方式,此篇文章将简要介绍scrapy的爬取过程,本文大部分内容源于scrapy文档,翻译并加 ...
- 【scrapy】使用方法概要(四)(转)
[请初学者作为参考,不建议高手看这个浪费时间] 上一篇文章,我们抓取到了一大批代理ip,本篇文章介绍如何实现downloaderMiddleware,达到随即使用代理ip对目标网站进行抓取的. 抓取的 ...
- 简单总结scrapy使用方法
应课程需要写了几天爬虫,一开始使用requests+bs4的技术路线,但是速度不是很理想而且不能暂停,通过查阅资料,发现scrapy正是我需要的 做一下简短的记录: 首先应该毫不犹豫的scrapy s ...
- Scrapy安装方法
Scrapy安装在Python2.7环境下 1.配置环境变量: 2.安装基础软件 4个(64位系统) 安装twisted: C:\Users\Administrator>pip install ...
- virtualenv简介以及一个比较折腾的scrapy安装方法
本文来自网易云社区 作者:沈高峰 virtualenv + pip 安装python软件包是一种非常好的选择,在大部分情况下安装python软件包是不需要求助于sa的. 使用自己的一个工作副本也是写p ...
- python-1.Centos7安装Python3.6和Scrapy的方法
由于centos7原本就安装了Python2,而且这个Python2不能被删除,因为有很多系统命令,比如yum都要用到 [root@iZm5efjrz9szlsq1a0ai3gZ ~]# python ...
- python scrapy解码方法和时间格式转换
import scrapy from datetime import datetime class BianSpider(scrapy.Spider): name = 'bian' # allowed ...
随机推荐
- [ python ] 学习目录大纲
简易博客[html+css]练习 MySQL 练习题及答案 MySQL视图.触发器.函数.存储过程 MySQL 操作总结 Day41 - 异步IO.协程 Day39/40 - 线程的操作 Day36/ ...
- No.13 selenium for python 单选框和复选框
单选框 radio 点击图标,可以获取HTML中定位. 使用普通的ID定位就可以了 定位到指定元素,然后使用clicd选中即可 复选框 checkbox 勾选单个框,跟单选框一样,定位后点击就可以了 ...
- NYOJ 石子合并(一)(区间DP)
题目链接:http://acm.nyist.edu.cn/JudgeOnline/problem.php?pid=737 题目大意: 有N堆石子排成一排,每堆石子有一定的数量.现要将N堆石子并成为一堆 ...
- MySQL学习笔记:删除存储过程和函数
删除存储过程.存储函数主要使用drop语句: drop procedure —— 删除存储过程 drop function —— 删除存储函数 语法: DROP {PROCEDURE|FUNCTI ...
- Jenkins在Linux环境安装
Jenkins介绍 Jenkins是基于Java开发的一种持续集成工具,用于监控持续重复的工作,功能包括: 1.持续的软件版本发布/测试项目. 2.监控外部调用执行的工作. 安装环境 操作系统:lin ...
- 更改Chrome浏览器安装位置的方法
因为Google Chrome独特的优势,我们很多人都在使用它,但同时我们也会发现它是默认安装在我们的系统盘的,那么是否就不能修改其安装路径了呢?其实不然,这里介绍一种方法,亲测可行. 一.正常安装 ...
- Ocelot 配置初始
{ "ReRoutes": [ { /*将用户的请求 /post/1 转发到 localhost/api/post/1*/ /* DownstreamPathTemplate:转到 ...
- 【POJ】2449.Remmarguts' Date(K短路 n log n + k log k + m算法,非A*,论文算法)
题解 (搬运一个原来博客的论文题) 抱着板题的心情去,结果有大坑 就是S == T的时候也一定要走,++K 我发现按照论文写得\(O(n \log n + m + k \ log k)\)算法没有玄学 ...
- 国内最火的 HTML、CSS、JavaScript 开源项目 Top 榜,你知多少?
对于开发者而言,想要着手前端开发,HTML.CSS 和 JavaScript 是三项必备的基础技能.而如何事半功倍地掌握好这些知识?通过了解当下火热的开源项目不乏为最佳学习姿势.本文盘点国内评分最高且 ...
- bzoj 3676 后缀自动机+马拉车+树上倍增
思路:用马拉车把一个串中的回文串个数降到O(n)级别,然后每个串在后缀自动机上倍增找个数. #include<bits/stdc++.h> #define LL long long #de ...