
分布式数据库NoSQL简介
NoSQL第一部分
一、什么是NoSQL?
问题:12306在开始诞生的前几年,每到重大节假日,经常“瘫痪”,直接原因就是集中超负荷的访问量。技术原因是它在此期间所采用的国际著名的某大型关系型数据库产品。这里暴露出来的问题特点便是:
(1) 传统大型关系型数据库无法更好地解决问题
(2) 在互联网上的应用
(3) 超大规模集中时间段在线访问和业务处理(订火车票)。
NoSQL正是为了解决这个问题而诞生了,重点突出处理速度的响应和海量数据的存储问题。
海量数据?PB级以上
二、 数据库分类
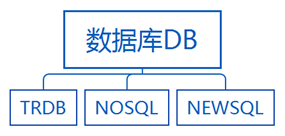
2.1 TRDB数据库
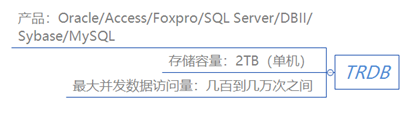
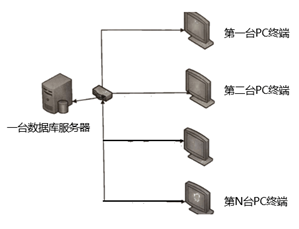
技术特点:
(1) 使用强存储模式技术。这里特别值数据库表、行、字段的建立,都需要预先严格定义,并进行相关属性约束。
(2) 采用SQL技术标准来定义和操作数据库。
(3) 采用强事务保证可用性及安全性
(4) 主要采用单机集中式处理(CP,Centralized Processing)方式。
分析:传统关系型数据库技术的产生,没有考虑过大数据下的应用需要,或者在当时的硬件环境下,无法很好地考虑。适用范围以政府、企业内部业务数据应用为主。在大数据环境下的直接使用,存在速度、存储、数据多样性等方面的技术瓶颈。
2.2 NoSQL数据库
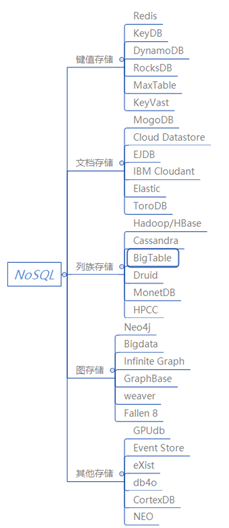
技术特点:
(1) 使用弱存储模式技术
(2) 没有采用SQL技术标准来定义和操作数据库
(3) 采用弱事务保证数据可用性及安全性或根本没有事务处理机制。
(4) 主要采用多机分布式处理(DP,Distributed Processing)方式。
目的:NoSQL技术是为大数据的应用而研发的,是基于互联网大数据应用而产生的新一类数据库技术。
2.3 NewSQL数据库
目的:为了结合TRDB和NoSQL的优点,实现在大数据环境下的数据存储和处理。既要实现NoSQL技术快速、有效的大数据处理能力,又要实现传统关系数据库的SQL、事务处理等的优势。
热门产品:PostgreSQL、SequoiaDB、SAPHANA、MariaDB、VoltDB、Clustrix等。
TRDB、NoSQL、NewSQL的一个小比喻:
船、飞机与水上飞机的关系,它们都是交通工具。船是最古老的一种交通工具,虽然目前不是其最旺盛的应用年代,但是现实世界还是离不开它;飞机是20世纪发明的新的交通工具,它的出现让我们远距离到达更加便捷;水上飞机出现结合了前两者的特点,既可以在水上开,又可以在天上飞,但是似乎并没有把船和飞机给淘汰了。它们三者应用领域各有侧重。TRDB、NoSQL、NewSQL也具有这样的关系。
三、TRDB与NoSQL的技术比较
3.1 单机的局限性
(1)传统关系型数据库系统设计之初主要基于一台服务进行业务运行的,所以其受单机的硬件性能影响,所能提供的业务应用能力是受到严格限制的,最大性能不能超过单机硬件运行的极限.这里的极限包括了CPU、硬盘、主板、内存、网卡等的IO速度,硬盘、内存的存储空间等。
(2)这里的核心瓶颈是硬盘,它的IO速度会比内存慢得多,而且自身再提高受物理性能限制,进展特别缓慢。另外,单硬盘的容量也是有限。
3.2服务器的纵横扩充
当单机的诸多局限性出现后,人们为了解决数据处理问题,通过两个方向的努力,想解决该问题。一个是基于服务器本身的功能挖掘,所谓的纵向扩充;另外一个是基于多服务器的横向扩充。
(1) 纵向扩充
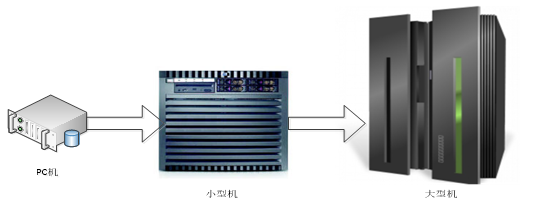
(纵向扩充,产生了基于内存的NOSQL数据库产品)
主要从物理高配置扩充和基于内存处理的两个方面着手。如Redis、FastDB、Memcached等,主要解决数据处理速度问题。
(2) 横向扩充
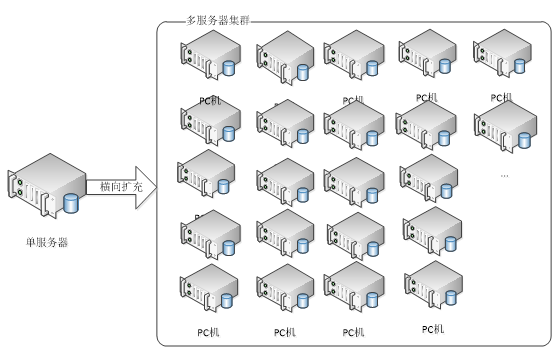
(NOSQL数据库的主要应用硬件环境)
采用多服务器,通过集群(Cluster)一起处理数据。
3.3 软件实现技术比较
NOSQL是弥补传统关系型数据库技术的不足而产生的新的数据库技术。能正确区分TRDB与NOSQL技术的不同特点,无论是深入理解NOSQL的设计和执行原理,还是进行不同数据库技术选择,都是非常有必要的。
∴数据库数据存储模式不一样,TRDB为强数据存储模式,NOSQL为弱数据存储模式;
∴分布式技术是NOSQL的核心技术思路,而TRDB以集中部署一台物理机为最初出发点;
∴TRDB的事务严格遵循ACID原则,而NOSQL遵循Base原则或者根本没有;
∴TRDB都遵循SQL操作标准,NOSQL没有统一的操作标准;
∴TRDB基于单机的硬盘数据处理技术为主,NOSQL基于分布式的或者内存数据处理技术为主;
(1) 数据库存储结构更加简单
去掉TRDB的严格约束,是NOSQL的技术建立思路之一。
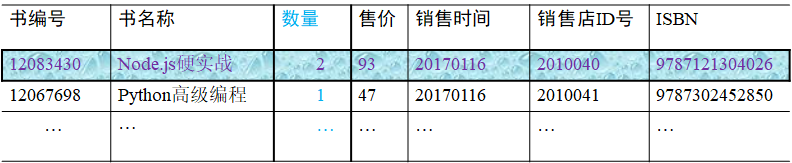
(2) 引入分布式技术架构
引入分布式管理软件系统是NOSQL技术建立思路之二。
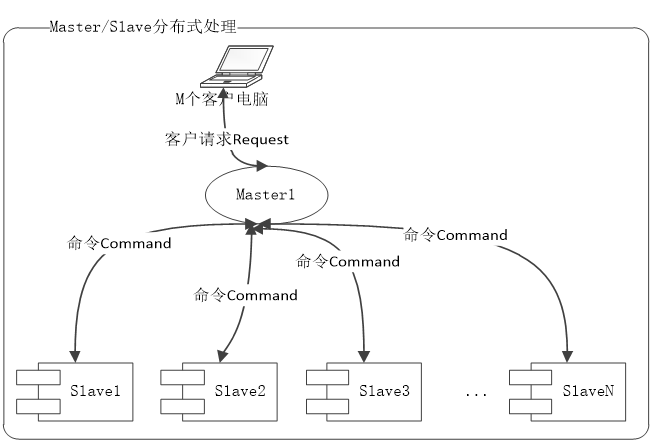
(3)事务
a) ACID强事务,确保数据的可用和准确性。
TRDB在具体数据处理过程,经常需要用到事务处理功能,目的为了保证数据处理的ACID,即原子性(A, Atomicity)、一致性(C, Consistency)、隔离性(I, Isolation)、持久性(D, Durability)。这四个属性通常称为ACID特性。
b) BASE事务,基本可用,允许数据偶尔出错。NoSQL技术建立思路之三。
NOSQL技术诞生那一刻,就定位于非结构性很强的数据,如网页、网站访问点击量、大量的视频存储、地理位置的最优路径处理、广告智能推送等。而这些数据允许插入出错,给客户带来的损失往往是可以接受的。
BASE:基本可用(BA, Basically Available)、软状态(S, Soft State)、最终一致性(E, Soft State)
(4) SQL技术标准
SQL是TRDB标准配置技术之一,关系数据库的典型特征,属于高级语言的特征。
NOSQL技术发展到现在,已经公开的并被使用的,有200多种数据库技术。相关的数据库存储及数据使用操作命令没有做到命名等的统一,这给学习、技术移植等带来了麻烦。后续NOSQL标准的统一是一种发展趋势。
(5)分析技术
NOSQL技术的发展,解决了大数据的存储和分析问题,由此产生了更多的分析技术;TRDB技术做不到对大数据的分析。
四、 NoSQL数据存储模式分析
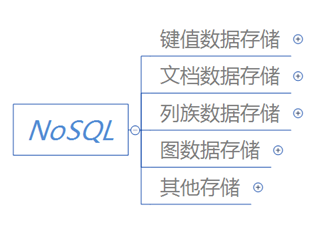
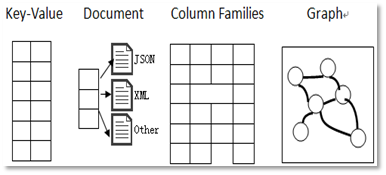
数据库的主要功能是存储和处理数据,由此NOSQL也不列外。鉴于NOSQL数据库系统现在至少有200多种产品,而且他们的存储模式没有统一标准,所以,我们需要对NOSQL的数据存储模式做分类介绍,这里重点介绍NOSQL的四大类数据库存储模式,包括了键值存储模式、文档存储模式、列族存储模式、图存储模式。
这里详细以列族数据库进行讲解,后面会以一个BigTable的一个产品进行详细介绍。
4.1 列族数据存储模式
列族数据库为了解决大数据存储问题,引入了分布式处理技术,为了提高数据操作效率,针对传统数据库的弱点,采用了去规则去约束化的思路。
(1) 列族数据库实现基本原理
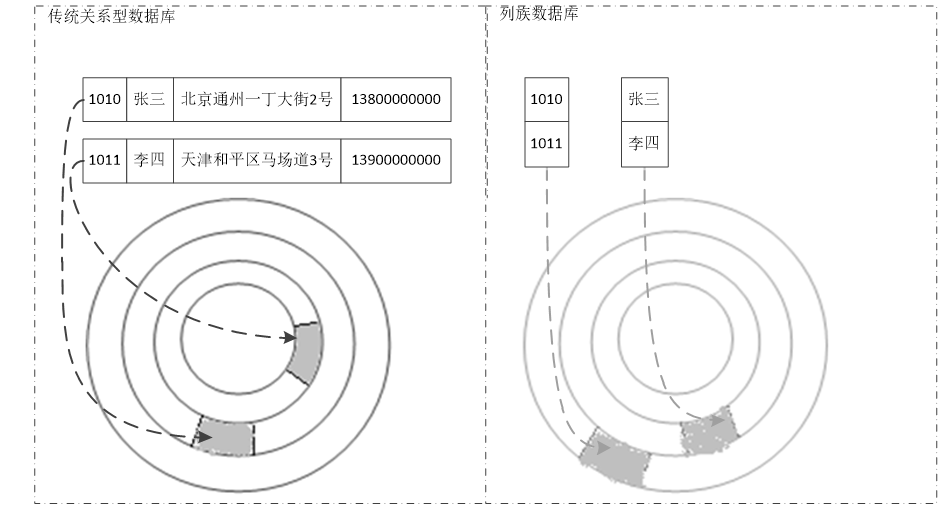
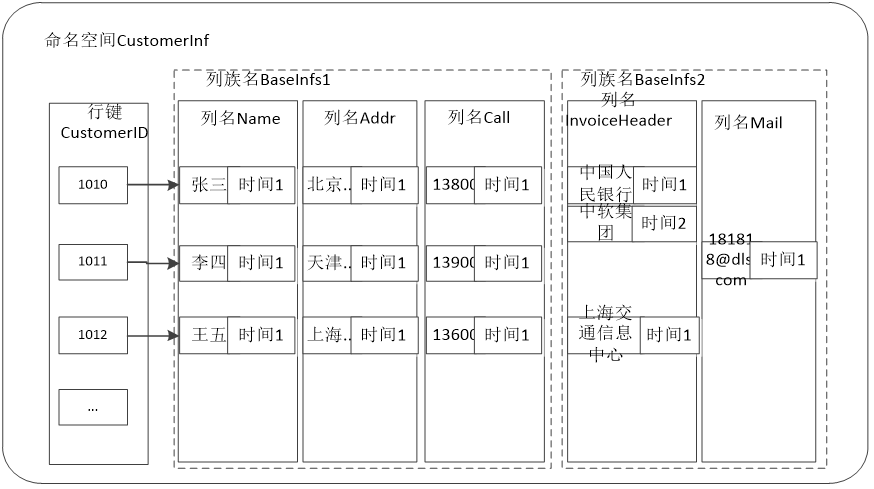
(2)列族数据库存储结构基本要素
- 命名空间(NameSpace)
命名空间是列族数据库的顶级数据库结构。相当于传统关系型数据库的表名。
- 行键(Row Key)
行键用来唯一确定列族数据库中不同行数据区别的标识符。
- 列族(Column Family)
由若干个列所构成的一个集合叫列族。
- 列(Column)
列是列族数据库里用来存放单个数值的数据结构。
列的每个值(Value)都附带时间戳(Time Stamp)。通过时间戳来区分值的不同版本。
(3)列族存储特点
- 擅长大数据处理
- 对于命名空间、行键、列族需要预先定义,列无须提早定义,随时可以增加。
- 在大数据应用环境下,管理复杂,必须借助各种高效的管理工具来监控系统的正常运行。
- Hadoop生态系统为基于列族的大数据分析,提供了各种开发工具
- 数据存储模式相对键值数据库、文档数据库要复杂。
- 查询功能相对更加丰富
- 高密集写入处理能力
分布式文件存储
在这个数据爆炸的时代,产生的数据量不断地在攀升,从GB,TB,PB,ZB.挖掘其中数据的价值也是企业在不断地追求的终极目标。但是要想对海量的数据进行挖掘,首先要考虑的就是海量数据的存储问题,比如Tb量级的数据。
谈到数据的存储,则不得不说的是磁盘的数据读写速度问题。早在上个世纪90年代初期,普通硬盘的可以存储的容量大概是1G左右,硬盘的读取速度大概为4.4MB/s.读取一张硬盘大概需要5分钟时间,但是如今硬盘的容量都在1TB左右了,相比扩展了近千倍。但是硬盘的读取速度大概是100MB/s。读完一个硬盘所需要的时间大概是2.5个小时。所以如果是基于TB级别的数据进行分析的话,光硬盘读取完数据都要好几天了,更谈不上计算分析了。那么该如何处理大数据的存储,计算分析呢?这就会涉及到如下的分布式文件存储。
常见的分布式文件系统
GFS、HDFS、Lustre 、Ceph 、GridFS 、mogileFS、TFS、FastDFS等。各自适用于不同的领域。它们都不是系统级的分布式文件系统,而是应用级的分布式文件存 储服务。
分布式文件存储选型比较
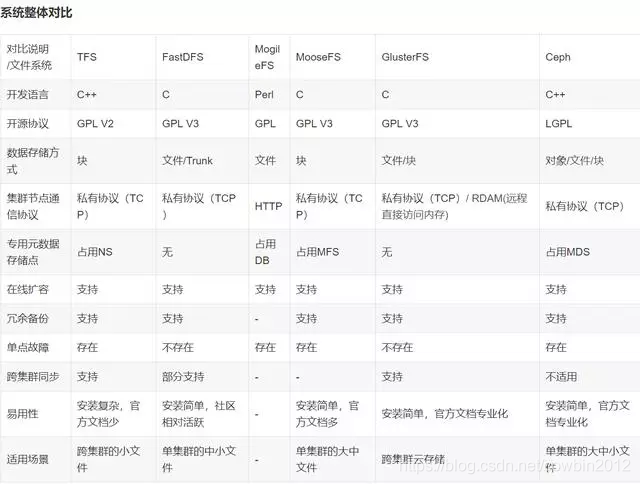
知名开源分布式文件存储
1.GFS(Google File System)
Google公司为了满足本公司需求而开发的基于Linux的专有分布式文件系统。尽管Google公布了该系统的一些技术细节,但Google并没有将该系统的软件部分作为开源软件发布。
2.HDFS
Hadoop 实现了一个分布式文件系统(Hadoop Distributed File System),简称HDFS。 Hadoop是Apache Lucene创始人Doug Cutting开发的使用广泛的文本搜索库。它起源于Apache Nutch,
后者是一个开源的网络搜索引擎,本身也是Luene项目的一部分。Aapche Hadoop架构是MapReduce算法的一种开源应用,是Google开创其帝国的重要基石。
3.TFS
TFS(Taobao FileSystem)是一个高可扩展、高可用、高性能、面向互联网服务的分布式文件系统,主要针对海量的非结构化数据,它构筑在普通的Linux机器 集群上,可为外部提供高可靠
和高并发的存储访问。TFS为淘宝提供海量小文件存储,通常文件大小不超过1M,满足了淘宝对小文件存储的需求,被广泛地应用 在淘宝各项应用中。它采用了HA架构和平滑扩容,保证了整个文件系统的可用性和扩展性。同时扁平化的数据组织结构,可将文件名映射到文件的物理地址,简化 了文件的访问流程,一定程度上为TFS提供了良好的读写性能。
Google学术论文,这是众多分布式文件系统的起源,HDFS和TFS都是参考Google的GFS设计出来的。
典型的分布式文件存储的架构设计
我以hadoop的HDFS为例,毕竟开源的分布式文件存储使用的最多。
Hadoop分布式文件系统(HDFS)被设计成适合运行在通用硬件(commodity hardware)上的分布式文件系统。HDFS是一个高度容错性的系统,适合部署在廉价的机器上。HDFS能提供高吞吐量的数据访问,非常适合大规模数据集上的应用。HDFS放宽了一部分POSIX约束,来实现流式读取文件系统数据的目的。
大规模数据集
运行在HDFS上的应用具有很大的数据集。HDFS上的一个典型文件大小一般都在G字节至T字节。因此,HDFS被调节以支持大文件存储。它应该能提供整体上高的数据传输带宽,能在一个集群里扩展到数百个节点。一个单一的HDFS实例应该能支撑数以千万计的文件。
简单的一致性模型
HDFS应用需要一个“一次写入多次读取”的文件访问模型。一个文件经过创建、写入和关闭之后就不需要改变。这一假设简化了数据一致性问题,并且使高吞吐量的数据访问成为可能。Map/Reduce应用或者网络爬虫应用都非常适合这个模型。目前还有计划在将来扩充这个模型,使之支持文件的附加写操作。
异构软硬件平台间的可移植性
HDFS在设计的时候就考虑到平台的可移植性。这种特性方便了HDFS作为大规模数据应用平台的推广。
Namenode 和 Datanode
HDFS采用master/slave架构。一个HDFS集群是由一个Namenode和一定数目的Datanodes组成。
Namenode是一个中心服务器,负责管理文件系统的名字空间(namespace)以及客户端对文件的访问。
集群中的Datanode一般是一个节点一个,负责管理它所在节点上的存储。HDFS暴露了文件系统的名字空间,用户能够以文件的形式在上面存储数据。从内部看,一个文件其实被分成一个或多个数据块,这些块存储在一组Datanode上。
Namenode执行文件系统的名字空间操作,比如打开、关闭、重命名文件或目录。它也负责确定数据块到具体Datanode节点的映射。Datanode负责处理文件系统客户端的读写请求。在Namenode的统一调度下进行数据块的创建、删除和复制。
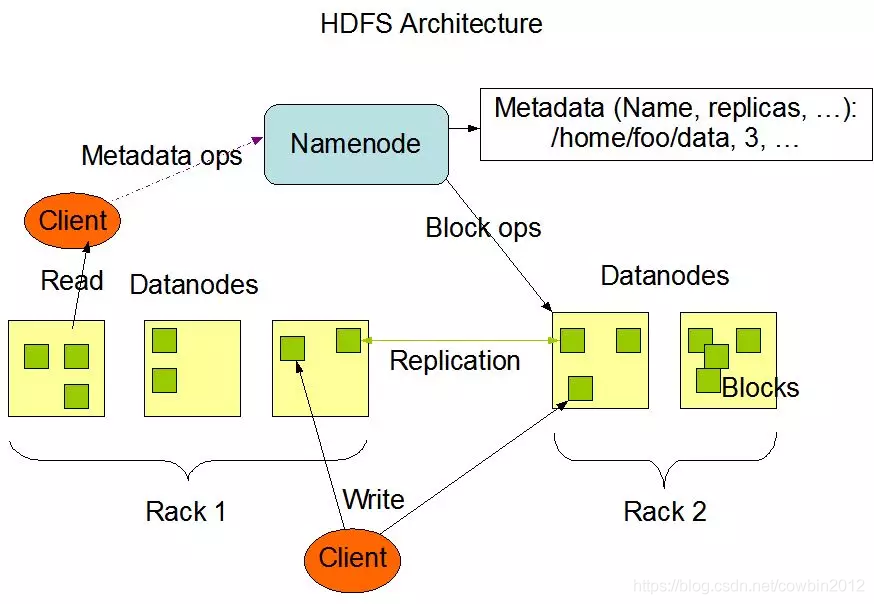
Namenode和Datanode被设计成可以在普通的商用机器上运行。这些机器一般运行着GNU/Linux操作系统(OS)。HDFS采用Java语言开发,因此任何支持Java的机器都可以部署Namenode或Datanode。由于采用了可移植性极强的Java语言,使得HDFS可以部署到多种类型的机器上。一个典型的部署场景是一台机器上只运行一个Namenode实例,而集群中的其它机器分别运行一个Datanode实例。这种架构并不排斥在一台机器上运行多个Datanode,只不过这样的情况比较少见。
分布式存储的未来
随着现代社会从工业时代过渡到信息时代,信息技术的发展以及人类生活的智能化带来数据的爆炸性增长,数据正成为世界上最有价值的资源。
根据物理存储形态,数据存储可分为集中式存储与分布式存储两种。集中式存储以传统存储阵列(传统存储)为主,分布式存储(云存储)以软件定义存储为主。
传统存储一向以可靠性高、稳定性好,功能丰富而著称,但与此同时,传统存储也暴露出横向扩展性差、价格昂贵、数据连通困难等不足,容易形成数据孤岛,导致数据中心管理和维护成本居高不下。
分布式存储:将数据分散存储在网络上的多台独立设备上,一般采用标准x86服务器和网络互联,并在其上运行相关存储软件,系统对外作为一个整体提供存储服务。。
总之,分布式文件存储,不仅提高了存储空间的利用率,还实现了弹性扩展,降低了运营成本,避免了资源浪费,更适合未来的数据爆炸时代场景。
————————————————
分布式数据库NoSQL简介的更多相关文章
- 【Hadoop】一、分布式数据库HBase简介
1.分布式数据库特点 说到数据库,我们最熟悉的是类似于mysql这样的关系型数据库,称为RDBMS.关系型数据库作为一种数据存储和数据检索的关键技术,它支持SQL语言的结构化查询,但是它天生不是为 ...
- (一)分布式数据库tidb-简介
因为数据磁盘问题,最近进行了更换库,所以决定写关于这方面的专题的博客,博客信息参考的官方文档. 一.分布式数据库使用背景 随着互联网的飞速发展,业务量可能在短短的时间内爆发式地增长,对应的数据量可能快 ...
- 从NoSQL到NewSQL,谈交易型分布式数据库建设要点
在上一篇文章<从架构特点到功能缺陷,重新认识分析型分布式数据库>中,我们完成了对不同"分布式数据库"的横向分析,本文Ivan将讲述拆解的第二部分,会结合NoSQL与Ne ...
- Nosql数据库的四大分类及分布式数据库CAP原理
1. Nosql数据库的四大分类 2. 分布式数据库CAP原理 2.1 关系型数据库事务遵循的ACID规则 首先了解传统关系型数据库事务遵循的ACID规则: 原子性(Atomicity):事务里的所有 ...
- (原创)MongoDB之NoSQL简介
Nosql简介1.1系统对数据的需求 Nosql[Nosql主要用途大数据处理]的全称为”not only sql”,为非关系型数据库[非关系型数据库就是关系型数据库的所有特点都没有了, ...
- 云时代的分布式数据库:阿里分布式数据库服务DRDS
发表于2015-07-15 21:47| 10943次阅读| 来源<程序员>杂志| 27 条评论| 作者王晶昱 <程序员>杂志数据库DRDS分布式沈询 摘要:伴随着系统性能.成 ...
- NoSQL 简介及什么是AICD
NoSQL 简介 NoSQL(NoSQL = Not Only SQL ),意即"不仅仅是SQL". 在现代的计算系统上每天网络上都会产生庞大的数据量. 这些数据有很大一部分是由关 ...
- mongodb(一) NoSQL简介
NoSQL简介 写在前面,本文就是学习的记录笔记,大部分内容都属于参考,分享给大家 关系与非关系数据库 那么应该了解下影响关系数据库性能的主要原因: 在关系型数据库中,导致性能欠佳的最主 ...
- net Core 使用MyCat分布式数据库,实现读写分离
net Core 使用MyCat分布式数据库,实现读写分离 目录索引 [无私分享:ASP.NET CORE 项目实战]目录索引 简介 MyCat2.0版本很快就发布了,关于MyCat的动态和一些问题, ...
- Nosql简介 Redis,Memchche,MongoDb的区别
本篇文章主要介绍Nosql的一些东西,以及Nosql中比较火的三个数据库Redis.Memchache.MongoDb和他们之间的区别.以下是本文章的阅读目录 一.Nosql介绍 1.Nosql简介 ...
随机推荐
- NOIP2015 提高组 子串
NOIP2015 提高组 子串 感觉是最长公共子序列模型的变式. 容易想到记 \(f[i][j][k]\) 表示 \(A\) 走到了第 \(i\) 位,\(B\) 匹配上了 \(1 \sim j\), ...
- 鸿蒙接入Flutter3.22
配置环境变量 配置HarmonyOS SDK和环境变量 API12, deveco-studio-5.0 或 command-line-tools-5.0 配置 Java17 配置环境变量 (SDK, ...
- 编写一个基础的dockerfile
编写简单的dockerfile FROM GaohongYu/centos7.5-yum:latest MAINTAINER GaoHongYu COPY *.repo /etc/yum.repos. ...
- Python爬虫基本库
3 基本库的使用 1)使用 urllib 是python内置的HTTP请求库,包含request.error.parse.robotparser urlopen() urllib.request.ur ...
- Flink 中的事件时间触发器和处理时间触发器
EventTimeTrigger EventTimeTrigger 的触发完全依赖 watermark,换言之,如果 stream 中没有 watermark,就不会触发 EventTimeTrigg ...
- SpringAI:Java 开发的智能新利器
一.SpringAI 简介 随着人工智能技术的飞速发展,越来越多的开发者开始探索如何将 AI 能力集成到现有的应用中来提升产品的智能化水平.Spring AI 正是为 Java 开发者提供的一款强大的 ...
- php之Opcache深入理解
PHP项目中,尤其是在高并发大流量的场景中,如何提升PHP的响应时间,是一项十分重要的工作.而Opcache又是优化PHP性能不可缺失的组件,尤其是应用了PHP框架的项目中,作用更是明显. 1. 概述 ...
- 2024-11-27:字符串的分数。用go语言,给定一个字符串 s,我们可以定义其“分数”为相邻字符的 ASCII 码差值绝对值的总和。 请计算并返回字符串 s 的分数。 输入:s = “hello“
2024-11-27:字符串的分数.用go语言,给定一个字符串 s,我们可以定义其"分数"为相邻字符的 ASCII 码差值绝对值的总和. 请计算并返回字符串 s 的分数. 输入:s ...
- docker构建supervisor镜像
1 介绍 记录使用docker 构建包含 supervior 的镜像, supervisor: 是一个管理和监控进程的程序,可以方便的通过配置文件来管理我们的任务脚本 将supervisor构建到系统 ...
- 禁用SAP Hana错误密码锁定用户功能
背景 公司项目适配多种数据库其中包含SAP Hana,由于有同事的数据库连接工具保存了某个在用的数据库的旧密码,导致时不时会被锁用户.通过查询官方文档已解决,这里统一记录一下. 禁用密码锁定方法 以下 ...