
solr6.6 导入 pdf/doc/txt/json/csv/xml文件
文本主要介绍通过solr界面dataimport工具导入文件,包括pdf、doc、txt 、json、csv、xml等文件,看索引结果有什么不同。其实关键是managed-schema、solrconfig.xml和data-config.xml(需要创建)这三个配置文件。
1、创建core
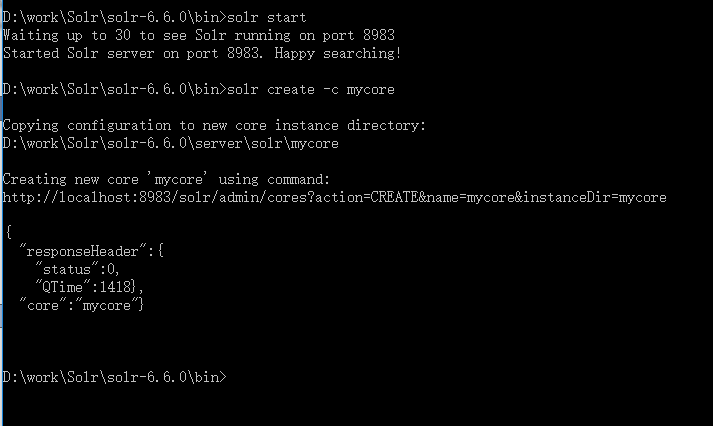
启动solr,创建mycore
solr start
solr create -c mycore
2、修改配置
2.1、创建data-config.xml文件
找到刚才创建的mycore文件夹,solr-6.6.0\server\solr\mycore,在下面的conf文件夹下建立data-config.xml文件,具体参见文件夹下solr-6.6.0\example\example-DIH\solr\tika\conf\tika-data-config.xml的内容:
<dataConfig>

  <dataSource type="BinFileDataSource"/>

  <document>

    <entity name="file" processor="FileListEntityProcessor" dataSource="null"

            baseDir="${solr.install.dir}/example/exampledocs" fileName=".*pdf"

            rootEntity="false">

      <field column="file" name="id"/>

      <entity name="pdf" processor="TikaEntityProcessor"

              url="${file.fileAbsolutePath}" format="text">

        <field column="Author" name="author" meta="true"/>

        <!-- in the original PDF, the Author meta-field name is upper-cased,

          but in Solr schema it is lower-cased

         -->

        <field column="title" name="title" meta="true"/>

        <field column="dc:format" name="format" meta="true"/>

        <field column="text" name="text"/>

      </entity>

    </entity>

  </document>

</dataConfig>
修改如下:
<dataConfig>

  <dataSource type="BinFileDataSource"/>

  <document>

    <entity name="file" processor="FileListEntityProcessor" dataSource="null"

            baseDir="D:/work/Solr/Import" fileName=".(doc)|(pdf)|(docx)|(txt)|(csv)|(json)|(xml)|(pptx)|(pptx)|(ppt)|(xls)|(xlsx)"

            rootEntity="false">

      <field column="file" name="id"/>

      <field column="fileSize" name="fileSize"/>

      <field column="fileLastModified" name="fileLastModified"/>

      <field column="fileLastModified" name="fileLastModified"/>

      <field column="fileAbsolutePath" name="fileAbsolutePath"/>

      <entity name="pdf" processor="TikaEntityProcessor"

              url="${file.fileAbsolutePath}" format="text">

        <field column="Author" name="author" meta="true"/>

        <!-- in the original PDF, the Author meta-field name is upper-cased,

          but in Solr schema it is lower-cased

         -->

        <field column="title" name="title" meta="true"/>

        <field column="text" name="text"/>

      </entity>

    </entity>

  </document>

</dataConfig>
fileName :(必选)使用正则表达式匹配文件
baseDir : (必选) 文件目录
recursive : 是否递归的获取文件,默认false
rootEntity :在这里必须是false(除非你只想索引文件名)。在默认情况下,document元素下就是根实体了,如果没有根实体的话,直接在实体下面的实体将会被看做跟实体。
对于根实体对应的数据库中返回的数据的每一行,solr都将生成一个document
dataSource :如果你是用solr1.3,那就必须设为"null",因为它没使用任何dataSourde。不需要在solr1.4中指定它,它只是意味着我们不创建一个dataSource实例。在大多数情况下,
只有一个DataSource(JdbcDataSource),当使用FileListEntityProcessor 的时候DataSource不是必须的
processor:只有当datasource不是RDBMS时才是必须的
onError :默认是"abort","skip"表示跳过当前文档,"continue"表示对错误视而不见
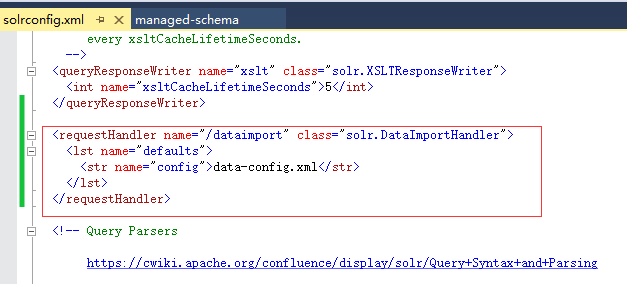
2.2、修改solrconfig.xml文件
增加如下内容:
 <requestHandler name="/dataimport" class="solr.DataImportHandler">

    <lst name="defaults">

      <str name="config">data-config.xml</str>

    </lst>

  </requestHandler>
2.3、修改managed-schema
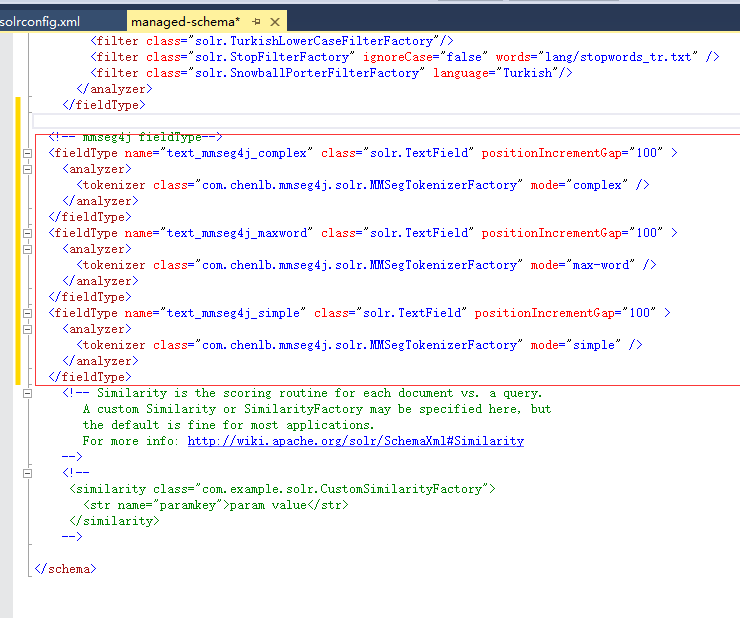
配置中文词库,具体参见:http://www.cnblogs.com/shaosks/p/7843218.html,增加如下内容:
<!-- mmseg4j fieldType-->

  <fieldType name="text_mmseg4j_complex" class="solr.TextField" positionIncrementGap="100" >

    <analyzer>

      <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="complex" />

    </analyzer>

  </fieldType>

  <fieldType name="text_mmseg4j_maxword" class="solr.TextField" positionIncrementGap="100" >

    <analyzer>

      <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="max-word" />

    </analyzer>

  </fieldType>

  <fieldType name="text_mmseg4j_simple" class="solr.TextField" positionIncrementGap="100" >

    <analyzer>

      <tokenizer class="com.chenlb.mmseg4j.solr.MMSegTokenizerFactory" mode="simple" />

    </analyzer>

  </fieldType>
增加以下三列,因为id列默认已经有了,不用创建,注意title和text两个字段的类型用了上面的text_mmseg4j_complex
 <field name="title" type="text_mmseg4j_complex" indexed="true" stored="true"/>

  <field name="text" type="text_mmseg4j_complex" indexed="true" stored="true" omitNorms ="true"/>

  <field name="author" type="string" indexed="true" stored="true"/>

  <field name="fileSize" type="long" indexed="true" stored="true"/>

  <field name="fileLastModified" type="date" indexed="true" stored="true"/>

  <field name="fileAbsolutePath" type="string" indexed="true" stored="true"/>
3、建立依赖的jar包
在mycore下面建立lib文件夹, 然后往lib目录copy一些 DIH依赖的jar包,这些包要么在solr-6.6.0\contrib\extraction\lib下面,要么在solr-6.6.0\dist下面,
样做的好处是每个core依赖的jar包都存放在各自core的子目录下分类存放,更方便管理,全部扔WEB-INF\lib下杂乱无章不好管理。如图:

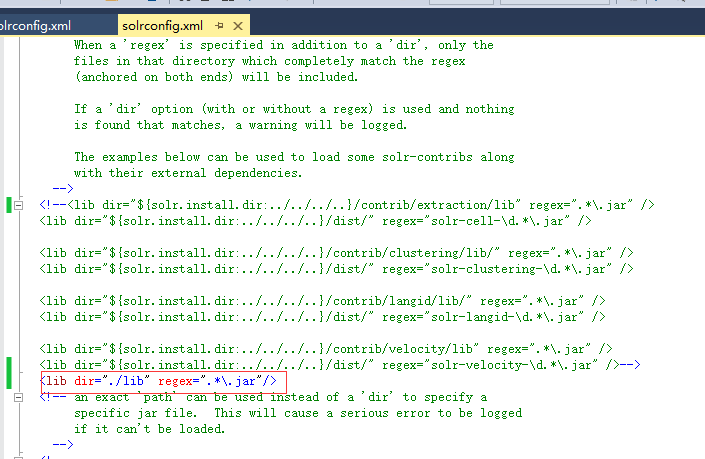
再修改solrconfig.xml文件
增加
<lib dir="./lib" regex=".*\.jar"/>
4、准备导入的pdf文件
在solr-6.6.0\bin的同级文件夹solr-6.6.0\ImportData下面有要导入的文件:

5、导入pdf
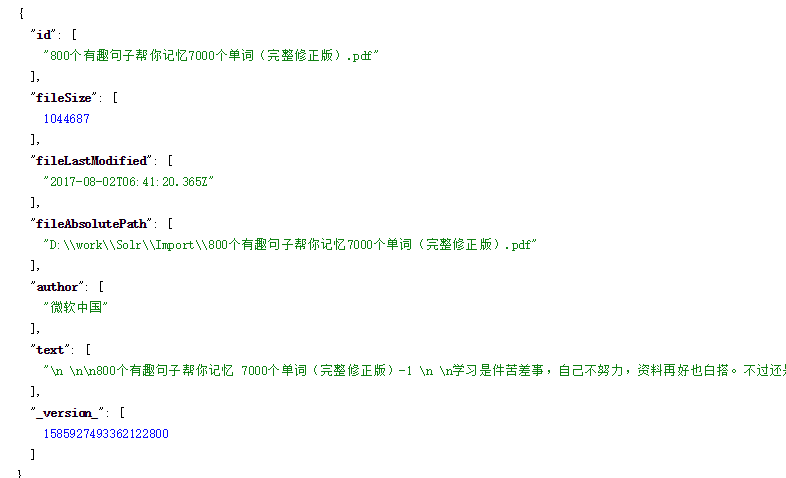
重启solr,打开浏览器,进入 solr导入界面导入pdf数据

6、查询数据
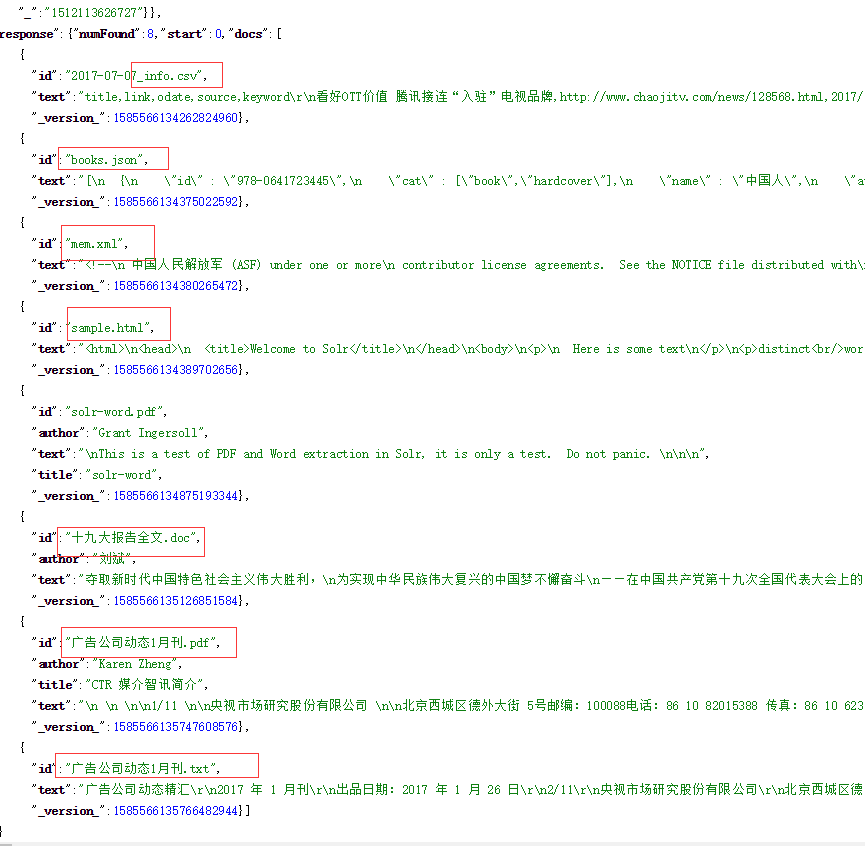
从索引结果可以看出,每种不同的文件,所有文件的主要内容都集中到text这一个字段中。索引这种索引方式适合doc,pdf,txt,html等这种非结构化文档,而对json、csv和json这种结构化文档就不合适了。
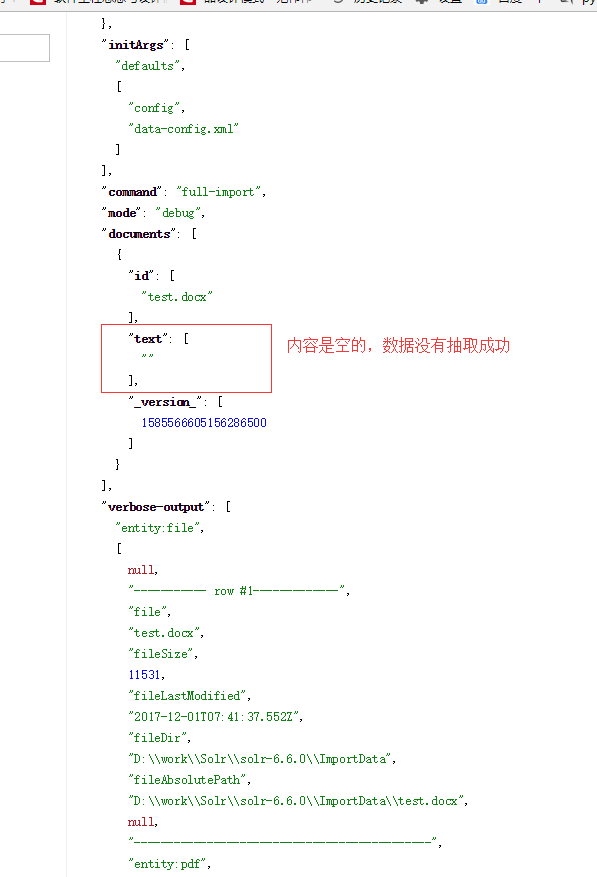
但是这种方式在索引docx格式的word文档发生问题,抽取不到数据,这个还不知道什么原因
solr6.6 导入 pdf/doc/txt/json/csv/xml文件的更多相关文章
- solr6.6 导入 文本(txt/json/xml/csv)文件
参照:solr6.6 导入 pdf文件 重点就是三个配置文件 1.建立的data-config.xml 内容如下: <dataConfig> <dataSource name=&qu ...
- Java JSON、XML文件/字符串与Bean对象互转解析
前言 在做web或者其他项目中,JSON与XML格式的数据是大家经常会碰见的2种.在与各种平台做数据对接的时候,JSON与XML格式也是基本的数据传递格式,本文主要简单的介绍JSON/XML ...
- 主流数据文件类型(.dat/.txt/.json/.csv)导入到python
手写很累,复制的同学请点赞犒劳下在下哦 ^_^ 一.对于.CSV类型的数据 它们的数据导入都很简单 且看下面一顿操作: 我平时一般是读取整个文件,直接这样就可以了: import pandas as ...
- Python常用的数据文件存储的4种格式(txt/json/csv/excel)及操作Excel相关的第三方库(xlrd/xlwt/pandas/openpyxl)(2021最新版)
序言:保存数据的方式各种各样,最简单的方式是直接保存为文本文件,如TXT.JSON.CSV等,除此之外Excel也是现在比较流行的存储格式,通过这篇文章你也将掌握通过一些第三方库(xlrd/xlwt/ ...
- 用php导入10W条+ 级别的csv大文件数据到mysql。导出10W+级别数据到csv文件
转自:http://blog.csdn.net/think2me/article/details/12999907 1. 说说csv 和 Excel 这两者都是我们平时导出或者导入数据一般用到的载体. ...
- jquery Ajax获取本地json 以及xml文件
$(function() { $("#Button1").click(function() { //按钮单击事件 //打开文件,并通过回调函数处理获取的数据 $.get(" ...
- 2018.10.5 hibernate导入约束,在Eclipse的xml文件实现自动提示
打开Java Resources/Libraries/hibernate-core-5.3.1.Final.jar/org.hibernate/hibernate-mapping-3.0.dtd(hi ...
- 浏览器 chrome 360等 加载本地json 或者xml 文件
添加启动参数 --allow-file-access-from-files 来自为知笔记(Wiz)
- 写文件的工具类,输出有格式的文件(txt、json/csv)
import java.io.BufferedWriter; import java.io.File; import java.io.FileOutputStream; import java.io. ...
随机推荐
- linux设备驱动中的并发控制【转】
转自:http://www.cnblogs.com/plinx/archive/2013/01/28/2873121.html 在linux内核中,主要的静态发生于以下几种情况: 1.对称多处理器(S ...
- PL/SQL 02 声明变量 declare
语法:identifier [CONSTANT] datatype [NOT NULL] [:= | DEFAULT expr] identifier:用于指定变量或常量的名称.CONSTANT:用于 ...
- Oracle基础 12 对象 objects 同义词/序列/试图/索引
--创建同义词create public synonym employees for hr.employees; --公共同义词需要 create public synonym 权限 表的所有用户授 ...
- jQuery获取标签中的元素
获取双标签之间的内容 在JavaScript中,获取双标签之间的内容是这样的: <!DOCTYPE html> <html lang="en"> <h ...
- Delphi - 字符串 详解
来自:http://www.cnblogs.com/huangjacky/archive/2009/12/10/1620950.html ------------------------------- ...
- 《Java编程思想》笔记 第九章 接口
1.抽象类和抽象方法 抽象方法,仅有方法声明没有方法体 abstract class AbstractClass{ abstract void f(); //没有 {} } 只要有一个或者多个抽象方法 ...
- 什么时候该用 Apache Kafka
rabbitMQ kafka https://coyee.com/article/12091-understanding-when-to-use-rabbitmq-or-apache-kafka Ap ...
- selenium 滚动条操作(JavaScript操作)
前言 一般我们想到的必须使用滚动条的场景是:注册时的法律条文的阅读.判断用户是否阅读完的标准是:滚动条是否拉到页面底部.当然,有时候为使操作更接近用户行为也会使用滚动条,例如用户要操作的元素在页面的第 ...
- 网关协议:CGI、FastCGI、WSGI
CGI就像是一座桥,把网页和WEB服务器中的执行程序连接起来,它把HTML接收的指令传递给服务器的执行程序,再把服务器执行程序的结果返还给HTML页. CGI CGI即通用网关接口(Common Ga ...
- 福州三中集训day1
第一天感觉很是不友好,好在我是学过搜索之后才听的课,不然估计得死在教室…. 某zld犇犇讲的很是强?今天主要是讲枚举和DFS,几道经典题目讲完,还没到下课时间, 然后讲起了float. 有空整理一下吧 ...