
Node.js 爬虫初探
前言
在学习慕课网视频和Cnode新手入门接触到爬虫,说是爬虫初探,其实并没有用到爬虫相关第三方类库,主要用了node.js基础模块http、网页分析工具cherrio。 使用http直接获取url路径对应网页资源,然后使用cherrio分析。 这里我主要是把慕课网教学视频提供的案例自己敲了一边,加深理解。在coding的过程中,我第一次把jq获取后的对象直接用forEach遍历,直接报错,是因为jq没有对应的这个方法,只有js数组可以调用。
知识点
①:superagent抓去网页工具。我暂时未用到。
②:cherrio 网页分析工具,你可以理解其为服务端的jQuery,因为语法都一样。
效果图
1、抓取整个网页
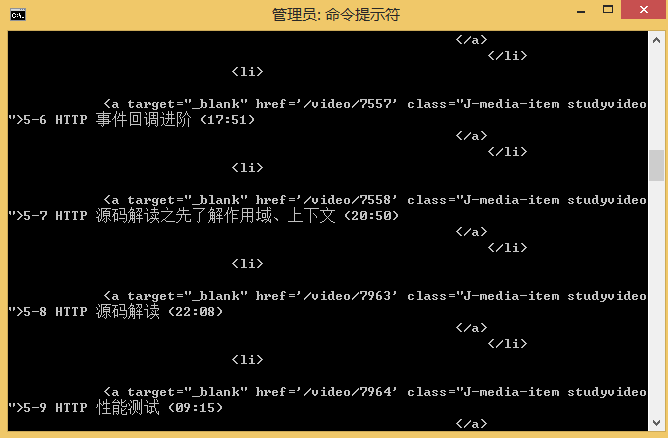
2、分析后的数据, 我这里是以慕课网提供的示例为案例实现的例子。
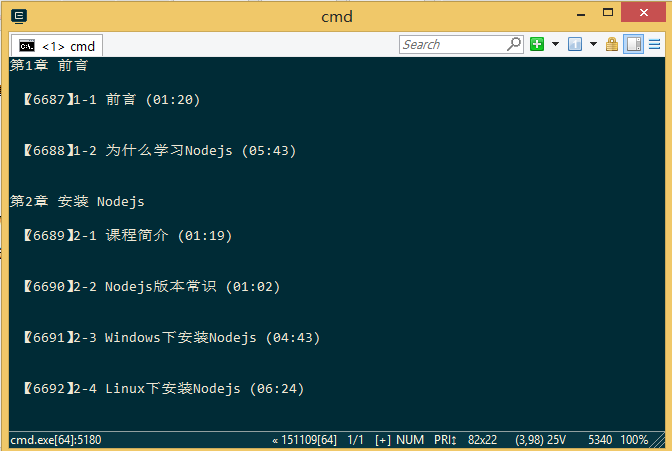
爬虫初探源码分析
var http=require('http');

var cheerio=require('cheerio');

var url='http://www.imooc.com/learn/348';

/****************************

打印得到的数据结构

[{

	chapterTitle:'',

	videos:[{

		title:'',

		id:''

	}]

}]

********************************/

function printCourseInfo(courseData){

	courseData.forEach(function(item){

		var chapterTitle=item.chapterTitle;

		console.log(chapterTitle+'\n');

		item.videos.forEach(function(video){

			console.log(' 【'+video.id+'】'+video.title+'\n');

		})

	});

}

/*************

分析从网页里抓取到的数据

**************/

function filterChapter(html){

	var courseData=[];

	var $=cheerio.load(html);

	var chapters=$('.chapter');

	chapters.each(function(item){

		var chapter=$(this);

		var chapterTitle=chapter.find('strong').text(); //找到章节标题

		var videos=chapter.find('.video').children('li');

		var chapterData={

			chapterTitle:chapterTitle,

			videos:[]

		};

		videos.each(function(item){

			var video=$(this).find('.studyvideo');

			var title=video.text();

			var id=video.attr('href').split('/video')[1];

			chapterData.videos.push({

				title:title,

				id:id

			})

		})

		courseData.push(chapterData);

	});

    return courseData;

}

http.get(url,function(res){

	var html='';

	res.on('data',function(data){

		html+=data;

	})

	res.on('end',function(){

		var courseData=filterChapter(html);

		printCourseInfo(courseData);

	})

}).on('error',function(){

	console.log('获取课程数据出错');

})
参考资料
https://github.com/alsotang/node-lessons/tree/master/lesson3
http://www.imooc.com/video/7965
Node.js 爬虫初探的更多相关文章
- Node.js爬虫-爬取慕课网课程信息
第一次学习Node.js爬虫,所以这时一个简单的爬虫,Node.js的好处就是可以并发的执行 这个爬虫主要就是获取慕课网的课程信息,并把获得的信息存储到一个文件中,其中要用到cheerio库,它可以让 ...
- node.js爬虫
这是一个简单的node.js爬虫项目,麻雀虽小五脏俱全. 本项目主要包含一下技术: 发送http抓取页面(http).分析页面(cheerio).中文乱码处理(bufferhelper).异步并发流程 ...
- Node.js aitaotu图片批量下载Node.js爬虫1.00版
即使是https网页,解析的方式也不是一致的,需要多试试. 代码: //====================================================== // aitaot ...
- Node.js umei图片批量下载Node.js爬虫1.00
这个爬虫在abaike爬虫的基础上改改图片路径和下一页路径就出来了,代码如下: //====================================================== // ...
- Node.js abaike图片批量下载Node.js爬虫1.01版
//====================================================== // abaike图片批量下载Node.js爬虫1.01 // 1.01 修正了输出目 ...
- Node.js abaike图片批量下载Node.js爬虫1.00版
这个与前作的差别在于地址的不规律性,需要找到下一页的地址再爬过去找. //====================================================== // abaik ...
- Node JS爬虫:爬取瀑布流网页高清图
原文链接:Node JS爬虫:爬取瀑布流网页高清图 静态为主的网页往往用get方法就能获取页面所有内容.动态网页即异步请求数据的网页则需要用浏览器加载完成后再进行抓取.本文介绍了如何连续爬取瀑布流网页 ...
- Node.js 爬虫爬取电影信息
Node.js 爬虫爬取电影信息 我的CSDN地址:https://blog.csdn.net/weixin_45580251/article/details/107669713 爬取的是1905电影 ...
- Node.js 爬虫,自动化抓取文章标题和正文
持续进行中... 目标: 动态User-Agent模拟浏览器 √ 支持Proxy设置,避免被服务器端拒绝 √ 支持多核模式,发挥多核CPU性能 √ 支持核内并发模式 √ 自动解码非英文站点,避免乱码出 ...
随机推荐
- Shell下突破安全狗远程桌面守护
首先在Shell下把安全狗的安装配置给下来 默认安装路径: C:\Program Files\SafedogServer\SafeDogGuardCenter 找到 ProGuardData.ini ...
- 有关JVM配置参数含义
1.参数的含义-vmargs -Xms128M -Xmx512M -XX:PermSize=64M -XX:MaxPermSize=128M-vmargs 说明后面是VM的参数,所以后面的其实都是JV ...
- VB.net 2010下关联与程序图标设置
'*************************************************************************'**模 块 名:VB.net 2010下关联与程序 ...
- Window.focus()让页面成为当前窗体
Window.focus()让页面成为当前窗体 最近在弄在线客服的时候,想在收到信息时候让窗体自动弹出到最前,最小化的时候也是弹出到最前.本来以为很麻烦,问了好多人,都不知道,在网上查资料也没有查到. ...
- CI-持续集成(1)-软件工业“流水线”概述
CI-持续集成(1)-软件工业“流水线”概述 1 概述 持续集成(Continuous integration)是一种软件开发实践,即团队开发成员经常集成它们的工作,通过每个成员每天至少集成一次, ...
- MySQL mysqldump数据导出详解
介绍 在日常维护工作当中经常会需要对数据进行导出操作,而mysqldump是导出数据过程中使用非常频繁的一个工具:它自带的功能参数非常多,文章中会列举出一些常用的操作,在文章末尾会将所有的参数详细说明 ...
- python实现grep
import sys import os import re def usage(): print "[Usage]: python grep.py filename grepString. ...
- Mac 软件篇
对于美好事务的追求无论何时都不算晚. ** 文章内容来着我整理的fetool,以下内容可能更新不及时 ** Mac 下的软件那么多,又是免费又是付费,应该怎么选呢?我来分享下我的推荐列表,推荐的优先级 ...
- Windows Azure Storage (22) Azure Storage如何支持多级目录
<Windows Azure Platform 系列文章目录> 熟悉Azure平台的读者都知道,Azure Blob有三层架构.如下图:(注意blob.core.chinacloudapi ...
- Hadoop 裡的 fsck 指令
Hadoop 裡的 fsck 指令,可檢查 HDFS 裡的檔案 (file),是否有 corrupt (毀損) 或資料遺失,並產生 HDFS 檔案系統的整體健康報告.報告內容,包括:Total blo ...