
node.js爬虫
这是一个简单的node.js爬虫项目,麻雀虽小五脏俱全。
本项目主要包含一下技术:
发送http抓取页面(http)、分析页面(cheerio)、中文乱码处理(bufferhelper)、异步并发流程控制(thenjs)
1、为什么选择http模块来发送Http请求下载页面
社区有很多封装好的Http请求模块,例如:request、needle、node-rest-client等,http有这些模块比拟不了的优势,可以监听抓取的字节流,我们知道要抓取的页面一般会含有汉字,一个汉字是3个字节(也有说4个字节),笔者在node中测试的是3个字节,一个英文字母是1个字节(见下图),node对中文的支持是不友好的,所以就需要借助bufferhelper来解决字节流问题,再使用 iconv-lite模块把buffer转化成utf8格式。

2、使用cheerio分析Html,让你感觉就像是在使用JQuery
3、虽说如今node上已经有异步控制的标准 async/await,但是thenjs,真的很好用,并且效率也不错,本项目主要用了它的异步并行控制 Then.each,了解更多thenjs介绍
4、本项目主要是抓取菜鸟教程的 HTML/CSS 下的8个页面,本项目先抓取 http://www.runoob.com 分析其Html,找到这8个页面的Url,再分别抓取这些页面的Html,写入到本地文件
代码 chong.js :
var http = require('http');

var Then = require('thenjs');

var BufferHelper = require('bufferhelper');

var fs = require('fs');

var cheerio = require('cheerio'); // Html分析模块

var iconv = require('iconv-lite'); // 字符转码模块

var pageUrl = []; //Url集合

var pagesHtml = []; //所有Url获取的Html的集合

var baseUrl = 'http://www.runoob.com';

main();

function main() {

    console.log('Start');

    Then(cont => {

        grabPageAsync(baseUrl, cont)

    }).then((cont, html) => {

        var $ = cheerio.load(html);

        var $html = $('.codelist.codelist-desktop.cate1');

        var $aArr = $html.find('a');

        $aArr.each((i, u) => {

            pageUrl.push('http:' + $(u).attr('href'));

        })

        everyPage(cont);

    }).fin((cont, error, result) => {

        console.log(error ? error : JSON.stringify(result));

        console.log('End');

    })

}

//爬去每个Url

function everyPage(callback) {

    Then.each(pageUrl, (cont, item) => {

        grabPageAsync(item, cont);

    }).then((cont, args) => {

        pagesHtml = args;

        createHtml(cont);

    }).fin((cont, error, result) => {

        callback(error, result);

    })

}

//创建Html文件

function createHtml(callback) {

    Then.each(pagesHtml, (cont, item, index) => {

        var name = pageUrl[index].substr(pageUrl[index].lastIndexOf('/') + 1);

        fs.writeFile(__dirname + '/grapHtml/' + name, item, function(err) {

            err ? console.error(err) : console.log('写入成功:' + name);

            cont(err, index);

        });

    }).fin((cont, error, result) => {

        callback(error, result);

    })

}

// 异步爬取页面HTML

function grabPageAsync(url, callback) {

    http.get(url, function(res) {

        var bufferHelper = new BufferHelper();

        res.on('data', function(chunk) {

            bufferHelper.concat(chunk);

        });

        res.on('end', function() {

            console.log('爬取 ' + url + ' 成功');

            var fullBuffer = bufferHelper.toBuffer();

            var utf8Buffer = iconv.decode(fullBuffer, 'UTF-8');

            var html = utf8Buffer.toString()

            callback(null, html);

        });

    }).on('error', function(e) {

        // 爬取成功

        callback(e, null);

        console.log('爬取 ' + url + ' 失败');

    });

}
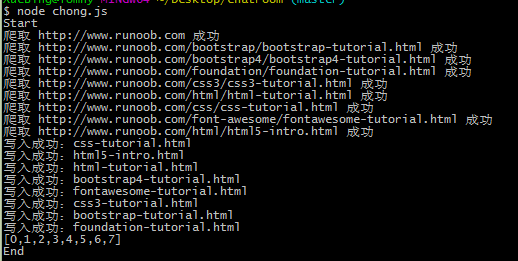
运行:
抓取的页面结果:
欢迎拍砖 :)
本文原创转载请注明出处!
node.js爬虫的更多相关文章
- Node.js爬虫-爬取慕课网课程信息
第一次学习Node.js爬虫,所以这时一个简单的爬虫,Node.js的好处就是可以并发的执行 这个爬虫主要就是获取慕课网的课程信息,并把获得的信息存储到一个文件中,其中要用到cheerio库,它可以让 ...
- Node.js aitaotu图片批量下载Node.js爬虫1.00版
即使是https网页,解析的方式也不是一致的,需要多试试. 代码: //====================================================== // aitaot ...
- Node.js umei图片批量下载Node.js爬虫1.00
这个爬虫在abaike爬虫的基础上改改图片路径和下一页路径就出来了,代码如下: //====================================================== // ...
- Node.js abaike图片批量下载Node.js爬虫1.01版
//====================================================== // abaike图片批量下载Node.js爬虫1.01 // 1.01 修正了输出目 ...
- Node.js abaike图片批量下载Node.js爬虫1.00版
这个与前作的差别在于地址的不规律性,需要找到下一页的地址再爬过去找. //====================================================== // abaik ...
- Node JS爬虫:爬取瀑布流网页高清图
原文链接:Node JS爬虫:爬取瀑布流网页高清图 静态为主的网页往往用get方法就能获取页面所有内容.动态网页即异步请求数据的网页则需要用浏览器加载完成后再进行抓取.本文介绍了如何连续爬取瀑布流网页 ...
- Node.js 爬虫爬取电影信息
Node.js 爬虫爬取电影信息 我的CSDN地址:https://blog.csdn.net/weixin_45580251/article/details/107669713 爬取的是1905电影 ...
- Node.js 爬虫初探
前言 在学习慕课网视频和Cnode新手入门接触到爬虫,说是爬虫初探,其实并没有用到爬虫相关第三方类库,主要用了node.js基础模块http.网页分析工具cherrio. 使用http直接获取url路 ...
- Node.js 爬虫,自动化抓取文章标题和正文
持续进行中... 目标: 动态User-Agent模拟浏览器 √ 支持Proxy设置,避免被服务器端拒绝 √ 支持多核模式,发挥多核CPU性能 √ 支持核内并发模式 √ 自动解码非英文站点,避免乱码出 ...
随机推荐
- JAVA提高十一:LinkedList深入分析
上一节,我们学习了ArrayList 类,本节我们来学习一下LinkedList,LinkedList相对ArrayList而言其使用频率并不是很高,因为其访问元素的性能相对于ArrayList而言比 ...
- Leetcode题解(32)
107. Binary Tree Level Order Traversal II 题目 直接代码: /** * Definition for a binary tree node. * struct ...
- gulp learning note
为啥写这一片文章呢? 主要是为了温故而知新和分享,也是为了更加促进自己的学习! 前端自动化工具很多 有grunt gulp webpack 等 这次主要分享下gulp的学习经验,让自己更好的总结 ...
- IE浏览器中用Firebug调试网站的方法
对于大部分做前端设计者而言应该都使用过Firefox浏览器下一款调试网站的扩展插件firebug吧,功能非常的强大,对于我们找出网页兼容性的问题非常的有效.不过对于很多不喜欢使用Firefox浏览器的 ...
- Java设计模式相关面试
1.接口是什么?为什么要使用接口而不是直接使用具体类? 接口用于定义 API.它定义了类必须得遵循的规则.同时,它提供了一种抽象,因为客户端只使用接口,这样可以有多重实现,如 List 接口,你可以使 ...
- 数据库连接(Oracle/sqlServer增、删、改、查)
一.把数据库包导入项目中,并且Build path(oracle例如ojdbc6.jar;sqlServer例如sqljdbc.jar) 二.开始操作 1.普通连接: String className ...
- TextView SpannableString 使用之实现可点击超链接效果
TextView SpannableString 使用之实现可点击超链接效果 如果看到这里说明你对 TextView 已经有了一定的了解,至少已经使用过该控件显示文字过.现在来实现一些复杂一点的效果. ...
- 在64位Win7环境+64位JDK下,运行64位Eclipse,提示“Failed to load the JNI shared library”错误,提示jvm.dll不对
-startup plugins/org.eclipse.equinox.launcher_1.2.0.v20110502.jar --launcher.library plugins/org.ecl ...
- javascript 的继承
我们的JavaScript比较特别了,主要通过原型链实现继承的. 下面介绍各种实现继承的方式:原型链继承,借用构造函数,组合继承,原型式继承,寄生式继承,寄生组合式继承. 二.实现继承方式 1.原型链 ...
- 给GridControl中的某列添加图片
要让GridControl的某列显示图片只需要数据源中有图片就可以正确显示 1.给DataSet添加一列,格式为image ds.Tables[].Columns.Add("SIGN&quo ...