
AdaBoost算法原理简介
AdaBoost算法原理
AdaBoost算法针对不同的训练集训练同一个基本分类器(弱分类器),然后把这些在不同训练集上得到的分类器集合起来,构成一个更强的最终的分类器(强分类器)。理论证明,只要每个弱分类器分类能力比随机猜测要好,当其个数趋向于无穷个数时,强分类器的错误率将趋向于零。AdaBoost算法中不同的训练集是通过调整每个样本对应的权重实现的。最开始的时候,每个样本对应的权重是相同的,在此样本分布下训练出一个基本分类器h1(x)。对于h1(x)错分的样本,则增加其对应样本的权重;而对于正确分类的样本,则降低其权重。这样可以使得错分的样本突出出来,并得到一个新的样本分布。同时,根据错分的情况赋予h1(x)一个权重,表示该基本分类器的重要程度,错分得越少权重越大。在新的样本分布下,再次对基本分类器进行训练,得到基本分类器h2(x)及其权重。依次类推,经过T次这样的循环,就得到了T个基本分类器,以及T个对应的权重。最后把这T个基本分类器按一定权重累加起来,就得到了最终所期望的强分类器。
AdaBoost算法的具体描述如下:
假定X表示样本空间,Y表示样本类别标识集合,假设是二值分类问题,这里限定Y={-1,+1}。令S={(Xi,yi)|i=1,2,…,m}为样本训练集,其中Xi∈X,yi∈Y。
① 始化m个样本的权值,假设样本分布Dt为均匀分布:Dt(i)=1/m,Dt(i)表示在第t轮迭代中赋给样本(xi,yi)的权值。
② 令T表示迭代的次数。
③ For t=1 to T do
根据样本分布Dt,通过对训练集S进行抽样(有回放)产生训练集St。
在训练集St上训练分类器ht。
用分类器ht对原训练集S中的所有样本分类。
得到本轮的分类器ht:X →Y,并且有误差εt=Pri-Di[ht(xi) ≠yi]。
令αt=(1/2)ln[(1-εt)/ εt]。
更新每个样本的权值,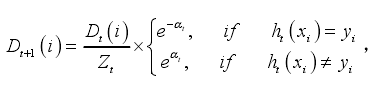
其中,Zt是一个正规因子,用来确保ΣiDt+1(i)=1。
end for
④ 最终的预测输出为: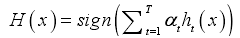
AdaBoost算法原理简介的更多相关文章
- 集成学习值Adaboost算法原理和代码小结(转载)
在集成学习原理小结中,我们讲到了集成学习按照个体学习器之间是否存在依赖关系可以分为两类: 第一个是个体学习器之间存在强依赖关系: 另一类是个体学习器之间不存在强依赖关系. 前者的代表算法就是提升(bo ...
- 集成学习之Adaboost算法原理
在boosting系列算法中,Adaboost是最著名的算法之一.Adaboost既可以用作分类,也可以用作回归. 1. boosting算法基本原理 集成学习原理中,boosting系列算法的思想:
- 集成学习之Adaboost算法原理小结
在集成学习原理小结中,我们讲到了集成学习按照个体学习器之间是否存在依赖关系可以分为两类,第一个是个体学习器之间存在强依赖关系,另一类是个体学习器之间不存在强依赖关系.前者的代表算法就是是boostin ...
- 机器学习之Adaboost算法原理
转自:http://www.cnblogs.com/pinard/p/6133937.html 在集成学习原理小结中,我们讲到了集成学习按照个体学习器之间是否存在依赖关系可以分为两类,第一个是个体学习 ...
- 基于单层决策树的AdaBoost算法原理+python实现
这里整理一下实验课实现的基于单层决策树的弱分类器的AdaBoost算法. 由于是初学,实验课在找资料的时候看到别人的代码中有太多英文的缩写,不容易看懂,而且还要同时看代码实现的细节.算法的原理什么的, ...
- AdaBoost 算法原理及推导
AdaBoost(Adaptive Boosting):自适应提升方法. 1.AdaBoost算法介绍 AdaBoost是Boosting方法中最优代表性的提升算法.该方法通过在每轮降低分对样例的权重 ...
- AdaBoost算法原理及OpenCV实例
备注:OpenCV版本 2.4.10 在数据的挖掘和分析中,最基本和首要的任务是对数据进行分类,解决这个问题的常用方法是机器学习技术.通过使用已知实例集合中所有样本的属性值作为机器学习算法的训练集,导 ...
- (数据科学学习手札13)K-medoids聚类算法原理简介&Python与R的实现
前几篇我们较为详细地介绍了K-means聚类法的实现方法和具体实战,这种方法虽然快速高效,是大规模数据聚类分析中首选的方法,但是它也有一些短板,比如在数据集中有脏数据时,由于其对每一个类的准则函数为平 ...
- AdaBoost 算法-分析波士顿房价数据集
公号:码农充电站pro 主页:https://codeshellme.github.io 在机器学习算法中,有一种算法叫做集成算法,AdaBoost 算法是集成算法的一种.我们先来看下什么是集成算法. ...
随机推荐
- 用python计算100以内的素数
用python计算100以内的素数 : break else: list.append(i)print(list)
- C语言常见的函数调用
C语言常见的函数调用 isatty,函数名,主要功能是检查设备类型,判断文件描述词是否为终端机. 函数名: isatty 用 法: int isatty(int desc); 返回值:如果参数desc ...
- ubuntu14.04 software-center can not open
sudo apt-get update sudo apt-get dist-upgrade sudo apt-get install --reinstall software-center
- 84. Spring Boot集成MongoDB【从零开始学Spring Boot】
至于MongoDB网上有很多相关的资料,所以在这里不进行过多的介绍,我们在这里主要是介绍下如何将mongodb与spring boot结合使用.本节大纲: (1) 准备工作: (2) 新建一个mave ...
- iOS中的过滤器和正则表达式(NSPredicate,NSRegularExpression)
参考链接:http://www.cocoachina.com/industry/20140321/8024.html NSPredicate Cocoa提供了一个NSPredicate类,它用来指定过 ...
- [BZOJ1583] [Usaco2009 Mar]Moon Mooing 哞哞叫(队列)
传送门 思想有点像蚯蚓那个题 #include <cstdio> #define N 4000001 #define LL long long #define min(x, y) ((x) ...
- 刷题总结——保留道路(ssoj)
题目: 题目背景 161114-练习-DAY1-AHSDFZ T3 题目描述 很久很久以前有一个国家,这个国家有 N 个城市,城市由 1,2,3,…,,N 标号,城市间有 M 条双向道路,每条道路都有 ...
- Split The Tree
Split The Tree 时间限制: 1 Sec 内存限制: 128 MB 题目描述 You are given a tree with n vertices, numbered from 1 ...
- 表单禁用复制、粘贴、及右击菜单(contextmenu、oncopy、oncut、onpaste、onselectstart)
禁用右键菜单,可以使用oncontextmenu属性: <textarea oncontextmenu="return false"></textarea> ...
- mysql报错Packet for query is too large (12238 > 1024). You can change this value
今天将项目部署到linux服务器的时候莫名其妙的报一些错误,可是在本地啥错没有,通过实时查看tomcat 的日志之后发现报错是: 实时查看日志: .先切换到:cd usr/local/tomcat5/ ...