
Python3爬虫实例 代理的使用
现在爬虫越来越难了,一些网站会有相应的反爬虫措施,例如很多网站会检测某一段时间某个IP的访问次数,如果访问频率太快以至于看起来不像正常访客,它可能就会会禁止这个IP的访问。
所以我们需要设置一些代理服务器,每隔一段时间换一个代理,就算IP被禁止,依然可以换个IP继续爬取。
网上有很多网站提供免费代理,但是经过测试基本都不可用,所以就付费买代理IP吧。目前市面有飞蚁代理,代理云,西瓜代理等。下面就介绍一下飞蚁代理使用情况。
1、首先注册一个用户,注册过程会送50元,可以下单测试。
2、下单如下:
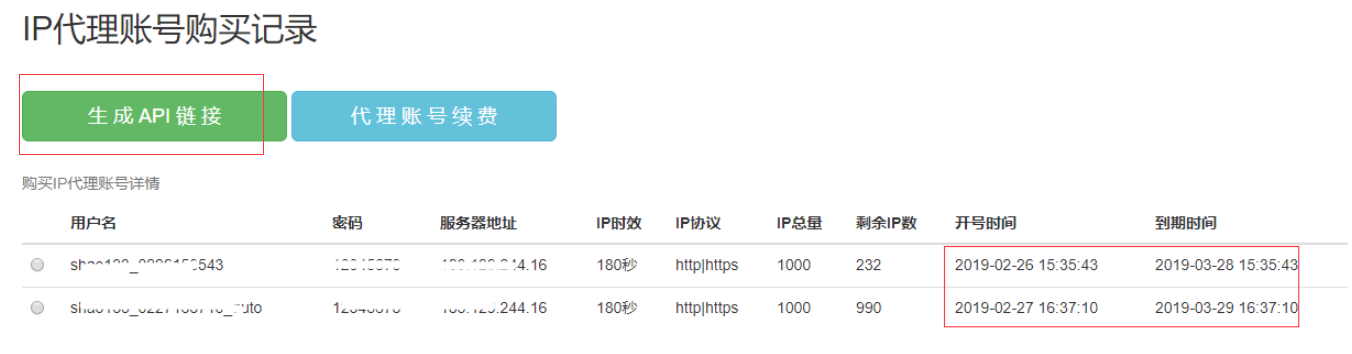
这个测试期间有个效期,过期失效,据客服讲,正式的期限都比较长,直到用完为止,
3、生成API链接
4、测试代码
获取代理
#获取代理IP
def getProxyIPs(self,num=1):
'''
获取代理IP
:param num: 获取的代理IP的个数
:return:
'''
proxy_ip=''
try:
url = 'http://183.129.244.16:88/open?user_name=sk133_0226153543×tamp=1551166598&' \
'md5=0ADAF27E30AFD0DD52D7B44F3A5C145F&pattern=json&number=%d' % num response = request.urlopen(url)
page = response.read()
txt = str(page.decode('utf-8'))
dataDict = json.loads(txt)
print(dataDict)
ports = dataDict.get('port')
# domain = dataDict.get('domain')
for port in ports:
proxy_ip = {'http': "http://" + self.proxy_server + ':' + str(port),
'https': 'https://' + self.proxy_server + ':' + str(port), }
except Exception as ex:
print(ex) return proxy_ip
利用获取代理抓取数据
    def testproxy(self,url, proxy_IP):

        try:

            cookie1 = random.choice(self.mycookies)

            UserAgent = random.choice(self.user_agent_list)

            header = {'User-Agent': UserAgent}

            # proxies=proxy_IP ,

            txt = requests.get(url,proxies=proxy_IP ,cookies=cookie1, headers=header).text

            print(txt)

        except Exception as ex:

            print(ex)
另外为chrome设置代理IP,以Chrome浏览器为例
     chrome_options = Options()

        chrome_options.add_argument('--headless')

        chrome_options.add_argument('--disable-gpu')

        proxy = '181.121.214.16:14140'

        chrome_options.add_argument('--proxy-server=' + proxy)

        driver = webdriver.Chrome(chrome_options=chrome_options)
selenium 模块时,以phantomJS浏览器为例:
 driver = webdriver.PhantomJS(service_args = [

            '--proxy=183.129.244.16:11310',

            '--proxy-type=http',

            '--load-images=false'

        ])
Python3爬虫实例 代理的使用的更多相关文章
- python3.4学习笔记(十三) 网络爬虫实例代码,使用pyspider抓取多牛投资吧里面的文章信息,抓取政府网新闻内容
python3.4学习笔记(十三) 网络爬虫实例代码,使用pyspider抓取多牛投资吧里面的文章信息PySpider:一个国人编写的强大的网络爬虫系统并带有强大的WebUI,采用Python语言编写 ...
- python3.4学习笔记(十四) 网络爬虫实例代码,抓取新浪爱彩双色球开奖数据实例
python3.4学习笔记(十四) 网络爬虫实例代码,抓取新浪爱彩双色球开奖数据实例 新浪爱彩双色球开奖数据URL:http://zst.aicai.com/ssq/openInfo/ 最终输出结果格 ...
- python3爬虫系列19之反爬随机 User-Agent 和 ip代理池的使用
站长资讯平台:python3爬虫系列19之随机User-Agent 和ip代理池的使用我们前面几篇讲了爬虫增速多进程,进程池的用法之类的,爬虫速度加快呢,也会带来一些坏事. 1. 前言比如随着我们爬虫 ...
- Python 爬虫的代理 IP 设置方法汇总
本文转载自:Python 爬虫的代理 IP 设置方法汇总 https://www.makcyun.top/web_scraping_withpython15.html 需要学习的地方:如何在爬虫中使用 ...
- Python3 爬虫之 Scrapy 核心功能实现(二)
博客地址:http://www.moonxy.com 基于 Python 3.6.2 的 Scrapy 爬虫框架使用,Scrapy 的搭建过程请参照本人的另一篇博客:Python3 爬虫之 Scrap ...
- Python 爬虫实例
下面是我写的一个简单爬虫实例 1.定义函数读取html网页的源代码 2.从源代码通过正则表达式挑选出自己需要获取的内容 3.序列中的htm依次写到d盘 #!/usr/bin/python import ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
随机推荐
- 删除Docker中所有已停止的容器
方法一: #显示所有的容器,过滤出Exited状态的容器,取出这些容器的ID, sudo docker ps -a|grep Exited|awk '{print $1}' #查询所有的容器,过滤出E ...
- Spring-1-(简介及HelloWord)
一:Spring简介 Spring 框架宗旨:不重新发明技术,让原有技术使用起来更加方便. Spring核心功能: 1.AOP:面向切面编程 2.Ioc/Di:控制反转/依赖注入 3.声明式事务 Sp ...
- servlet生命周期和工作原理
http://www.cnblogs.com/cuiliang/archive/2011/10/21/2220671.html
- scrapy meta不用pipe用命令-o
1. spider代码: # -*- coding: utf-8 -*- import scrapy from tencent1.items import Tencent1Item import js ...
- Flume的四个使用案例
一.Flume监听端口 1,在linux机器上下载telnet工具 yum search telnet yumm install telnet.x86_64 2.编写flume的配置文件,并将文件复制 ...
- hive中的分桶表
桶表也是一种用于优化查询而设计的表类型.创建通表时,指定桶的个数.分桶的依据字段,hive就可以自动将数据分桶存储.查询时只需要遍历一个桶里的数据,或者遍历部分桶,这样就提高了查询效率 ------创 ...
- RBM:深度学习之Restricted Boltzmann Machine的BRBM学习+LR分类—Jason niu
from __future__ import print_function print(__doc__) import numpy as np import matplotlib.pyplot as ...
- 问题 C: Frosh Week(2018组队训练赛第十五场)(签到)
问题 C: Frosh Week 时间限制: 4 Sec 内存限制: 128 MB提交: 145 解决: 63[提交][状态][讨论版][命题人:admin] 题目描述 Professor Zac ...
- 依赖配置中心实现注有@ConfigurationProperties的bean相关属性刷新
配置中心是什么 配置中心,通过key=value的形式存储环境变量.配置中心的属性做了修改,项目中可以通过配置中心的依赖(sdk)立即感知到.需要做的就是如何在属性发生变化时,改变带有@Configu ...
- NIO缓冲区基本操作:rewind(),clear(),flip()
rewind() rewind()方法将position置0,清除mark,它的作用在于为提取Buffer的有效数据做准备. ByteBuffer byteBuf = ByteBuffer.alloc ...