
Storm 集群的搭建及其Java编程进行简单统计计算
一、Storm集群构建
编写storm 与 zookeeper的yml文件
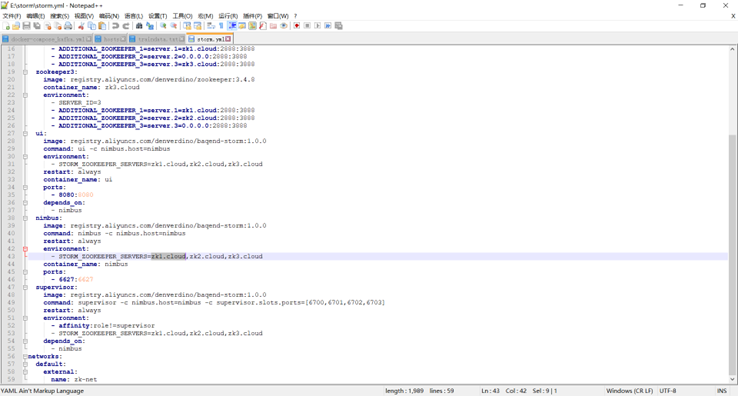
storm yml文件的编写
具体如下:
version: '2'

services:

  zookeeper1:

    image: registry.aliyuncs.com/denverdino/zookeeper:3.4.8

    container_name: zk1.cloud

    environment:

      - SERVER_ID=1

      - ADDITIONAL_ZOOKEEPER_1=server.1=0.0.0.0:2888:3888

      - ADDITIONAL_ZOOKEEPER_2=server.2=zk2.cloud:2888:3888

      - ADDITIONAL_ZOOKEEPER_3=server.3=zk3.cloud:2888:3888

  zookeeper2:

    image: registry.aliyuncs.com/denverdino/zookeeper:3.4.8

    container_name: zk2.cloud

    environment:

      - SERVER_ID=2

      - ADDITIONAL_ZOOKEEPER_1=server.1=zk1.cloud:2888:3888

      - ADDITIONAL_ZOOKEEPER_2=server.2=0.0.0.0:2888:3888

      - ADDITIONAL_ZOOKEEPER_3=server.3=zk3.cloud:2888:3888

  zookeeper3:

    image: registry.aliyuncs.com/denverdino/zookeeper:3.4.8

    container_name: zk3.cloud

    environment:

      - SERVER_ID=3

      - ADDITIONAL_ZOOKEEPER_1=server.1=zk1.cloud:2888:3888

      - ADDITIONAL_ZOOKEEPER_2=server.2=zk2.cloud:2888:3888

      - ADDITIONAL_ZOOKEEPER_3=server.3=0.0.0.0:2888:3888

  ui:

    image: registry.aliyuncs.com/denverdino/baqend-storm:1.0.0

    command: ui -c nimbus.host=nimbus

    environment:

      - STORM_ZOOKEEPER_SERVERS=zk1.cloud,zk2.cloud,zk3.cloud

    restart: always

    container_name: ui

    ports:

      - 8080:8080

    depends_on:

      - nimbus

  nimbus:

    image: registry.aliyuncs.com/denverdino/baqend-storm:1.0.0

    command: nimbus -c nimbus.host=nimbus

    restart: always

    environment:

      - STORM_ZOOKEEPER_SERVERS=zk1.cloud,zk2.cloud,zk3.cloud

    container_name: nimbus

    ports:

      - 6627:6627

  supervisor:

    image: registry.aliyuncs.com/denverdino/baqend-storm:1.0.0

    command: supervisor -c nimbus.host=nimbus -c supervisor.slots.ports=[6700,6701,6702,6703]

    restart: always

    environment:

      - affinity:role!=supervisor

      - STORM_ZOOKEEPER_SERVERS=zk1.cloud,zk2.cloud,zk3.cloud

    depends_on:

      - nimbus

networks:

  default:

    external:

      name: zk-net
拉取Storm搭建需要的镜像,这里我选择镜像版本为 zookeeper:3.4.8 storm:1.0.0
键入命令:
docker pull zookeeper:3.4.8 docker pull storm:1.0.0
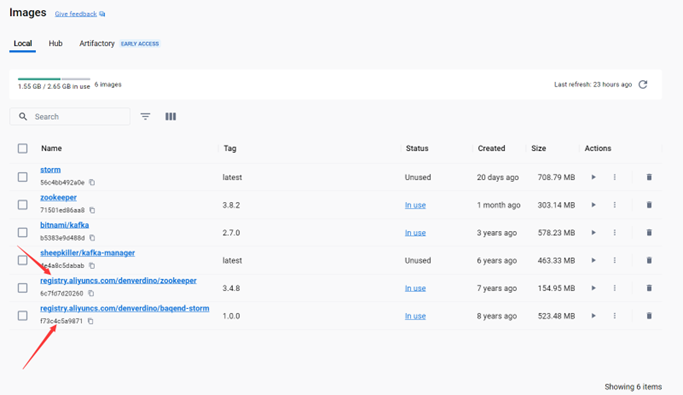
storm镜像 获取
使用docker-compose 构建集群
在power shell中执行以下命令:
docker-compose -f storm.yml up -d
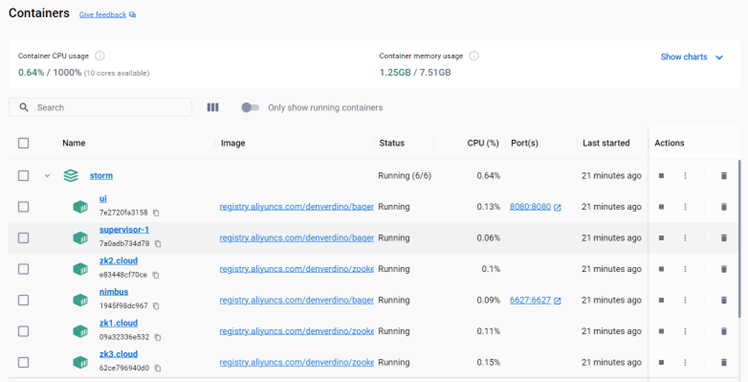
docker-compose 构建集群
在浏览器中打开localhost:8080 可以看到storm集群的详细情况
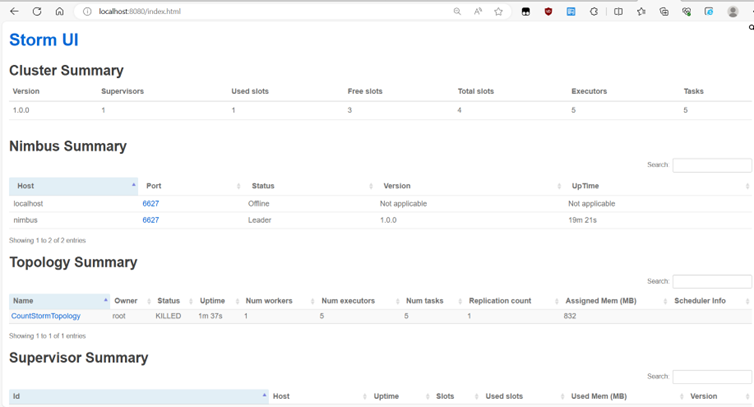
storm UI 展示
二、Storm统计任务
统计股票交易情况交易量和交易总金额 (数据文件存储在csv文件中)
编写DataSourceSpout类
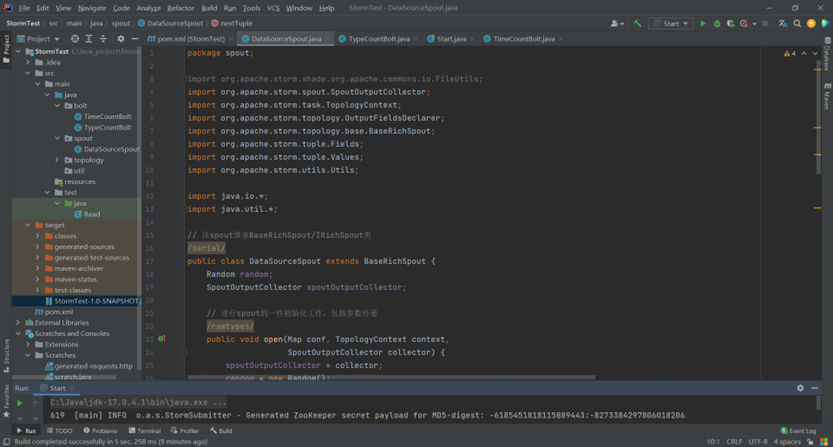
DataSourceSpout类
编写bolt类
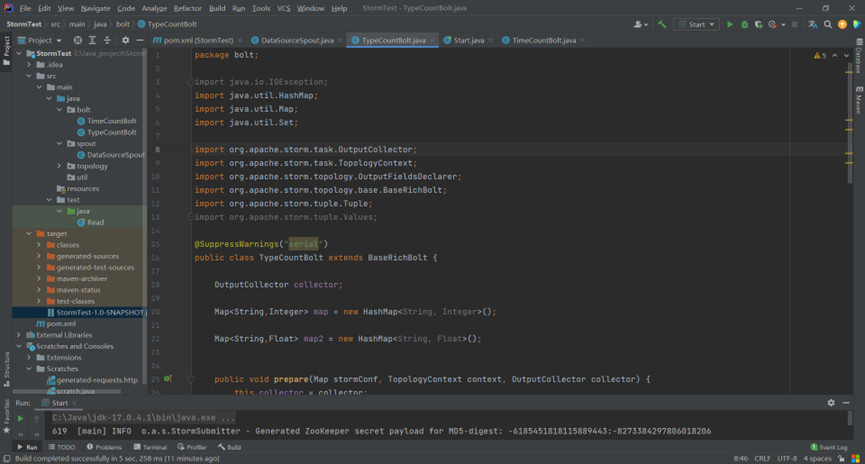
编写topology类
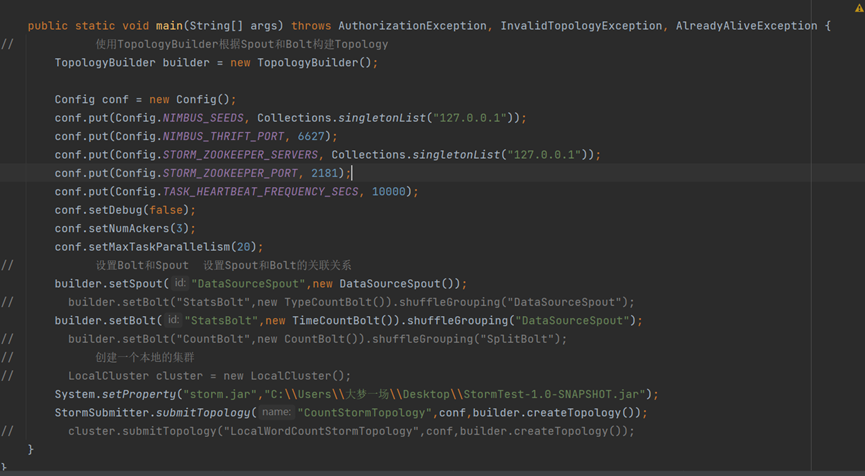
需要注意的是 Storm Java API 下有本地模型和远端模式
在本地模式下的调试不依赖于集群环境,可以进行简单的调试
如果需要使用生产模式,则需要将
1、 编写和自身业务相关的spout和bolt类,并将其打包成一个jar包
2、将上述的jar包放到客户端代码能读到的任何位置,
3、使用如下方式定义一个拓扑(Topology)
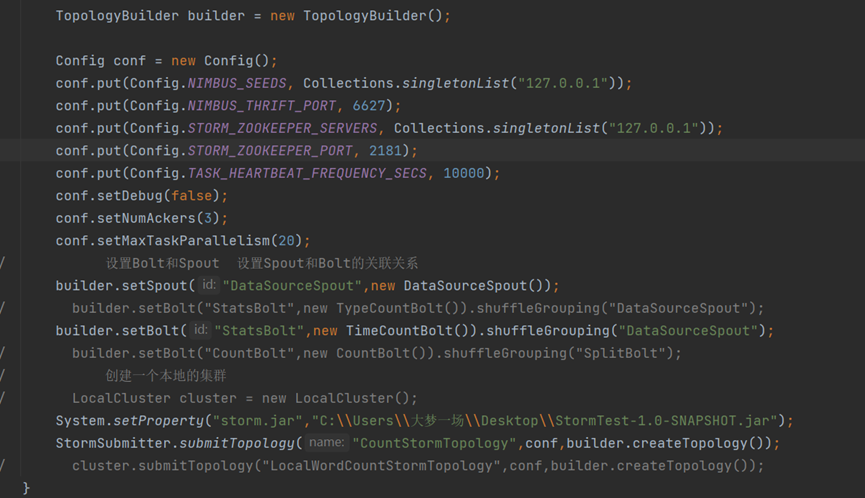
演示结果:
本地模式下的调试:
正在执行:
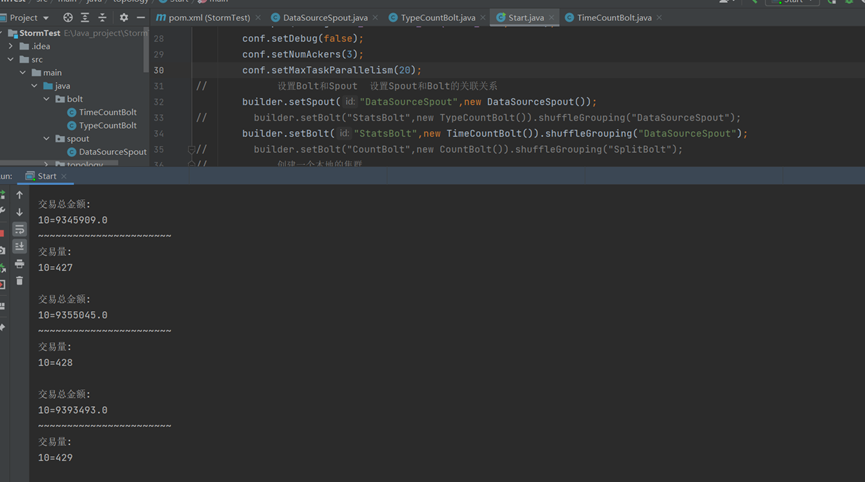
根据24小时
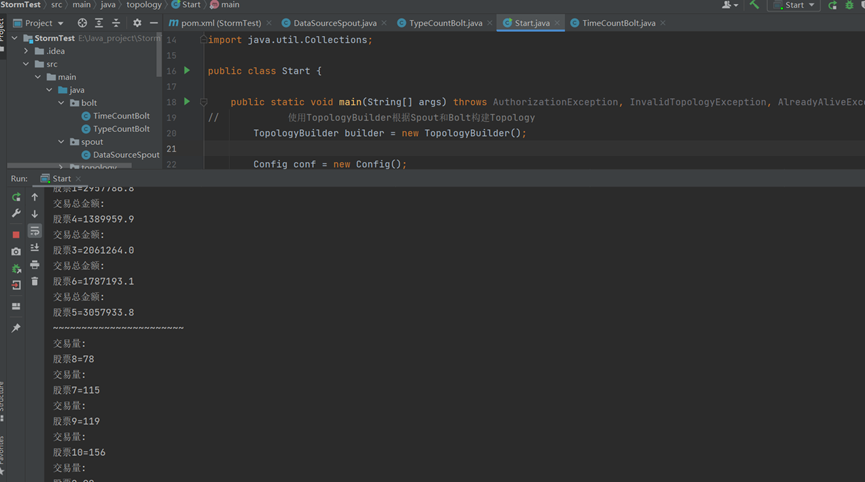
根据股票种类
生产模式:

向集群提交topology
三、核心计算bolt的代码
1.统计不同类型的股票交易量和交易总金额:
package bolt;

import java.io.IOException;

import java.util.HashMap;

import java.util.Map;

import java.util.Set;

import org.apache.storm.task.OutputCollector;

import org.apache.storm.task.TopologyContext;

import org.apache.storm.topology.OutputFieldsDeclarer;

import org.apache.storm.topology.base.BaseRichBolt;

import org.apache.storm.tuple.Tuple;

import org.apache.storm.tuple.Values;

@SuppressWarnings("serial")

public class TypeCountBolt extends BaseRichBolt {

    OutputCollector collector;

    Map<String,Integer> map = new HashMap<String, Integer>();

    Map<String,Float> map2 = new HashMap<String, Float>();

    public void prepare(Map stormConf, TopologyContext context, OutputCollector collector) {

        this.collector = collector;

    }

    public void execute(Tuple input) {

        String line = input.getStringByField("line");

        String[] data = line.split(",");

        Integer count = map.get(data[2]);

        Float total_amount = map2.get(data[2]);

        if(count==null){

            count = 0;

        }

        if(total_amount==null){

            total_amount = 0.0f;

        }

        count++;

        total_amount+=Float.parseFloat(data[3]) * Integer.parseInt(data[4]);

        map.put(data[2],count);

        map2.put(data[2],total_amount);

        System.out.println("~~~~~~~~~~~~~~~~~~~~~~~");

        Set<Map.Entry<String,Integer>> entrySet = map.entrySet();

        for(Map.Entry<String,Integer> entry :entrySet){

            System.out.println("交易量:");

            System.out.println(entry);

        }

        System.out.println();

        Set<Map.Entry<String,Float>> entrySet2 = map2.entrySet();

        for(Map.Entry<String,Float> entry :entrySet2){

            System.out.println("交易总金额:");

            System.out.println(entry);

        }

    }

    public void declareOutputFields(OutputFieldsDeclarer declarer) {

    }

}
2. 统计不同每个小时的交易量和交易总金额
package bolt;

import org.apache.storm.task.OutputCollector;

import org.apache.storm.task.TopologyContext;

import org.apache.storm.topology.OutputFieldsDeclarer;

import org.apache.storm.topology.base.BaseRichBolt;

import org.apache.storm.tuple.Tuple;

import java.text.ParseException;

import java.text.SimpleDateFormat;

import java.util.Date;

import java.util.HashMap;

import java.util.Map;

import java.util.Set;

public  class TimeCountBolt extends BaseRichBolt {

    OutputCollector collector;

    Map<Integer,Integer> map = new HashMap<Integer, Integer>();

    Map<Integer,Float> map2 = new HashMap<Integer, Float>();

    public void prepare(Map stormConf, TopologyContext context, OutputCollector collector) {

        this.collector = collector;

    }

    public void execute(Tuple input) {

        String line = input.getStringByField("line");

        String[] data = line.split(",");

        Date date = new Date();

        SimpleDateFormat dateFormat= new SimpleDateFormat("yyyy-MM-dd hh:mm:ss");

        try {

            date = dateFormat.parse(data[0]);

        } catch (ParseException e) {

            e.printStackTrace();

        }

        Integer count = map.get(date.getHours());

        Float total_amount = map2.get(date.getHours());

        if(count==null){

            count = 0;

        }

        if(total_amount==null){

            total_amount = 0.0f;

        }

        count++;

        total_amount+=Float.parseFloat(data[3]) * Integer.parseInt(data[4]);

        map.put(date.getHours(),count);

        map2.put(date.getHours(),total_amount);

        System.out.println("~~~~~~~~~~~~~~~~~~~~~~~");

        Set<Map.Entry<Integer,Integer>> entrySet = map.entrySet();

        for(Map.Entry<Integer,Integer> entry :entrySet){

            System.out.println("交易量:");

            System.out.println(entry);

        }

        System.out.println();

        Set<Map.Entry<Integer,Float>> entrySet2 = map2.entrySet();

        for(Map.Entry<Integer,Float> entry :entrySet2){

            System.out.println("交易总金额:");

            System.out.println(entry);

        }

    }

    public void declareOutputFields(OutputFieldsDeclarer declarer) {

    }

}
Storm 集群的搭建及其Java编程进行简单统计计算的更多相关文章
- 【Hadoop离线基础总结】zookeeper的介绍以及集群环境搭建、网络编程和RPC的简单了解
ZooKeeper的介绍以及集群环境搭建.网络编程和RPC的简单了解 ZooKeeper介绍 概述 ZooKeeper是一个分布式协调服务的开源框架,主要用来解决分布式集群中应用系统的一致性问题.例如 ...
- 一:Storm集群环境搭建
第一:storm集群环境准备及部署[1]硬件环境准备--->机器数量>=3--->网卡>=1--->内存:尽可能大--->硬盘:无额外需求[2]软件环境准备---& ...
- 大数据处理框架之Strom:Storm集群环境搭建
搭建环境 Red Hat Enterprise Linux Server release 7.3 (Maipo) zookeeper-3.4.11 jdk1.7.0_80 Pyth ...
- Storm —— 集群环境搭建
一.集群规划 这里搭建一个3节点的Storm集群:三台主机上均部署Supervisor和LogViewer服务.同时为了保证高可用,除了在hadoop001上部署主Nimbus服务外,还在hadoop ...
- Storm 学习之路(四)—— Storm集群环境搭建
一.集群规划 这里搭建一个3节点的Storm集群:三台主机上均部署Supervisor和LogViewer服务.同时为了保证高可用,除了在hadoop001上部署主Nimbus服务外,还在hadoop ...
- Storm 系列(四)—— Storm 集群环境搭建
一.集群规划 这里搭建一个 3 节点的 Storm 集群:三台主机上均部署 Supervisor 和 LogViewer 服务.同时为了保证高可用,除了在 hadoop001 上部署主 Nimbus ...
- storm集群环境搭建
1.环境 Java环境 卸载虚机环境中自带的openJdk,安装sun的jdk,配置环境变量 2.安装storm 下载storm安装包 解压到安装目录,配置环境变量 vi /etc/profile # ...
- storm集群快速搭建
sudo mkdir /export/serverssudo chmod -R 777 /exportmkdir /export/servers tar -zxvf apache-storm-1.0. ...
- Storm集群的搭建
storm的环境和hadoop的环境没有任何关系 1.安装Zookeeper集群 2.解压storm 3.修改文件conf/storm.yaml 3.1.配置zookeeper服务器 storm.zo ...
- centos7:storm集群环境搭建
1.安装storm 下载storm安装包 在线下载 wget http://apache.fayea.com/storm/apache-storm-1.1.1/apache-storm-1.1.1.t ...
随机推荐
- C#希尔排序算法
前言 希尔排序简单的来说就是一种改进的插入排序算法,它通过将待排序的元素分成若干个子序列,然后对每个子序列进行插入排序,最终逐步缩小子序列的间隔,直到整个序列变得有序.希尔排序的主要思想是通过插入排序 ...
- mysql触发器使用教程-六种触发器
参考:https://zhuanlan.zhihu.com/p/439273702 触发器(Trigger)是 MySQL 中非常实用的一个功能,它可以在操作者对表进行「增删改」 之前(或之后)被触发 ...
- 搭一下 Stable Diffusion WebUI
Preface 前不久看到好多朋友用上Stable Diffusion来做原画,然后又配合上了Chatgpt. 一直以来都想尝试一下,奈何2014款的双核mac跑个idea都发出了拖拉机的轰鸣声. 所 ...
- Text2Cypher:大语言模型驱动的图查询生成
话接上文<图技术在 LLM 下的应用:知识图谱驱动的大语言模型 Llama Index> 同大家简单介绍过 LLM 和图.知识图谱相关的结合,现在我来和大家分享下最新的成果.毕竟,从 GP ...
- 关于.Net 6.0 在Linux ,Docker容器中,不安装任何依赖就生成图形验证码!!!!!!!!!!!
在.Net Framework时代,我们生成验证码大多都是用System.Drawing. 在.Net 6中使用也是没有问题的. 但是,System.Drawing却依赖于Windows GDI+. ...
- What is Lambda?
根据我的观察,Lambda是一种比较灵活的形式,需要多看几个案例才能明白它. Lambda是一种简化代码的技术手段,主要用于简化匿名实现类,允许把函数作为一个方法的参数传递进方法中.它本身并不会创造出 ...
- c语言代码练习6
//输入三个数字,依次按照从大到小输出#define _CRT_SECURE_NO_WARNINGS 1 #include <stdio.h> int main() { int a = 0 ...
- WEBGpu最佳实践之BindGroup
介绍 在WebGPU中,资源通过GPUBindGroup结构传递给着色器,与支持它的布局定义(GPUBindGroupLayout和GPUPipelineLayout)以及着色器中绑定组的声明一起.这 ...
- 使用 GitHub Action 自动更新 Sealos 集群的应用镜像
在 IT 领域,自动化无疑已成为提高工作效率和减少人为错误的关键.Sealos 作为一个强大的云操作系统,已经为许多企业和开发者提供了稳定可靠的服务.与此同时,随着技术不断发展,集成更多的功能和服务变 ...
- Python:利用math和random模块实现RSA加密算法
实验五报告: 利用math和random模块实现RSA加密算法 实验目标 本实验的主要目标是熟悉RSA(Rivest-Shamir-Adleman)密码算法的编写,其中包括求最大公因子.模逆的扩展欧几 ...