
大数据处理框架之Strom:Storm集群环境搭建
搭建环境
Red Hat Enterprise Linux Server release 7.3 (Maipo)
zookeeper-3.4.11
jdk1.7.0_80
Python 2.7.5 (https://www.cnblogs.com/kimyeee/p/7250560.html)
集群方案
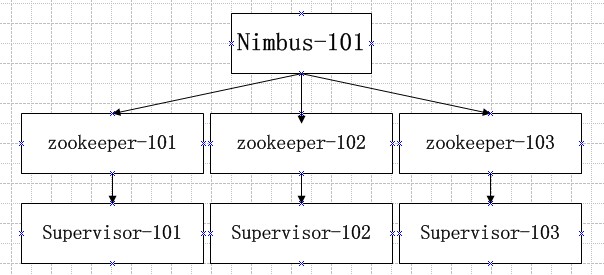
机器:101 102 103
安装步骤
安装依赖jdk和python
[cluster@PCS101 ~]$ java -version

java version "1.7.0_80"

Java(TM) SE Runtime Environment (build 1.7.0_80-b15)

Java HotSpot(TM) -Bit Server VM (build 24.80-b11, mixed mode)

[cluster@PCS101 ~]$ python -V

Python 2.7.
1.解压storm
[cluster@PCS101 tars]$ tar -zxvf apache-storm-0.9.-incubating.tar.gz -C /home/cluster

#改名

[cluster@PCS101 ~]$ mv /home/cluster/apache-storm-0.9.-incubating apache-storm-0.9.

#创建任务目录

[cluster@PCS101 ~]$ mkdir /home/cluster/apache-storm-0.9./task
2.修改配置
[cluster@PCS101 conf]$ vim /home/cluster/apache-storm-0.9./conf/storm.yaml

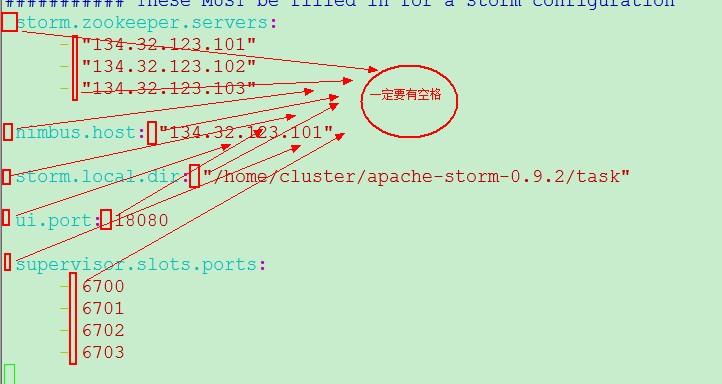
()zookeeper集群地址

storm.zookeeper.servers:

   - "134.32.123.101"

   - "134.32.123.102"

   - "134.32.123.103"

()主节点Nimbus配置

nimbus.host: "134.32.123.101"

()设置storm运行任务执行的jar存放的目录

storm.local.dir: "/home/cluster/apache-storm-0.9.2/task"

()配置UI端口:ui.port

ui.port:

()配置worker而进程默认端口号,如果worker进程超过设置数量,则多出来的worker会随机分配端口

supervisor.slots.ports:

  -

  -

  -

  -
配置注意留有空格:
3.将101上的storm拷贝到102、103上
[cluster@PCS101 ~]$ scp -r /home/cluster/apache-storm-0.9./ cluster@134.32.123.102:/home/cluster/

[cluster@PCS101 ~]$ scp -r /home/cluster/apache-storm-0.9./ cluster@134.32.123.103:/home/cluster/
4.root用户修改系统环境变量
[root@PCS101 ~]# vim /etc/profile

export STORM_HOME=/home/cluster/apache-storm-0.9.

export PATH=$JAVA_HOME/bin:$MYSQL_BIN:$STORM_HOME/bin:$PATH

[root@PCS101 ~]# source /etc/profile
5.启动(保证zookeeper集群已启动)
按顺序启动:
启动Nimbus
134.32.123.101: 主机器(nimbus运行)    : nohup storm nimbus > /dev/null >& &

[cluster@PCS101 ~]$ jps

 QuorumPeerMain

 Jps

 nimbus
启动supervisor
134.32.123.101: 从机器(supervisor运行): nohup storm supervisor > /dev/null >& &

134.32.123.102: 从机器(supervisor运行): nohup storm supervisor > /dev/null >& &

134.32.123.103: 从机器(supervisor运行): nohup storm supervisor > /dev/null >& &

[cluster@PCS102 conf]$ jps

 supervisor

 Jps

 QuorumPeerMain
启动UI (默认jetty做容器)
134.32.123.101: 主机器(ui运行)        : nohup storm ui > /dev/null >& & (查看ui)

[cluster@PCS101 conf]$ jps

 supervisor

 QuorumPeerMain

 nimbus

 Jps

 core
启动logviewer
134.32.123.101: 主机器(logviewer运行) : nohup storm logviewer > /dev/null >& &(查看工作日志)

[cluster@PCS101 conf]$ jps

 supervisor

 QuorumPeerMain

 Jps

 nimbus

 logviewer

 core
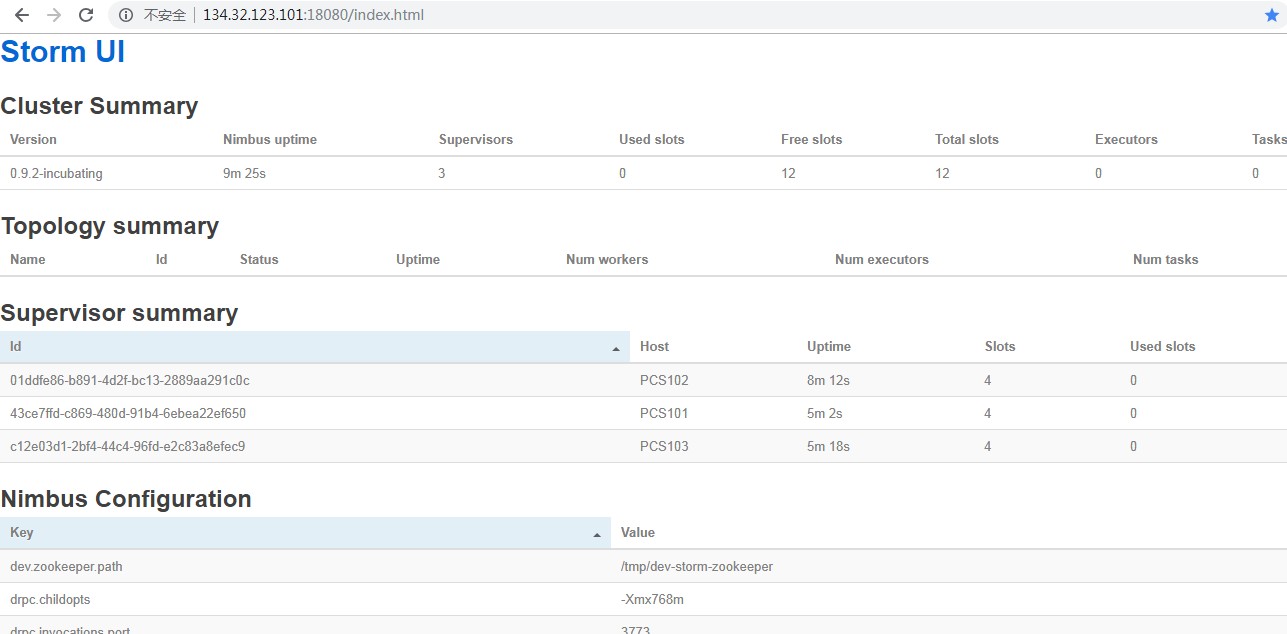
访问 StormUI
http://134.32.123.101:18080/
附一:伪分布式搭建
#storm帮助命令

[cluster@PCS101 ~]$ ./bin/storm --help

#下面分别按照顺序启动ZooKeeper、Nimbus、UI、supervisor、logviewer

[cluster@PCS101 ~]$ ./bin/storm dev-zookeeper >> ./logs/zk.out 2>&1 &

[cluster@PCS101 ~]$ ./bin/storm nimbus >> ./logs/nimbus.out 2>&1 &

[cluster@PCS101 ~]$ ./bin/storm ui >> ./logs/ui.out 2>&1 &

[cluster@PCS101 ~]$ ./bin/storm supervisor >> ./logs/supervisor.out 2>&1 &

[cluster@PCS101 ~]$ ./bin/storm logviewer >> ./logs/logviewer.out 2>&1 &
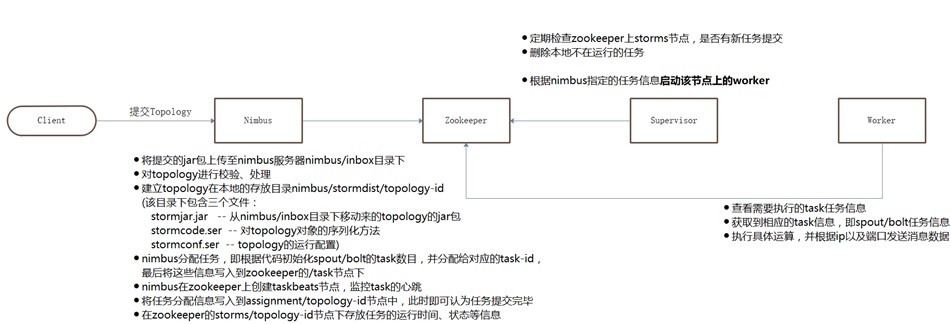
附二:storm提交任务流程
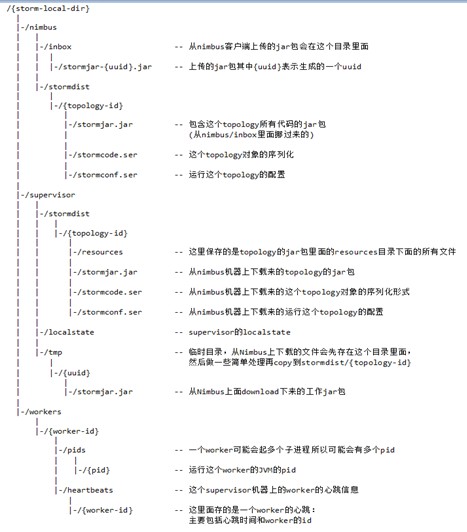
附三:storm本地目录树
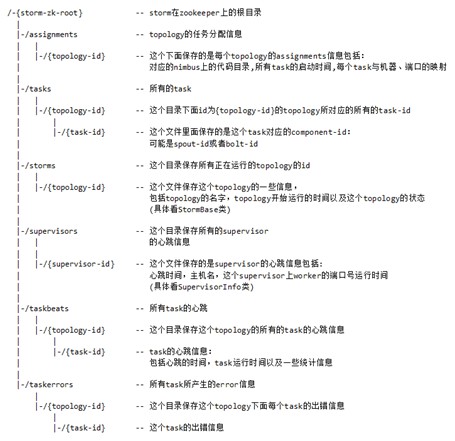
附四:ZK目录树
参考:
大数据处理框架之Strom:Storm集群环境搭建的更多相关文章
- 一:Storm集群环境搭建
第一:storm集群环境准备及部署[1]硬件环境准备--->机器数量>=3--->网卡>=1--->内存:尽可能大--->硬盘:无额外需求[2]软件环境准备---& ...
- Storm —— 集群环境搭建
一.集群规划 这里搭建一个3节点的Storm集群:三台主机上均部署Supervisor和LogViewer服务.同时为了保证高可用,除了在hadoop001上部署主Nimbus服务外,还在hadoop ...
- Storm 学习之路(四)—— Storm集群环境搭建
一.集群规划 这里搭建一个3节点的Storm集群:三台主机上均部署Supervisor和LogViewer服务.同时为了保证高可用,除了在hadoop001上部署主Nimbus服务外,还在hadoop ...
- Storm 系列(四)—— Storm 集群环境搭建
一.集群规划 这里搭建一个 3 节点的 Storm 集群:三台主机上均部署 Supervisor 和 LogViewer 服务.同时为了保证高可用,除了在 hadoop001 上部署主 Nimbus ...
- storm集群环境搭建
1.环境 Java环境 卸载虚机环境中自带的openJdk,安装sun的jdk,配置环境变量 2.安装storm 下载storm安装包 解压到安装目录,配置环境变量 vi /etc/profile # ...
- 大数据处理框架之Strom: Storm拓扑的并行机制和通信机制
一.并行机制 Storm的并行度 ,通过提高并行度可以提高storm程序的计算能力. 1.组件关系:Supervisor node物理节点,可以运行1到多个worker,不能超过supervisor. ...
- centos7:storm集群环境搭建
1.安装storm 下载storm安装包 在线下载 wget http://apache.fayea.com/storm/apache-storm-1.1.1/apache-storm-1.1.1.t ...
- 大数据hadoop入门学习之集群环境搭建集合
目录: 1.基本工作准备 1.虚拟机准备 2.java 虚拟机-jdk环境配置 3.ssh无密码登录 2.hadoop的安装与配置 3.hbase安装与配置(集成安装zookeeper) 4.zook ...
- 大数据处理框架之Strom: Storm----helloword
大数据处理框架之Strom: Storm----helloword Storm按照设计好的拓扑流程运转,所以写代码之前要先设计好拓扑图.这里写一个简单的拓扑: 第一步:创建一个拓扑类含有main方法的 ...
随机推荐
- vue项目使用vue-photo-preview插件实现点击图片放大预览和移动
官方链接: http://npm.taobao.org/package/vue-photo-preview # 安装 npm install vue-photo-preview --save # 引入 ...
- Javabean非空变量校验工具
摘要 调研java Class getDeclaredFields() 与getFields()的区别,设计请求参数为Javabean时,基于反射机制校验其中非空变量的公共方法. java Class ...
- 内核atom机制
内核版本:linux2.6.22.6 硬件平台:JZ2440 驱动源码 atom_ipc_poll_key_int_drv.c : #include <linux/module.h> #i ...
- SQL优化之踩过的坑【一】
正看资料看的过瘾,突然收到报警,说服务器负载太高,好吧,登录服务器看看,我擦嘞,还能不能愉快的玩耍了?下面是当时的负载情况 看见mysql使用cpu已经到了2000,io没有等待.说明应该没有大的临时 ...
- mysql 操作sql语句 目录
mysql 操作sql语句 操作数据库 mysql 操作sql语句 操作数据表 mysql 操作sql语句 操作数据表中的内容/记录
- 前端开发---HTML---介绍
阅读目录 1.标签 2.HTML目录结构 3.HTML注释 一.web1.0时代的网页制作 静态网页,所谓的静态网页就是没有与用户进行交互而仅仅供读者浏览的网页,我们当时称为“牛皮癣”网页.例如一篇Q ...
- vue-element分页
<template> <card-layout :title="L('Users')" :actions="actions" @click=& ...
- vue-devtools : vue的调试工具及log显示工具 vconsole
使用 devtools 有很多好处,比如它可以让你能够实时编辑数据属性并立即看到其反映出来的变化.另一个主要的好处是能够为 Vuex 提供时间旅行式的调试体验. 注意:请留意如果页面使用了一个生产环境 ...
- (转)以太坊(Ethereum ETH)的奖励机制
如果问一块显卡它最恨什么,那么答案一定是以太坊.以太坊,矿工为之疯狂,显卡为之颤抖,游戏玩家为之骂娘. 然而,除了购买矿机.连接矿池.卖币套现之外,是否有人关注过以太坊的奖励机制呢? 且听我慢慢道来. ...
- linux 执行远程linux上的shell脚本或者命令以及scp 上传文件到ftp--免密码登陆
场景:在linux A 上执行Linux B上的shell脚本和命令 步骤1.设置ssh免登陆 1.SSH无密码登录 # 本地服务器执行(A机器):生成密钥对 ssh-keygen -t dsa -P ...