
【UV统计】海量数据统计的前世今生
背景
在互联网公司中,每个项目都需要数据统计、分析,便于项目组利用详细数据研究项目的整体情况,进行下一步的调整。在数据统计中,UV统计是最常见的,也是最普遍的。有的场景要求实时性很高,有点场景要求准确性很高,有的场景比较在意计算过程中的内存。不同的场景使用不同的算法,下面我们从0到1简单介绍下UV统计领域。
什么是UV统计
假设我们的场景是商家这边上架一系列水果,然后需要统计出一共上架几种水果。具体如下所示:
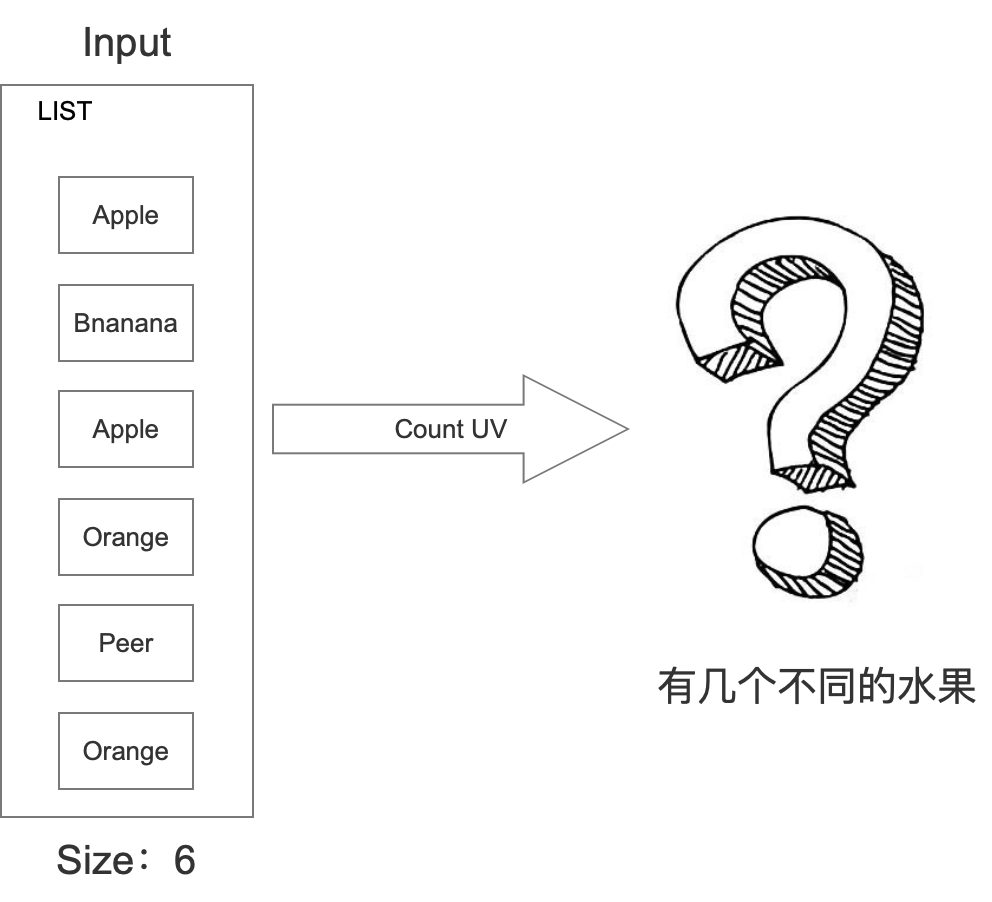
针对这个问题,我们想到的最简单的方式就是利用STL中的set处理。
SET
上架一个水果的时候,也同时在set中插入。最后需要统计的时候,直接计算set中一共有几个水果即可。具体如下所示:
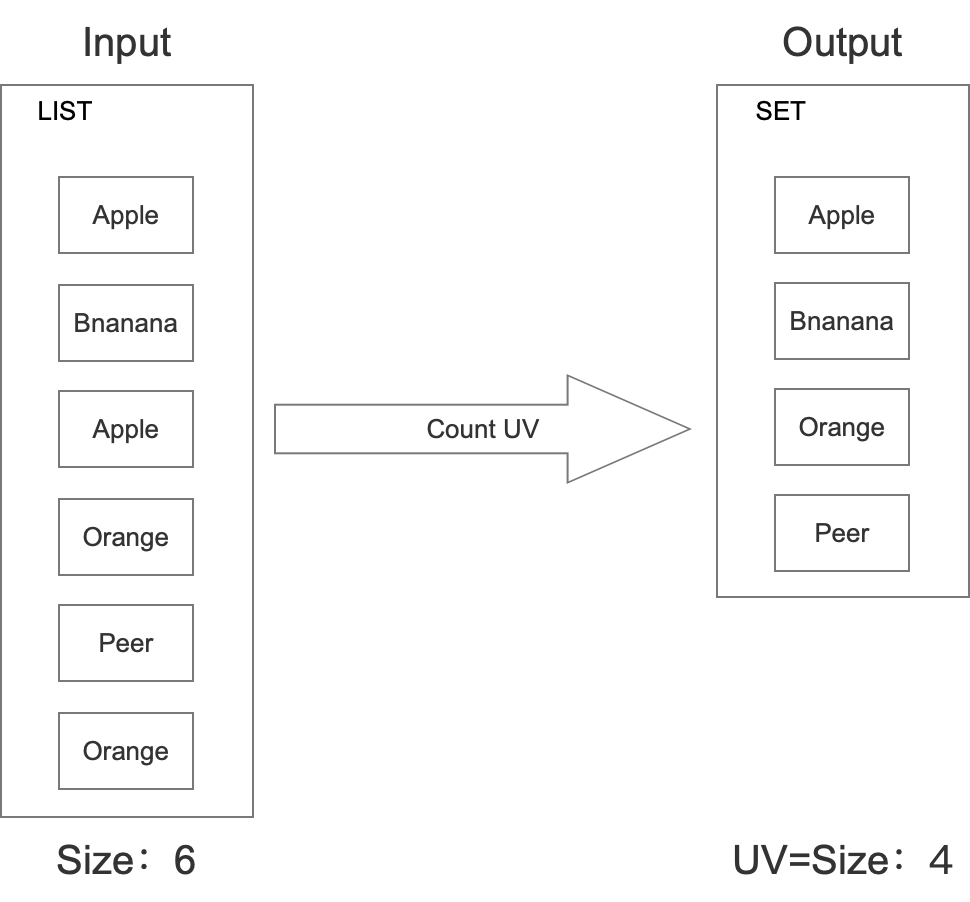
这种方式准确率是绝对准确的,但是这种方式耗费的内存是很大的。
假设每个水果需要 K 字节,那么如果有 M 个水果,一共需要 K * M 字节。那么我们能不能缩小这里的内存呢?
稍微损失一点准确率换取内存?具体见下面HashMap的方式
HASHMAP
这种算法在上架一个水果的时候,只需要在特定的位置置1即可,而不需要存储这个位置上究竟是何种水果。然后在统计的时候,只需要统计hashmap里面有多少个1即可。具体如下所示:
具体如下所示:
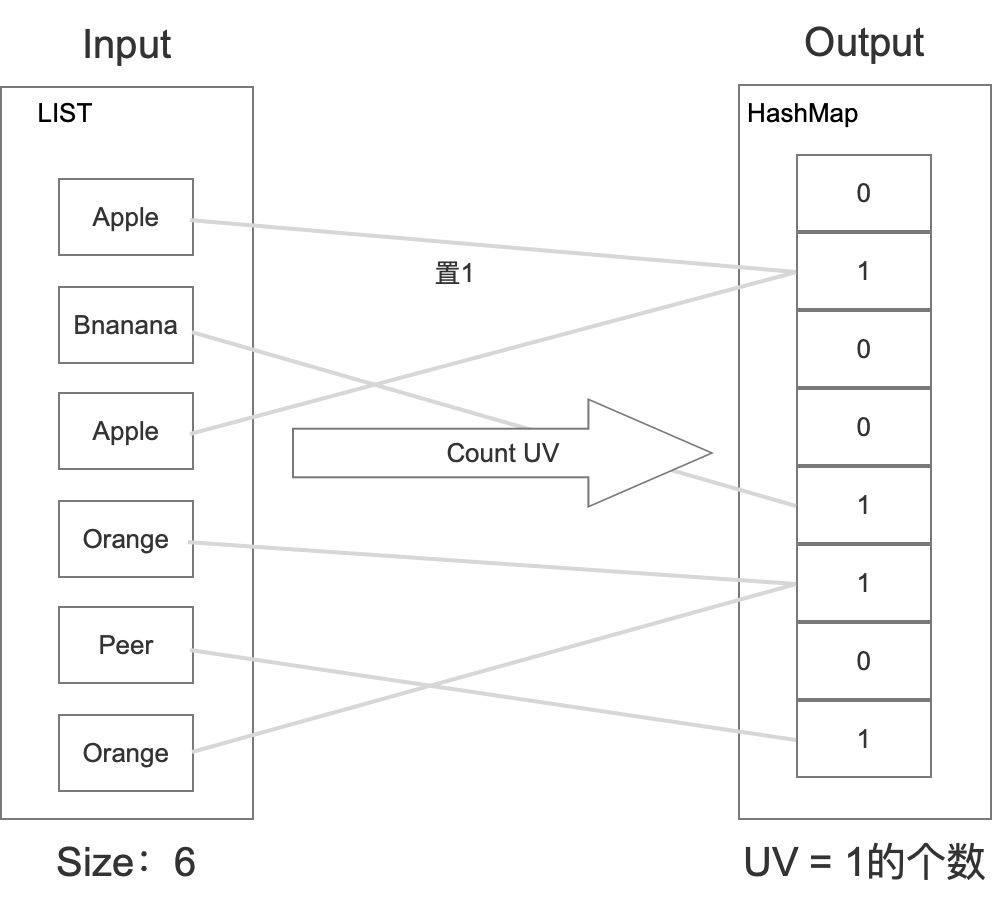
那么如果有M个水果,这里其实只需要 M / 8 字节,相比set的方式内存直接缩小到1/8。当然Hash肯定会有冲突的,所以这里肯定有一定准确率的损失。
但是如果涉及到海量数据的UV统计,这里的内存还是很大的。
能否用上统计学进一步缩小内存呢?具体见下面的Linear Count的方式。
Linear Count
这种算法在上架一个水果的时候,完全跟hashmap一致,在相应位置置1。
然后在统计的时候,利用统计学的方式,根据hashmap中零的个数给出一个估算值。具体如下所示:
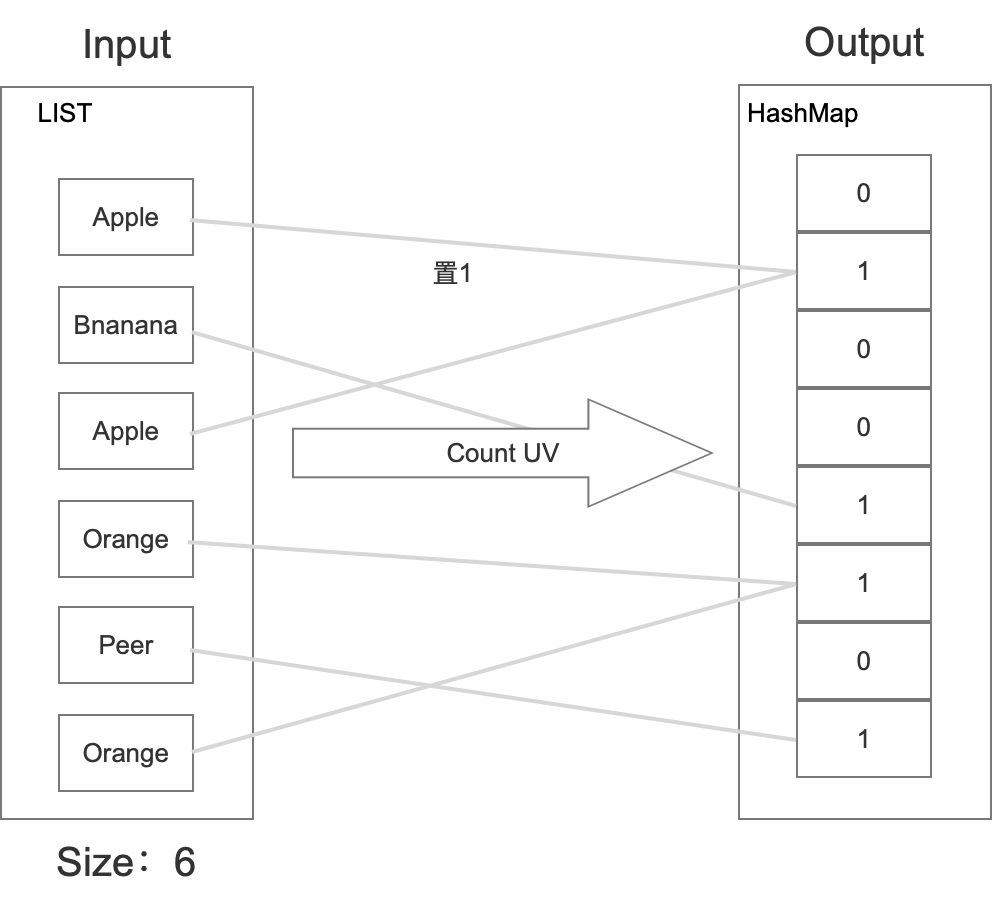
假设M为哈希桶长度,那么每次上架水果,每个桶被选中的概率为:
$$\frac{1}{M}$$
然后在上架N个元素后,某个桶为0的概率为:
$$(1-\frac{1}{M}) ^N$$
所以在上架n个元素后,哈希桶中零的个数期望为:
$$ZeroNum=\sum_{i=1}^M (1-\frac{1}{M}) ^N = M (1-\frac{1}{M}) ^N= M ((1+\frac{1}{-M}){-M}){-\frac{N}{M}}) \approx Me^{- \frac{N}{M}}$$
所以最终:
$$
N = UV = -M ln(\frac{ZeroNum}{M})
$$
所以Linear Count算法中,只需统计下hashmap中零的个数,然后代入上式即可。
这种算法在N很小的时候,准确率是很高的,但是N很大的时候,它的准确率急剧下降。
针对海量数据的情况,LogLog Count的算法更加鲁棒
LogLog Count
这种算法跟上面几种都不同,上架水果的时候,在相应桶里面记录的是二进制数后面最长的连续零个数。然后统计的时候,利用统计学的方式,根据存储中最长连续后缀零个数,得出一个估计值。具体如下所示:
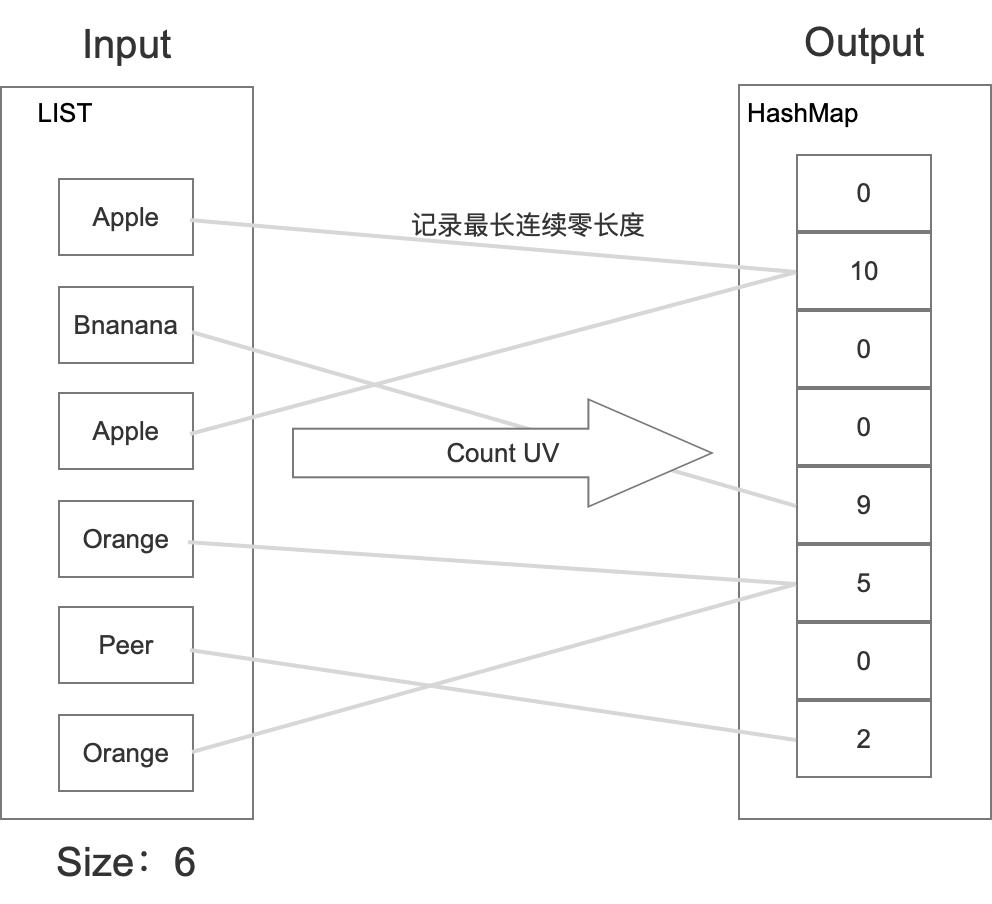
它的原理如下:
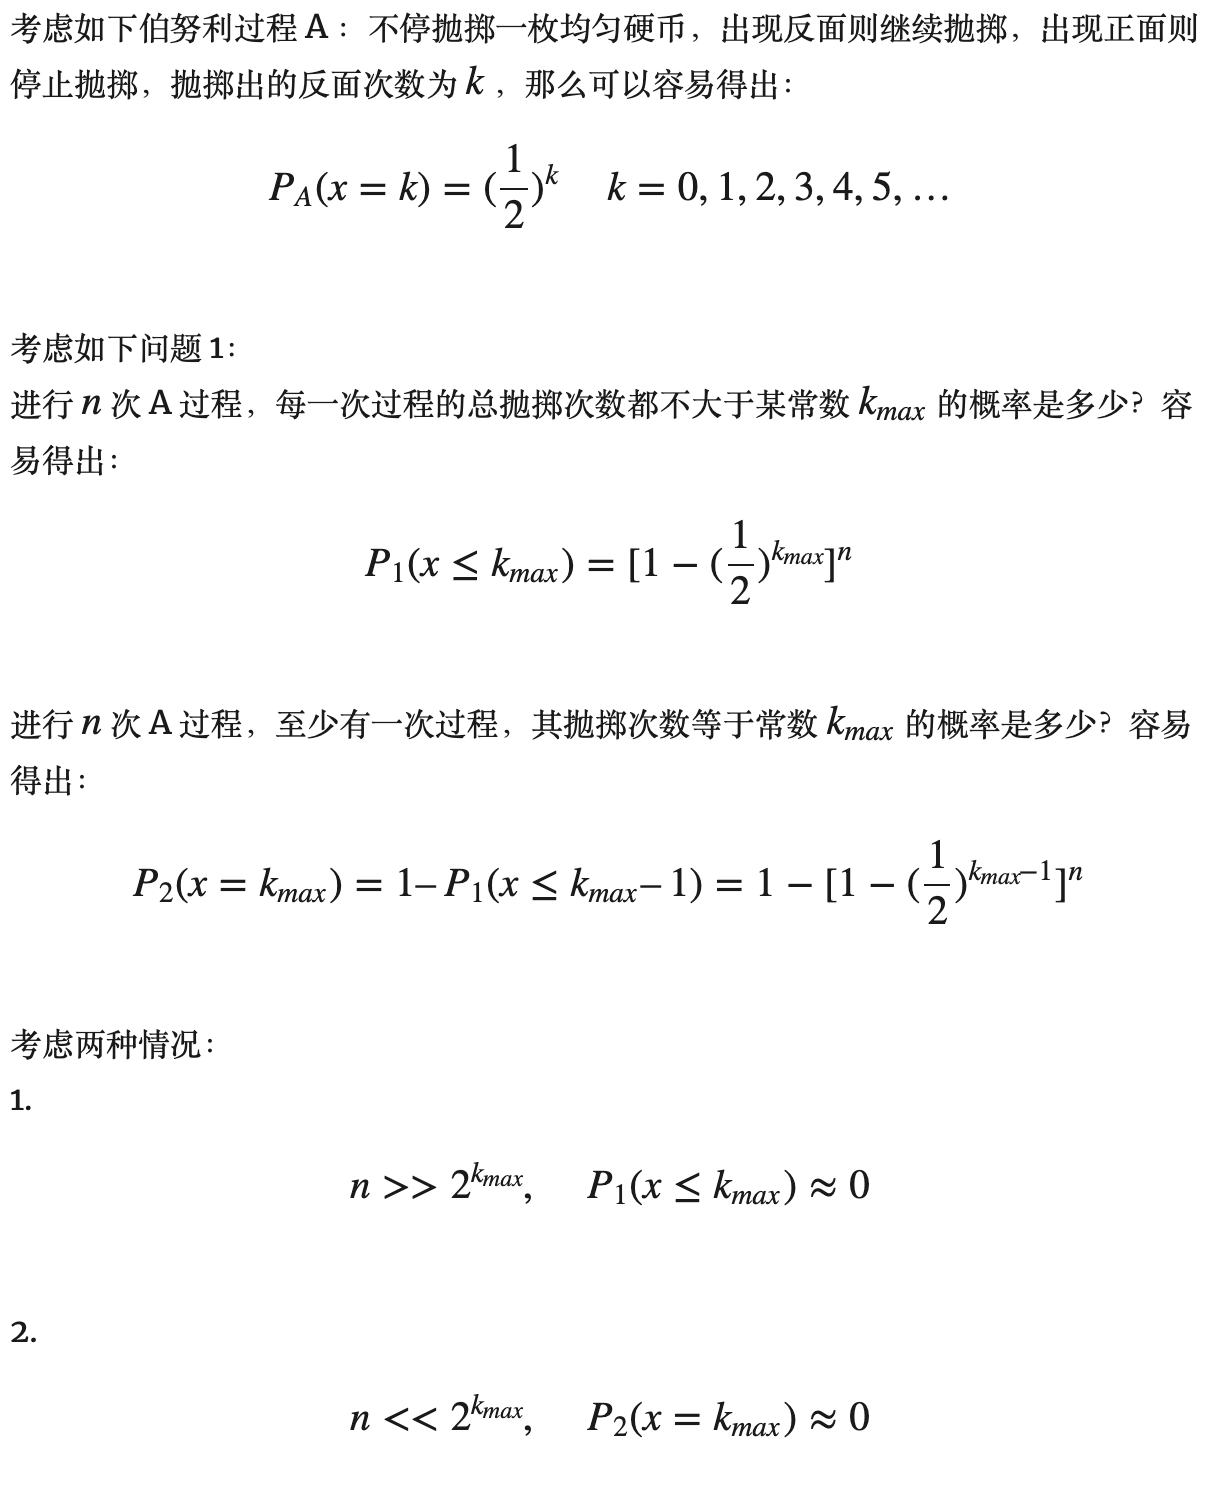
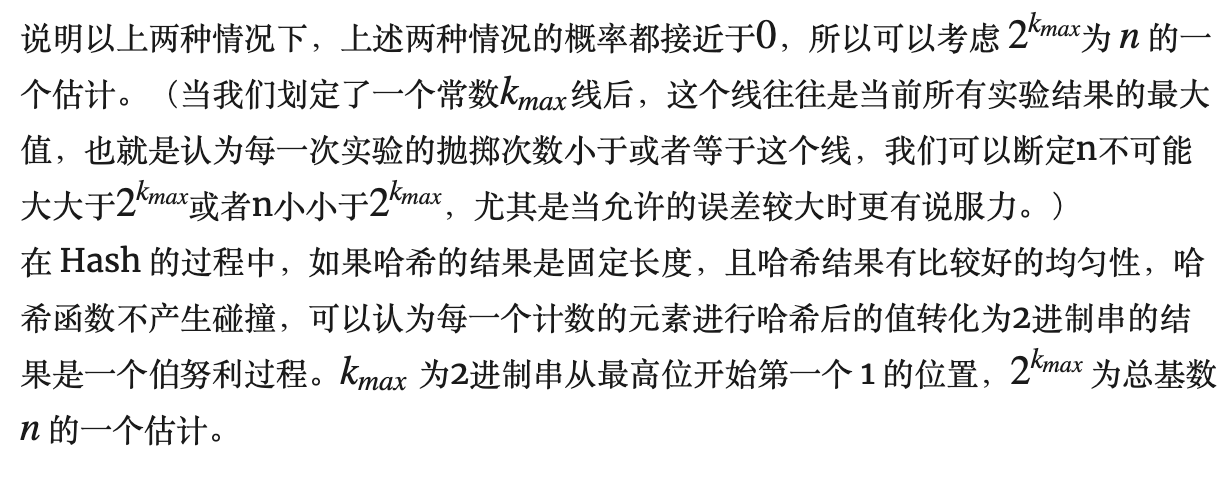
这里如果只使用一个桶来估计的话,它的误差是很大,需要用分桶平均的方式来减少它的误差。
分桶平均
既然这里利用了分桶来减少误差,那么这里统计的时候就必须合起来,这里有4种方式:
- 算术平均:$$UV=\frac{\sum_{j=1}^mUV_j} { m}$$
- 几何平均:$$UV=\sqrt[m]{UV_1...UVm}$$
- 调和平均:$$UV=\frac{m}{\sum_{j=1}mUV_j{-1}}$$
- 中位数:$$UV=mediam {UV_1,...,UV_m}$$
LogLog Count利用的是算术平均的方式,所以最终估计值为:
$$UV=2{\frac{\sum_{j=1}m{UV_j}}{m}}$$
这种算法对于基数大的情况下准确率挺高的,但是基数小的情况下准确率很低。
HyperLogLog Count
这种算法跟LogLog Count 类似,有个区别点就是它在求均值的时候利用了调和平均数,而不是算术平均数。这里最终估计值为:
$$UV=mm(\sum_{j=1}m{2{-M_j}})^{-1}$$
然后它还引入了分段误差修正。
误差修正
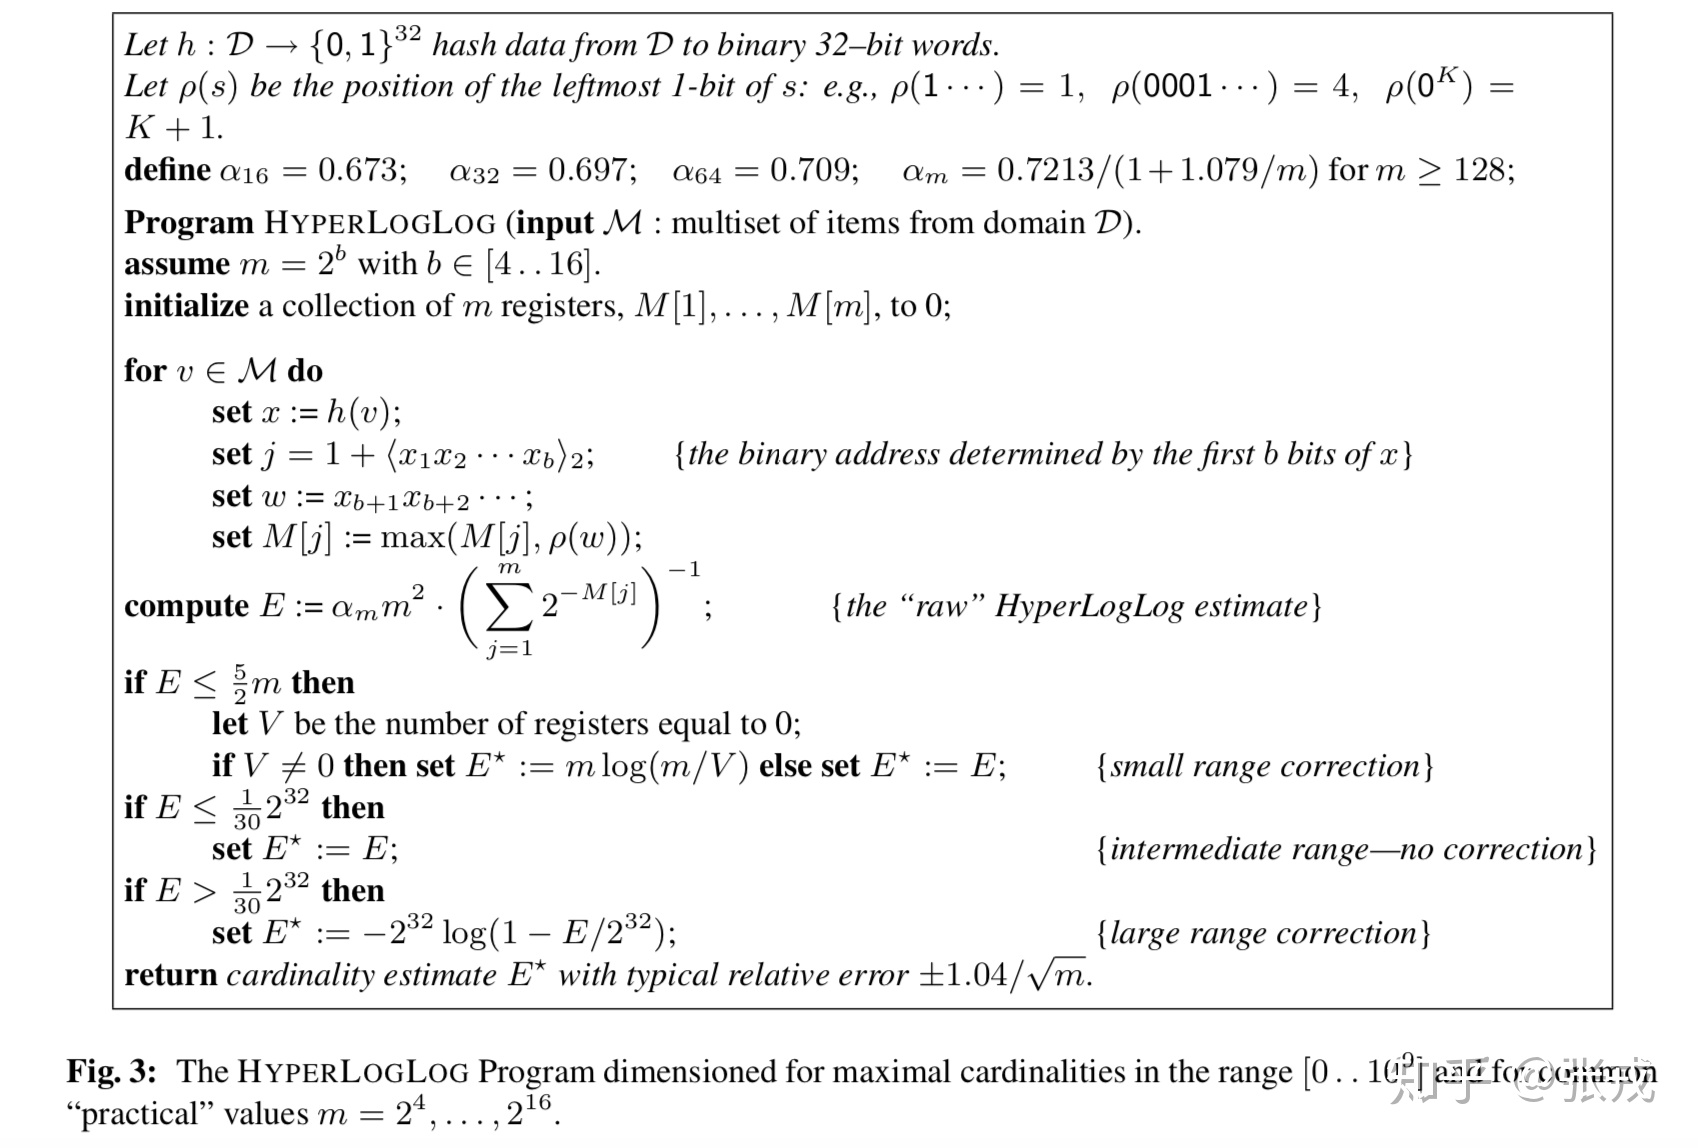
具体可以看我github上的代码:HyperLogLog
总结
| 准确率 | 内存 | 耗时 | |
|---|---|---|---|
| Set | 绝对准确 | K * M | O(Mlog(M)) |
| HashMap | 很高 | M/8 | O(M) |
| Linear Count | 基数小高,基数大低 | M/8 | O(M/8) |
| LogLog Count | 基数小低,基数大高 | ||
| HyperLogLog Count | 高 |
【UV统计】海量数据统计的前世今生的更多相关文章
- Redis 实战篇:巧用Bitmap 实现亿级海量数据统计
在移动应用的业务场景中,我们需要保存这样的信息:一个 key 关联了一个数据集合. 常见的场景如下: 给一个 userId ,判断用户登陆状态: 显示用户某个月的签到次数和首次签到时间: 两亿用户最近 ...
- Hexo博客添加SEO-评论系统-阅读统计-站长统计
原文地址:→传送门 写在前面 在五月出捣腾了一把个人博客,但是刚开始只做了一些基础设置,套路也没摸清,基础安装篇请看hexo从零开始到搭建完整,里面讲到了基础工具的安装及blog项目的文件夹含义,以及 ...
- 智能ERP收银统计-优惠统计计算规则
1.报表统计->收银统计->优惠统计规则 第三方平台优惠:(堂食订单:支付宝口碑券优惠)+(外卖订单:商家承担优惠) 自平台优惠:(堂食订单:商家后台优 ...
- 使用redis做pv、uv、click统计
redis实时统计 设计思路: 1. 前端smarty插件(smarty_function_murl),将网站所有的连接生成一个urlid,后端根据获取的参数将需要的数据存入redis. 2.后端插件 ...
- 43、内置函数及每日uv、销售额统计案例
一.spark1.5内置函数 在Spark 1.5.x版本,增加了一系列内置函数到DataFrame API中,并且实现了code-generation的优化.与普通的函数不同,DataFrame的函 ...
- 怎么区分PV、IV、UV以及网站统计名词解释(pv、曝光、点击)
PV(Page View)访问量,即页面访问量,每打开一次页面PV计数+1,刷新页面也是. IV(Internet Protocol)访问量指独立IP访问数,计算是以一个独立的IP在一个计算时段内访问 ...
- 海量数据统计topK
有一个1G大小的一个文件,里面每一行是一个词,词的大小不超过16字节,内存限制大小是1M.返回频数最高的100个词. 思路: 把这1G的数据一次性全部读入内存是不可能了,可以每次读一行,然后将该词存到 ...
- Oracle11g 统计信息——统计信息自动收集任务
参考文献: Oracle11g 统计信息(一)-----统计信息自动收集任务 背景: 在使用cacti监控oracle数据库IO的时候发现每天晚上10点钟的时候oracle数据库读写明显增加,如下图所 ...
- MySQL查询统计,统计唯一值并分组
做个笔记 SQLyog客户端访问MySQL服务器 统计数据:次数总数, 次数成功率,对象(obj)总数,对象(obj)成功率 要求:按时间排序和分组 sql语句如下: SELECT a.date AS ...
随机推荐
- SpringBoot整合Xxl-Job
一.下载Xxl-Job源代码并导入本地并运行 Github地址:https://github.com/xuxueli/xxl-job 中文文档地址:https://www.xuxueli.com/xx ...
- 如何将IDM中的进程设置进行备份
有时候我们想用浏览器自带的下载管理器进行下载,但是一点下载却被IDM(Internet Download Manager)自动嗅探捕获并下载,还有人因为重装系统使得之前更改IDM的设置都失效,只得重新 ...
- iOS问题:pch not found
问题描述: clang: error: no such file or directory: '/Users/apple/Desktop/迅点App_Mark/FaceHelp/FaceHelp-Pr ...
- Sysbench对Mysql进行基准测试
前言 1.基准测试(benchmarking)是性能测试的一种类型,强调的是对一类测试对象的某些性能指标进行定量的.可复现.可对比的测试. 进一步来理解,基准测试是在某个时候通过基准测试建立一个已知的 ...
- php8.0正式版新特性和性能优化学习
前言 PHP团队宣布PHP8正式GA(链接).php的发展又开启了新的篇章,PHP8.0.0版本引入了一些重大变更及许多新特性和性能优化机制.火速学习下~ JIT(Just in Time Compi ...
- 【数学】康托展开 && 康托逆展开
(7.15)康托展开,就是把全排列转化为唯一对应自然数的算法.它可以建立1 - n的全排列与[1, n!]之间的自然数的双向映射. 1.康托展开: 尽管我并不清楚康托展开的原理何在,这个算法的过程还是 ...
- Luogu P4306 JSOI2010 连通数
tarjan有向图缩点的基础应用.把原图中某点的连通数转化为反向图中"能够到达某点的个数".缩点后,每个新点的贡献等于 原dcc大小 * f[i] 其中f[i]表示(包括该点自身) ...
- Codeforces Round #668 (Div. 2) D. Tree Tag 题解(博弈)
题目链接 题目大意 给你一颗树,Alice在a点,Bob在b点,Alice最多走da步,Bob最多走db步,两人轮流走路.要你判断经过无数次追赶后,Alice是否可以追上Bob,两人进行的都是最优策略 ...
- LeetCode 034 Search for a Range
题目要求:Search for a Range Given a sorted array of integers, find the starting and ending position of a ...
- FPGA PS2协议
VerilogHDL那些事儿_建模篇(黑金FPGA开发板配套教程) 作者:akuei2 说明:参照该书将部分程序验证学习一遍 学习时间:2014年5月3号 主要收获: 1. 对PS2接口有初步了解: ...