
scrapy爬虫学习系列一:scrapy爬虫环境的准备
系列文章列表:
scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_007_scrapy01.html
scrapy爬虫学习系列二:scrapy简单爬虫样例学习: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_007_scrapy02.html
scrapy爬虫学习系列三:scrapy部署到scrapyhub上: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_004_scrapyhub.html
scrapy爬虫学习系列四:portia的学习入门: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_010_scrapy04.html
scrapy爬虫学习系列五:图片的抓取和下载: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_011_scrapy05.html
scrapy爬虫学习系列六:官方文档的学习: https://github.com/zhaojiedi1992/My_Study_Scrapy
1.scrapy简介
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。
官方简介地址:https://docs.scrapy.org/en/latest/topics/architecture.html
中文的简介地址:http://scrapy-chs.readthedocs.io/zh_CN/0.24/topics/architecture.html 这个版本才旧了,不建议看了(英文的是1.4的, 这个是0.24)
1.1 scrapy基础架构
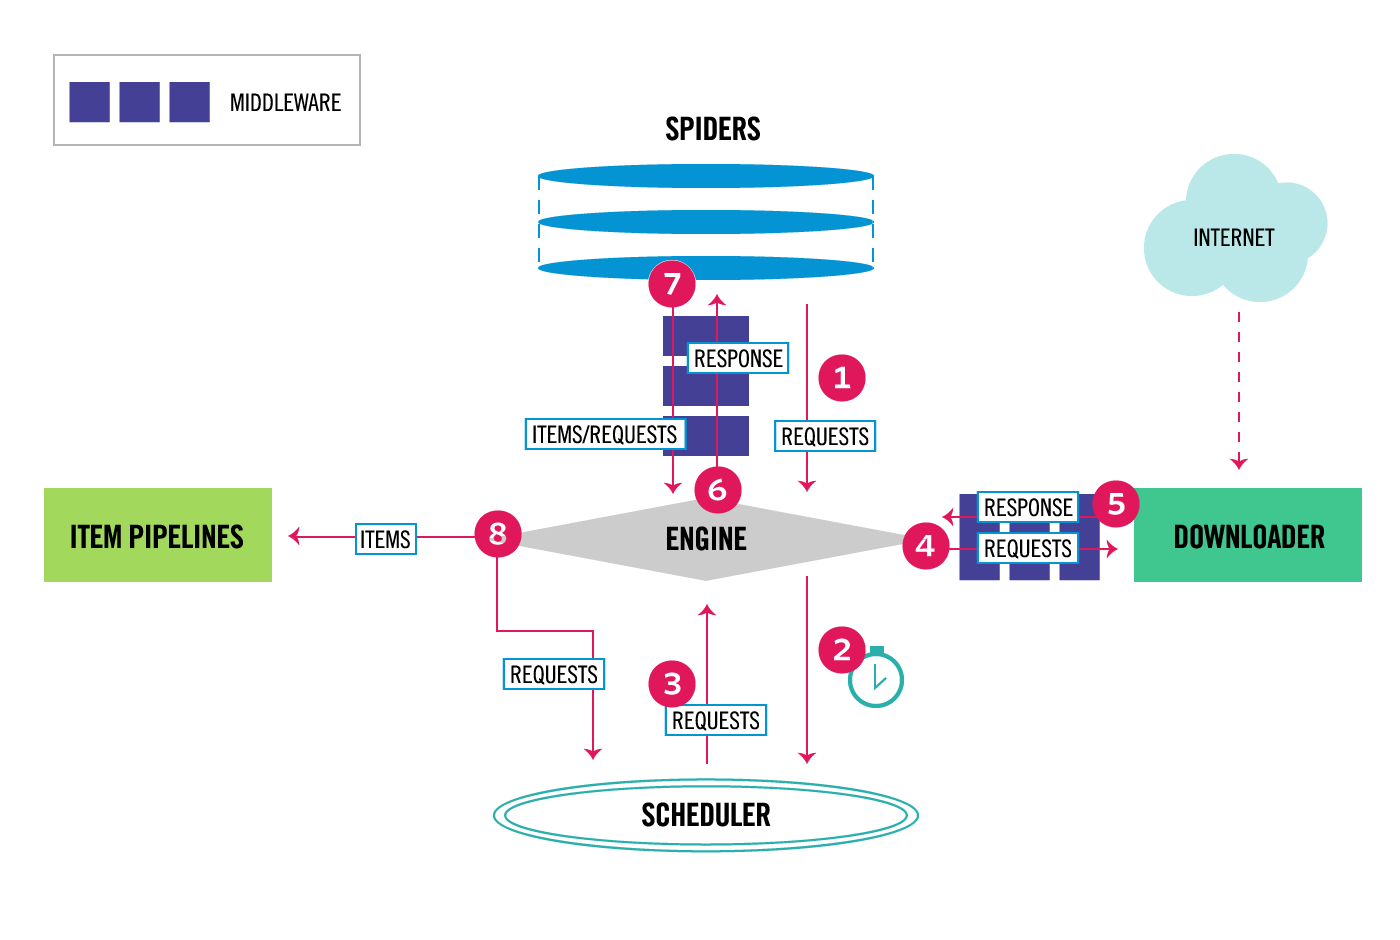
1.2 各个组件简介
Scrapy Engine
引擎负责控制数据流在系统中所有组件中流动,并在相应动作发生时触发事件。 详细内容查看下面的数据流(Data Flow)部分。
调度器(Scheduler)
调度器从引擎接受request并将他们入队,以便之后引擎请求他们时提供给引擎。
下载器(Downloader)
下载器负责获取页面数据并提供给引擎,而后提供给spider。
Spiders
Spider是Scrapy用户编写用于分析response并提取item(即获取到的item)或额外跟进的URL的类。 每个spider负责处理一个特定(或一些)网站。 更多内容请看 Spiders 。
Item Pipeline
Item Pipeline负责处理被spider提取出来的item。典型的处理有清理、 验证及持久化(例如存取到数据库中)。 更多内容查看 Item Pipeline 。
下载器中间件(Downloader middlewares)
下载器中间件是在引擎及下载器之间的特定钩子(specific hook),处理Downloader传递给引擎的response。 其提供了一个简便的机制,通过插入自定义代码来扩展Scrapy功能。更多内容请看 下载器中间件(Downloader Middleware) 。
1.3数据流(Data flow)
Scrapy中的数据流由执行引擎控制,其过程如下:
- 引擎打开一个网站(open a domain),找到处理该网站的Spider并向该spider请求第一个要爬取的URL(s)。
- 引擎从Spider中获取到第一个要爬取的URL并在调度器(Scheduler)以Request调度。
- 引擎向调度器请求下一个要爬取的URL。
- 调度器返回下一个要爬取的URL给引擎,引擎将URL通过下载中间件(请求(request)方向)转发给下载器(Downloader)。
- 一旦页面下载完毕,下载器生成一个该页面的Response,并将其通过下载中间件(返回(response)方向)发送给引擎。
- 引擎从下载器中接收到Response并通过Spider中间件(输入方向)发送给Spider处理。
- Spider处理Response并返回爬取到的Item及(跟进的)新的Request给引擎。
- 引擎将(Spider返回的)爬取到的Item给Item Pipeline,将(Spider返回的)Request给调度器。
- (从第二步)重复直到调度器中没有更多地request,引擎关闭该网站。
2.环境准备(主要是在window下)
安装指南:https://docs.scrapy.org/en/latest/intro/install.html
中文的安装指南:http://scrapy-chs.readthedocs.io/zh_CN/0.24/intro/install.html
2.1 安装python版本
可以从https://www.anaconda.com/download/下载一个python,省了后期各种麻烦。
2.2 安装scrapy
使用conda安装
conda install -c conda-forge scrapy
或者使用pip安装
pip install Scrapy
如果网络不好, 可以参考下这个地址: https://www.cnblogs.com/microman/p/6107879.html
2.3 下载为win32
从http://sourceforge.net/projects/pywin32/ 选择和python版本和操作系统对应的版本下载安装。
官方描述了为何需要win32 :You need to install pywin32 because of this Twisted bug.
详细信息可以看看官方网页:https://docs.scrapy.org/en/latest/faq.html#scrapy-crashes-with-importerror-no-module-named-win32api
2.4提示c++ build(可选)
请安装cmd终端的提示,去指定的网址提示去下载build exe安装程序,安装后重新启动下,我们使用的python是cpython,所以依赖c的环境,如果你的电脑安装有vs2015,vs2017
这些c的环境都是有的。这里就可以不用安装了。
如果提示有这个信息。 error: Microsoft Visual C++ 14.0 is required. Get it with "Microsoft Visual C++ Build Tools": http://landinghub.visualstudio.com/visual-cpp-build-tools
如果twisted无法安装,建议去这个地方https://pypi.python.org/pypi/Twisted/下载,自行安装。然后去安装scrapy。
2.5 配置环境变量
将你的python.exe 所在的目录和子目录Scripts目录都添加到PATH环境变量中去。
比如C:\Python2.7\;C:\Python2.7\Scripts\;
2.6 测试python 和scrapy
C:\Users\Administrator>python

Python 3.6. |Anaconda custom (-bit)| (default, May  , ::) [MSC v.  bit (AMD64)] on win32

Type "help", "copyright", "credits" or "license" for more information.

>>> import scrapy

>>>
2.7 ipython 或者bpython的安装
ipython和bpython都是python的解析器,在cmd终端下提供
ipython的安装相对简单,使用如下命令即可安装
C:\Users\Administrator>conda install ipython

或者

C:\Users\Administrator>pip install ipython
如果你是在linux下编译安装ipython可以参考下我的另一篇博客:http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_001.html
bpython的安装有点问题:
可以参看我的另一篇博客:http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_006_bpython.html
环境准备好了。 那我们就可以开始scrapy的入门学习了。
2.8开发环境
我这里使用pycharm 软件去开发python, 当然小伙伴们也是可以使用其他的开发环境, 我这里推荐下打开也可以试试vs code 去搭建python开发环境。
scrapy爬虫学习系列一:scrapy爬虫环境的准备的更多相关文章
- scrapy爬虫学习系列五:图片的抓取和下载
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列四:portia的学习入门
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列二:scrapy简单爬虫样例学习
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列三:scrapy部署到scrapyhub上
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- 爬虫学习之基于Scrapy的爬虫自动登录
###概述 在前面两篇(爬虫学习之基于Scrapy的网络爬虫和爬虫学习之简单的网络爬虫)文章中我们通过两个实际的案例,采用不同的方式进行了内容提取.我们对网络爬虫有了一个比较初级的认识,只要发起请求获 ...
- 《Python爬虫学习系列教程》学习笔记
http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多.学习过程中我把一些学习的笔记总结下来,还记录了一些自己 ...
- [转]《Python爬虫学习系列教程》
<Python爬虫学习系列教程>学习笔记 http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多. ...
- Python爬虫学习:三、爬虫的基本操作流程
本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:三.爬虫的基本操作与流程 一般我们使用Python爬虫都是希望实现一套完整的功能,如下: 1.爬虫目标数据.信息: 2.将 ...
- Python爬虫学习:二、爬虫的初步尝试
我使用的编辑器是IDLE,版本为Python2.7.11,Windows平台. 本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:二.爬虫的初步尝试 1.尝试抓取指定网页 ...
随机推荐
- springboot项目打包
使用IDEA或Eclipse的插件创建springboot项目的时候可以选择打包方式,一般情况下都是选择的jar包. 当想将原来的jar包格式的项目打成war包在本地tomcat下运行时可以通过以下几 ...
- centos查看apache用的是哪个httpd.conf
httpd -V得到类似如下结果: -D HTTPD_ROOT="/etc/httpd" -D SERVER_CONFIG_FILE="conf/httpd.conf&q ...
- Unity-批量修改Prefab上的属性
问题描述:今天发现工程中有些prefab上的脚本丢失了一些引用,本以为手动拖拽上去搞定,后来查看其它prefab,也有类似的问题,于是写了一个小工具,批量修改下. 上代码: [ExecuteInEdi ...
- 创建多线程的方式:继承Thread类和实现Runnable接口
1.通过继承Thread类的方式创建多线程(这里只是简单的代码演示创建多线程的方法) package com.baozi.exer; public class ThreadDemo { public ...
- XP Sp3 开机就要激活,否则无法登录windows桌面
参考网页:https://www.reddit.com/r/sysadmin/comments/5m9240/activating_windows_xp_in_2017_still_possible/ ...
- vue 时间戳 转 日期
<text style="padding-right: 10px; color: #333; font-size: 28px" slot="value"& ...
- 文件访问时间简记(Modify time 和 Change time)
[root@77-29-68-bx-core]# stat hql.out File: 'hql.out' Size: 13750 Blocks: 32 IO Block: 4096 regular ...
- 第一个servlet程序
在Eclipse中新建一个Dynamic Web Project 在WebContent下面添加index.jsp <%@ page language="java" cont ...
- python 视图 (FBV、CBV ) 、Request 和Response对象 、路由系统
一.FBV和CBV1.基于函数的view,就叫FBV(Function Based View) 示例: def add_book(request): pub_obj=models.Publisher. ...
- js中的观察者模式
什么事观察者模式: 这是一种创建松散耦合代码的技术.它定义对象间 一种一对多的依赖关系,当一个对象的状态发生改变时,所有依赖于它的对象都将得到通知.由主体和观察者组成,主体负责发布事件,同时观察者通过 ...