
scrapy爬虫学习系列三:scrapy部署到scrapyhub上
系列文章列表:
scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_007_scrapy01.html
scrapy爬虫学习系列二:scrapy简单爬虫样例学习: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_007_scrapy02.html
scrapy爬虫学习系列三:scrapy部署到scrapyhub上: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_004_scrapyhub.html
scrapy爬虫学习系列四:portia的学习入门: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_010_scrapy04.html
scrapy爬虫学习系列五:图片的抓取和下载: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_011_scrapy05.html
scrapy爬虫学习系列六:官方文档的学习: https://github.com/zhaojiedi1992/My_Study_Scrapy
注意: 我自己新建的一个QQ群(新建的),欢迎大家加入一起学习一起进步 ,群号646187336
这里有个scrapyhub的帮助论坛吧:https://helpdesk.scrapinghub.com/support/solutions
1 scrapyhub简介
scrapyhub就是提供一个云平台,让你的爬虫程序可以开发和运行在云平台上。
我这里提供一个样例的使用过程。
2 github相关方面的准备工作
2.1注册一个github账号
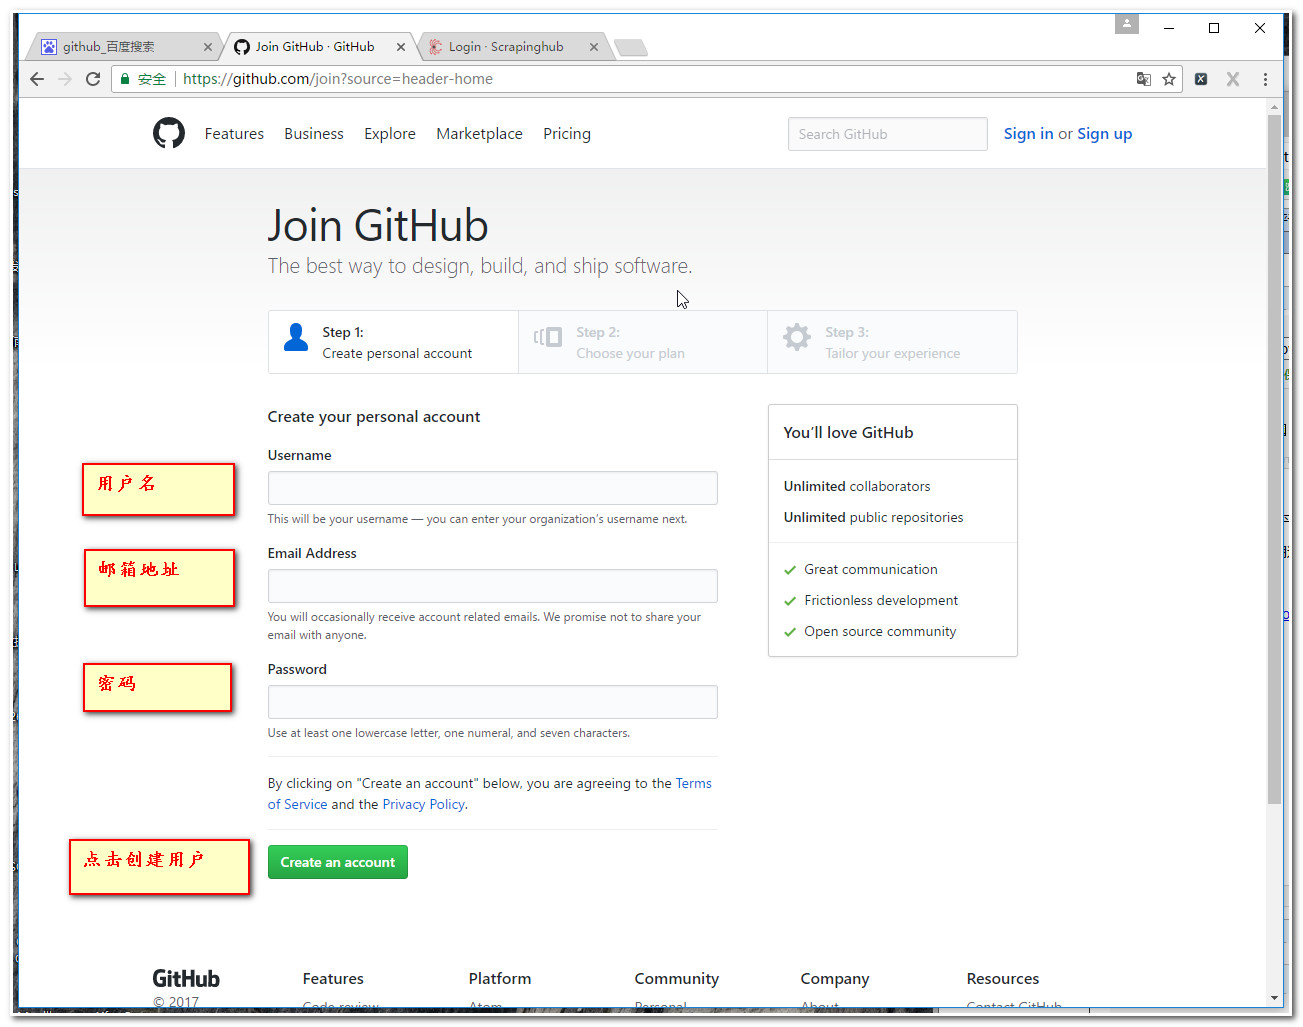
注册页面:https://github.com/join?source=header-home
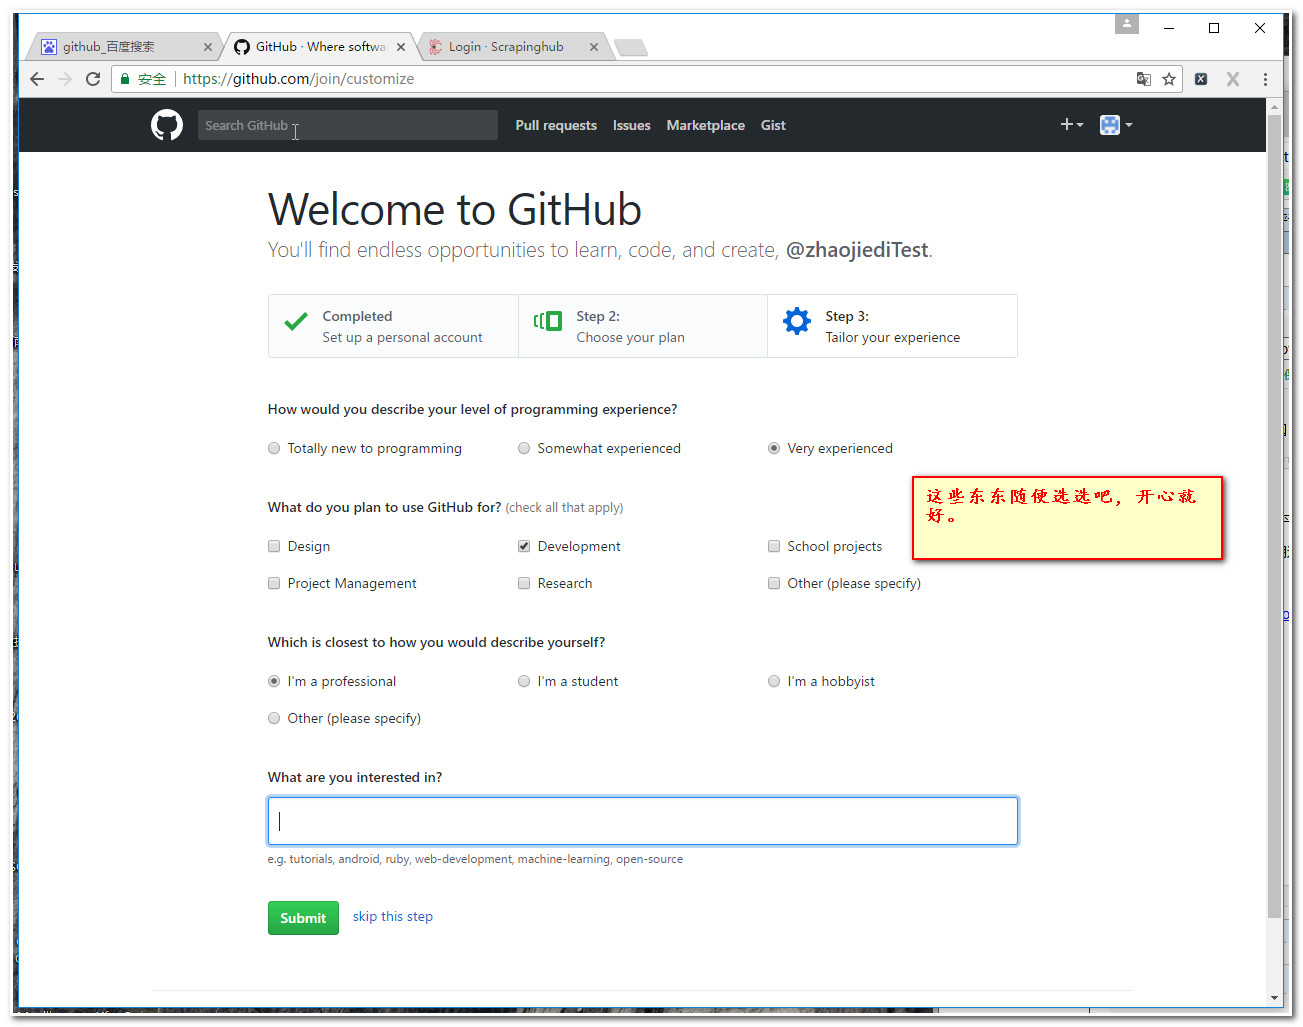
注册过程主要有3步骤,我这里提供3个截图。

2.2 创建一个github项目
2.2.1 我们从github找到scrapy官方的demo程序,地址https://github.com/scrapy/quotesbot,我们打开这个地址,点击页面上面的右上角的fork按钮,创建一个复制。
2.2.2 如果提示需要邮件确认的话,请登录你的邮箱点击链接即可。
2.2.3 重复2.2.1步骤,就可以fork一个官方的scrapy deom了。(具体详细的代码,可以自己去瞧瞧)
3 使用github账号登录scrapyhub网址
3.1 登录scrapyhub网址
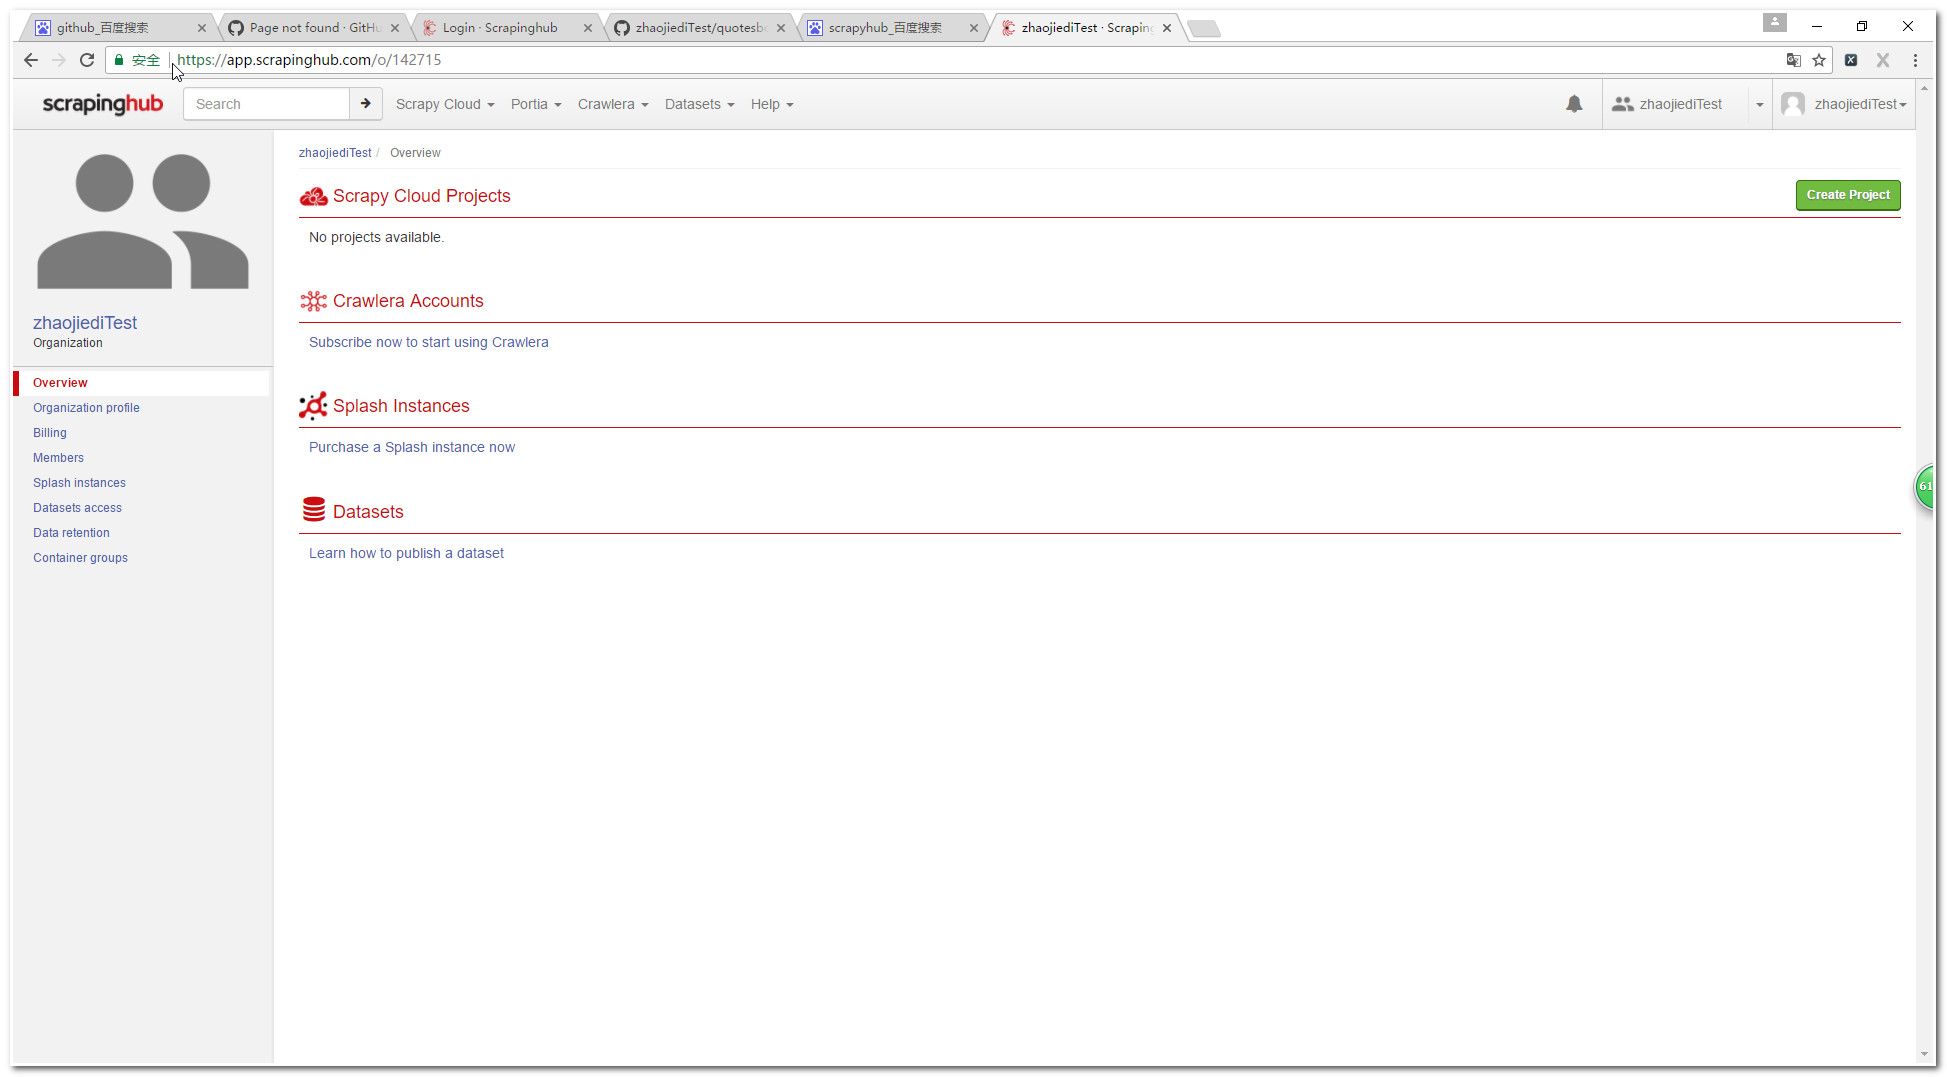
打开scrapyhub的官方网址 https://scrapinghub.com/scrapy-cloud/, 点击右上角的login按钮,选择github登录方式,接下来就是下一步下一步啦。最后就是如下图的界面了。
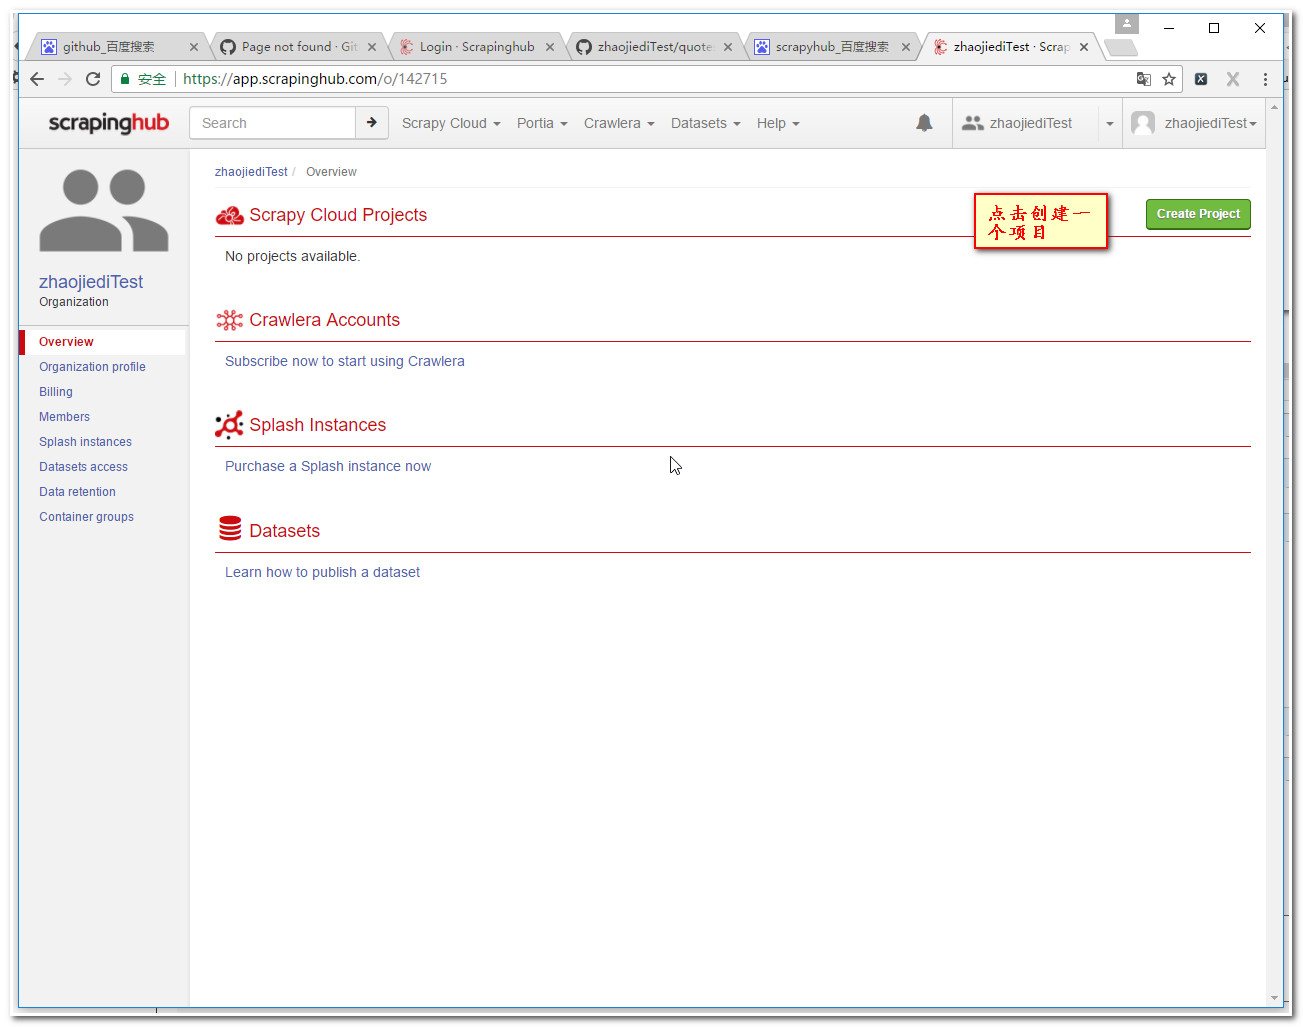
3.2 创建项目
3.3设置下工程参数
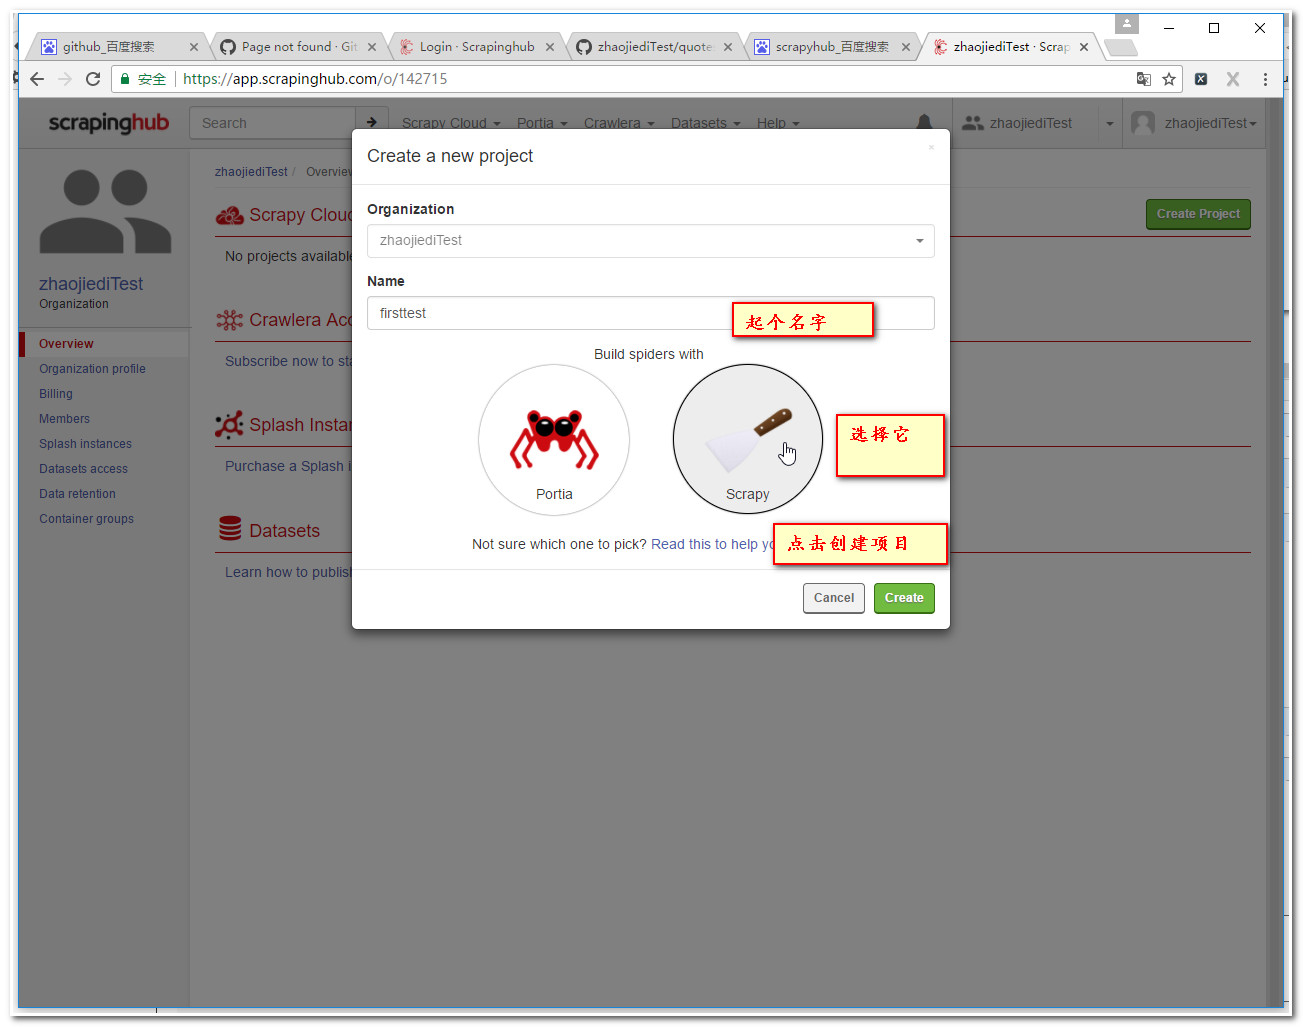
3.4设置工程参数
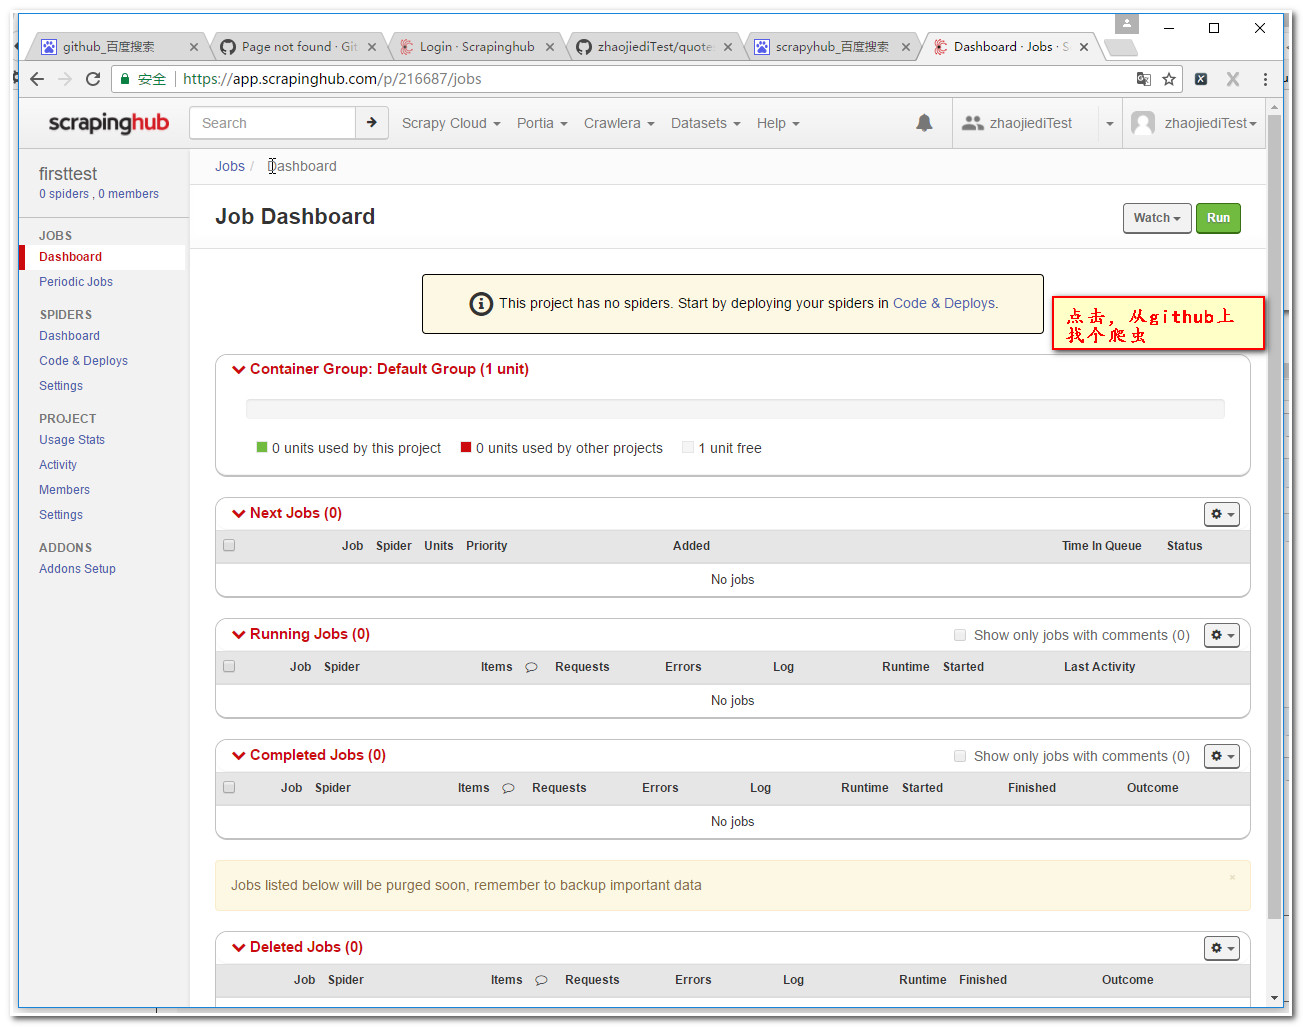
3.5设置工程参数
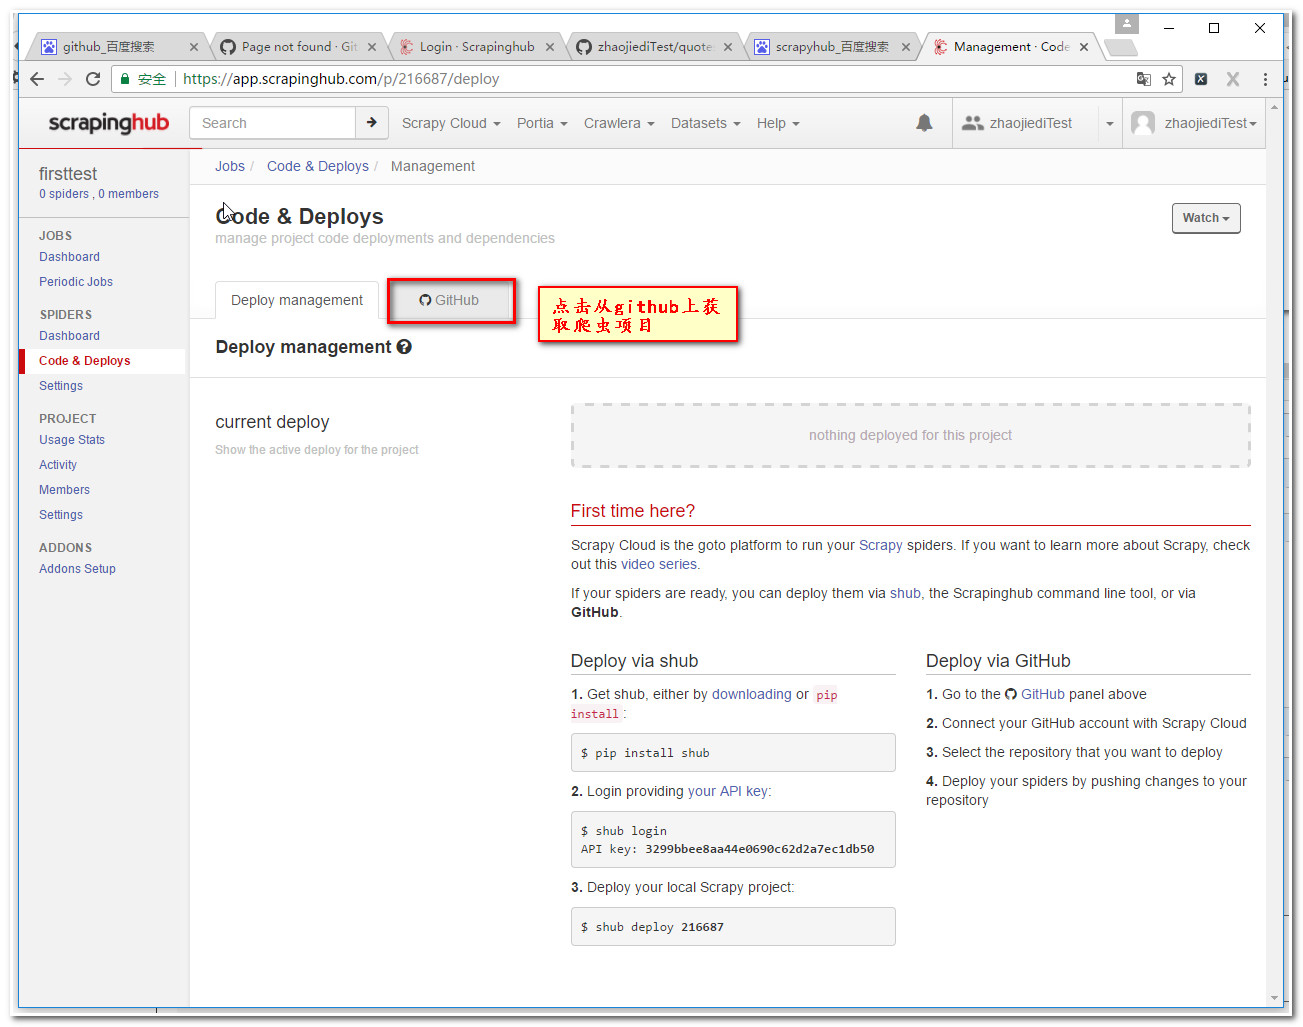
3.6 设置工程参数

3.7 设置工程参数

3.8设置工程参数
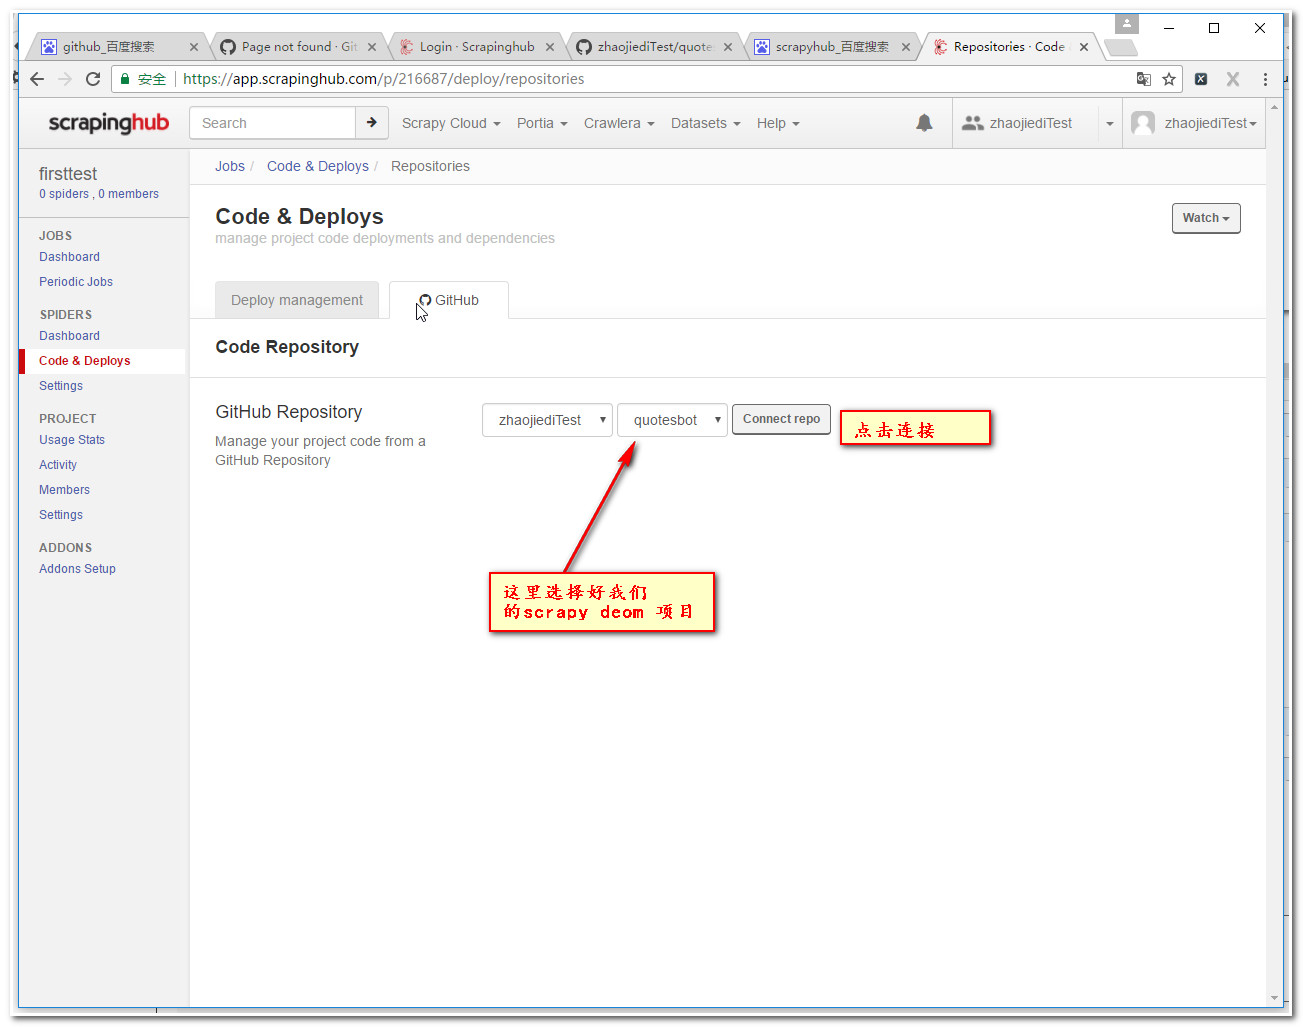
3.9 设置工程参数
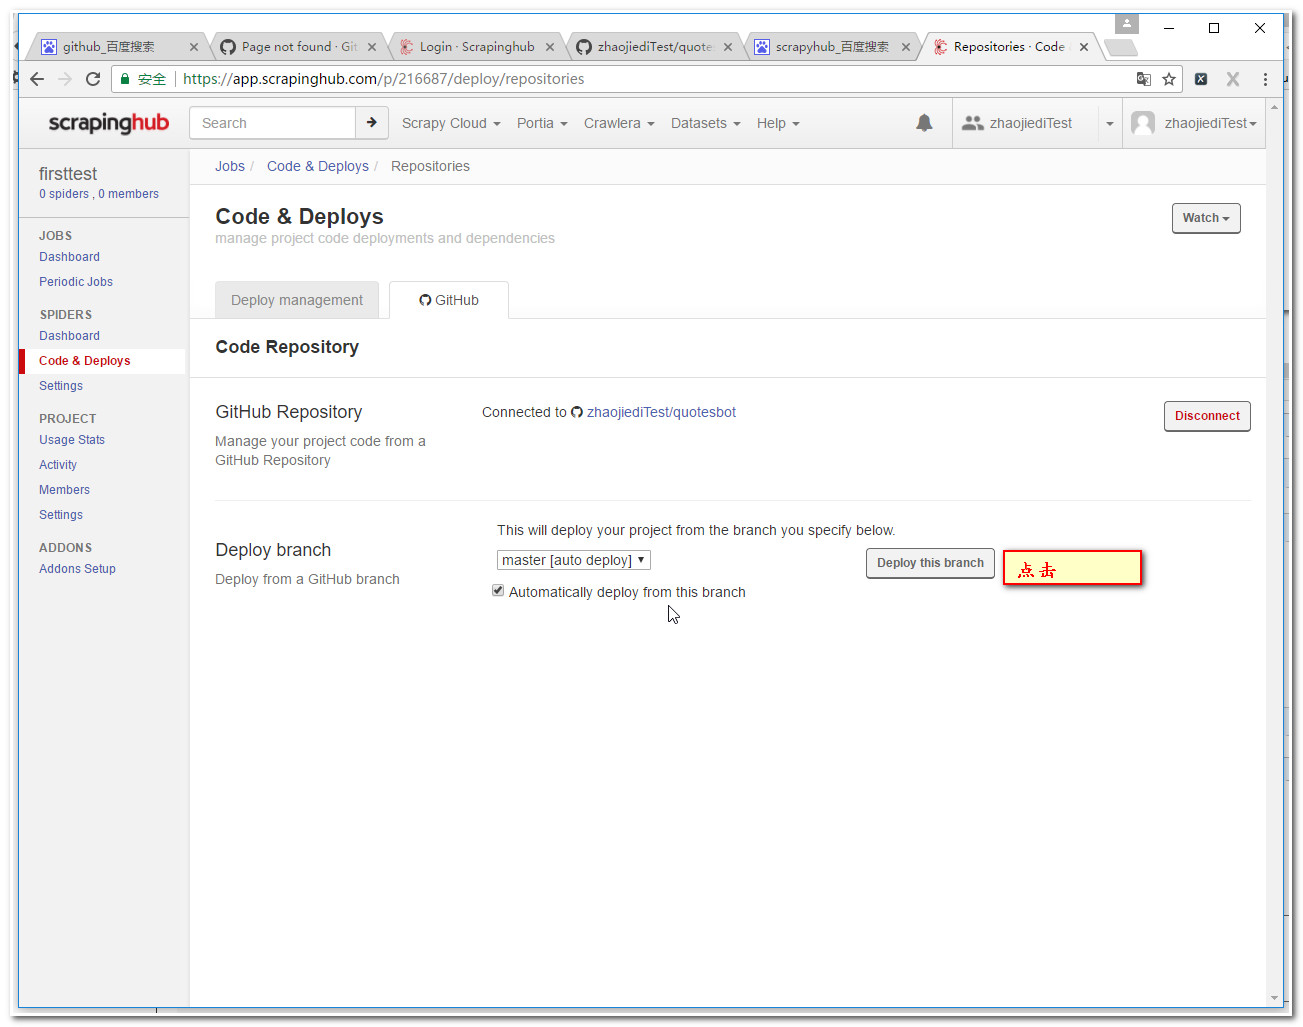
3.10 设置工程参数
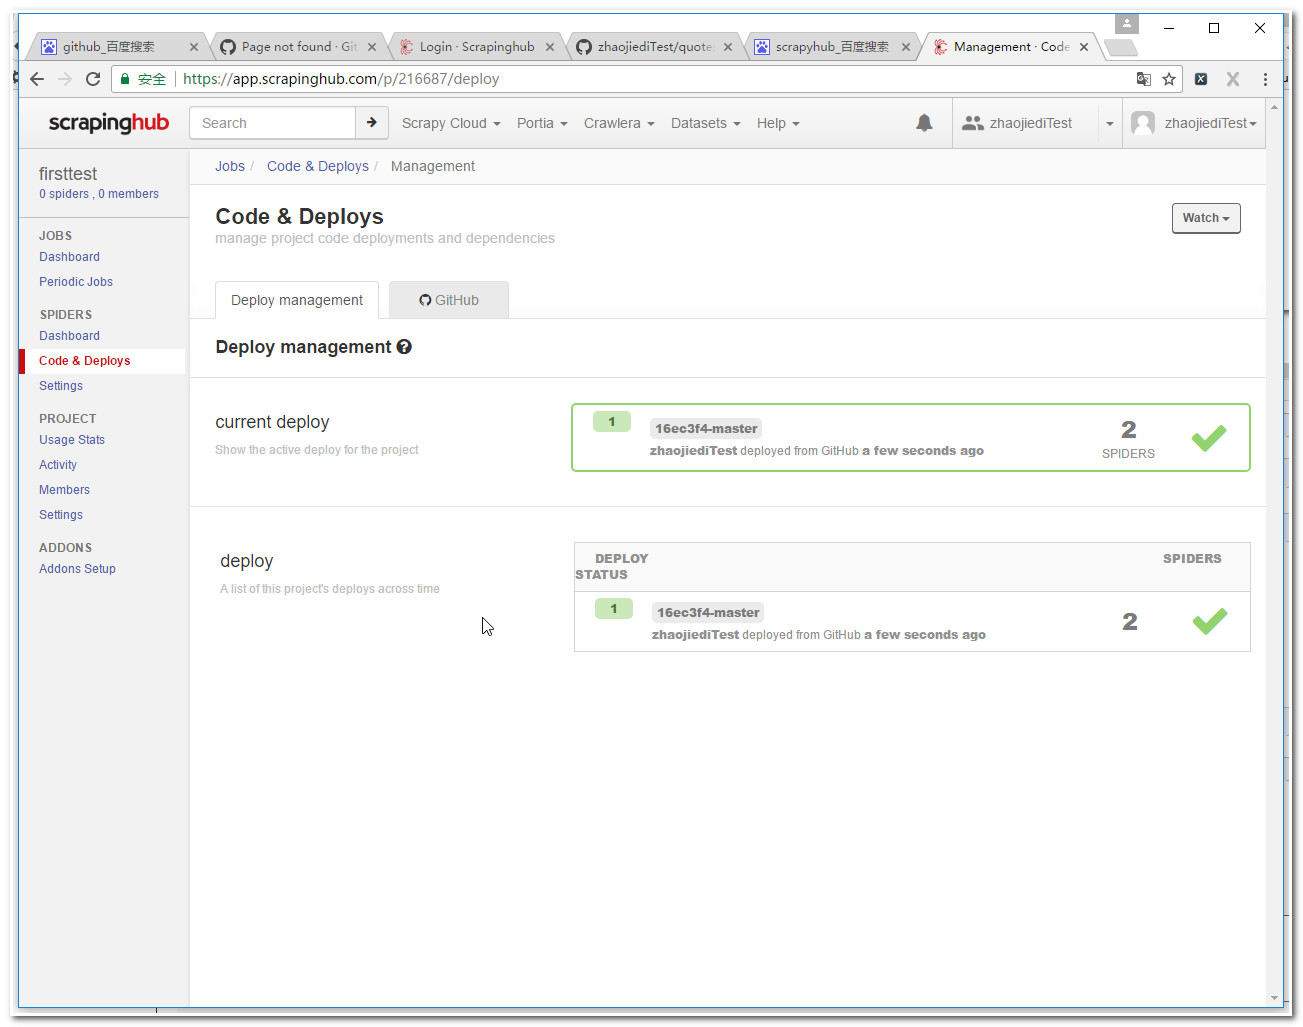
3.11添加调度计划

3.12 设置调度计划

3.13 查看job执行情况
注意: 我们使用的分钟级任务,大概需要等1分钟才有结果。当然你点击右上角的run去手工运行下。

3.14 数据查看和导出

4. 数据导出的api接口
官方的api地址:https://doc.scrapinghub.com/scrapy-cloud.html#scrapycloud
我们这里导出一个job的某次执行结果吧。
导出的url格式items/:project_id[/:spider_id][/:job_id][/:item_no][/:field_name]
如果我们想导出3.14图(页面的url是https://app.scrapinghub.com/p/216687/1/1/items)中的结果,以json格式的形成导出:
可以看出spider_id 就是216687,job_id 就是1 ,item_no 就是1 ,key 我们可以从这个网址查看https://app.scrapinghub.com/account/apikey
所有我们可以访问https://storage.scrapinghub.com/items/216687/1/1?apikey=3299bbee8aa44e0690c62d2a7ec1db50&format=json
scrapy爬虫学习系列三:scrapy部署到scrapyhub上的更多相关文章
- scrapy爬虫学习系列五:图片的抓取和下载
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列四:portia的学习入门
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列二:scrapy简单爬虫样例学习
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列一:scrapy爬虫环境的准备
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列七:scrapy常见问题解决方案
1 常见错误 1.1 错误: ImportError: No module named win32api 官方参考:https://doc.scrapy.org/en/latest/faq.html# ...
- Scrapy爬虫入门系列3 将抓取到的数据存入数据库与验证数据有效性
抓取到的item 会被发送到Item Pipeline进行处理 Item Pipeline常用于 cleansing HTML data validating scraped data (checki ...
- 爬虫学习之基于Scrapy的爬虫自动登录
###概述 在前面两篇(爬虫学习之基于Scrapy的网络爬虫和爬虫学习之简单的网络爬虫)文章中我们通过两个实际的案例,采用不同的方式进行了内容提取.我们对网络爬虫有了一个比较初级的认识,只要发起请求获 ...
- 《Python爬虫学习系列教程》学习笔记
http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多.学习过程中我把一些学习的笔记总结下来,还记录了一些自己 ...
- [转]《Python爬虫学习系列教程》
<Python爬虫学习系列教程>学习笔记 http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多. ...
随机推荐
- IntelliJ IDEA最新破解版2018.3.1(附2018.2.2 完美破解教程)
2018.3.1最新版破解 1.官网下载IDEA 2018.3.1的商业版本点我去下载 2.破解jar下载:JetbrainsIdesCrack-3.4-release-enc.jar点我去下载 3. ...
- PHP常用日期加减计算方法实例
PHP常用日期加减计算方法实例 实例总结了PHP常用日期加减计算方法.分享给大家供大家参考,具体如下: PHP 标准的日期格式 date("Y-m-d H:i:s"); PHP 简 ...
- 20181125第二章节总结part3
数据-元祖 元祖的是可存放多个值,不可变,有顺序的,从左向右编号. 作用是可以用来存储一些不可以更改的配置文件 基本 语法: #创建新元祖 tuple = (,,,,,) #索引,写法同list tu ...
- 最简单的原生js和jquery插件封装
最近在开发过程中用别人的插件有问题,所以研究了一下,怎么封装自己的插件. 如果是制作jquery插件的话.就将下面的extend方法换成 $.extend 方法,其他都一样. 总结一下实现原理: 将 ...
- hashlib模块,shutil,模块 ,,xml 文件解析,configparser,模块,类,什么是类
1 什么是hash hash是一种算法,该算法接受传入的内容,经过运算得到一串hash值 如果把hash算法比喻为一座工厂 那传给hash算法的内容就是原材料 生成的hash值就是生产出的产品 2.为 ...
- iis 和 node express 共用80端口 iisnode 全过程
一.首先下载iisnode.exe https://github.com/tjanczuk/iisnode/wiki/iisnode-releases 链接 安装完毕! 二.打开IIS 7 选中 D ...
- Python 版本管理anaconda
下载安装 下载地址 :anaconda官网 下载后直接命令行安装,默认安装按enter 和yes bash Anaconda3-5.2.0-Linux-x86_64.sh 按照官网上下一步直接用con ...
- jsp页面的地址
1. ${pageContext.request.contextPath}是JSP取得绝对路径的方法,等价于<%=request.getContextPath()%> . 也就是取出部署的 ...
- (BUG记录)记一次与其他系统交互协作时造成的锁表问题
最近两日做公司电信某计费项目时,接收一个银行对账的任务,在完成对账后.电信和银行两方金额一致时需要进行充值.冲正操作保持金额一致.冲正服务是JAVA统一调用Tuxedo服务,这个服务已经是一个稳定可用 ...
- Tensorboard可视化
# -*- coding: utf-8 -*-"""Created on Sun Nov 5 09:29:36 2017 @author: Admin"&quo ...