
Requests 校花网图片爬取
纪念我们闹过的矛盾,只想平淡如水

import requests
import re
url = 'http://www.xiaohuar.com/list-1-%s.html'
for i in range(4):
    temp = url % i
    response =requests.get(temp)
    html = response.text

    #img_urls=re.findall(r"/d/file/\d+/\w+\.jpg",html)#取出图片URL
    #img_urls1 = re.findall(r"https://\w+.*?/\w+/\w+/\w+/\w+/\d+/\w+.*\.jpg", html)#取出图片URL
    #img_names = re.findall(r'<img \w+.*="\d+".*? alt="(.*?)"', html) #取出图片名称
    img=re.findall(r'<img \w+.*="\d+".*? alt="(.*?)".*"(/d/file/\d+/\w+\.jpg)"', html)
    for img_tupian in img:
        img_tupian_urls=img_tupian[-1]#取出图片Url
        img_name=img_tupian[0]#取出名称

        img_response=requests.get("http://www.xiaohuar.com%s" %img_tupian_urls)
        xiaohua=img_response.content
        name=("http://www.xiaohuar.com%s" %img_tupian_urls).split('/')[-1]
        print(houzui)
        with open(img_name +name,'wb') as f:
            f.write(xiaohua)
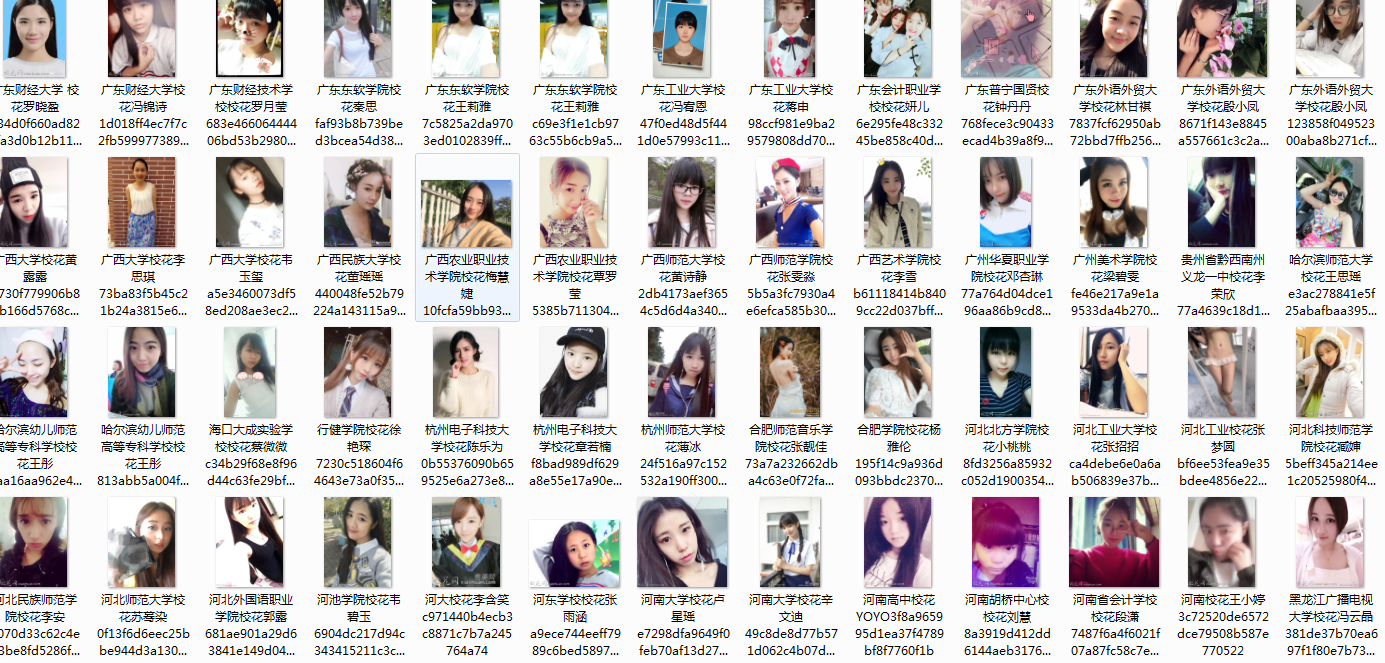
爬取结果还是有点不好看,有空想想把那些乱码去掉
Requests 校花网图片爬取的更多相关文章
- python实战项目 — 爬取 校花网图片
重点: 1. 指定路径创建文件夹,判断是否存在 2. 保存图片文件 # 获得校花网的地址,图片的链接 import re import requests import time import os ...
- Go语言实战-爬取校花网图片
一.目标网站分析 爬取校花网http://www.xiaohuar.com/大学校花所有图片. 经过分析,所有图片分为四个页面,http://www.xiaohuar.com/list-1-0.htm ...
- Scrapy爬虫框架之爬取校花网图片
Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设 ...
- 初识scrapy,美空网图片爬取实战
这俩天研究了下scrapy爬虫框架,遂准备写个爬虫练练手.平时做的较多的事情是浏览图片,对,没错,就是那种艺术照,我骄傲的认为,多看美照一定能提高审美,并且成为一个优雅的程序员.O(∩_∩ ...
- 爬虫实战--基于requests和beautifulsoup的妹子网图片爬取(福利哦!)
#coding=utf-8 import requests from bs4 import BeautifulSoup import os all_url = 'http://www.mzitu.co ...
- day1之校花网小试牛刀
一 利用生成器来完成爬去校花网视频 import requests import re import os import hashlib import time DOWLOAD_PATH=r'D:\D ...
- python爬虫基础应用----爬取校花网视频
一.爬虫简单介绍 爬虫是什么? 爬虫是首先使用模拟浏览器访问网站获取数据,然后通过解析过滤获得有价值的信息,最后保存到到自己库中的程序. 爬虫程序包括哪些模块? python中的爬虫程序主要包括,re ...
- Python 爬虫 爬校花网!!
爬虫:是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本 1.福利来了 校花网 ,首先说为什么要爬这个网站呢,第一这个网站简单爬起来容易不会受到打击,第二呢 你懂得... 1.第一步,需要下载 ...
- Python-爬取校花网视频(单线程和多线程版本)
一.参考文章 python爬虫爬取校花网视频,单线程爬取 爬虫----爬取校花网视频,包含多线程版本 上述两篇文章都是对校花网视频的爬取,由于时间相隔很久了,校花网上的一些视频已经不存在了,因此上述文 ...
随机推荐
- springboot + mybatis
这两天启动了一个新项目因为项目组成员一直都使用的是mybatis,虽然个人比较喜欢jpa这种极简的模式,但是为了项目保持统一性技术选型还是定了 mybatis.到网上找了一下关于spring boot ...
- 21天打造分布式爬虫-Selenium爬取拉钩职位信息(六)
6.1.爬取第一页的职位信息 第一页职位信息 from selenium import webdriver from lxml import etree import re import time c ...
- Android Studio 快捷键总结(OS X)
Action shortcut key 解释 跳转到类 cmd+0 跳转到文件 cmd+shift+0 跳转到函数 cmd+alt+0 最近打开的文件 cmd+e 最近编辑的文件 ...
- 从完整备份恢复单个innodb表
现在大多数同学在线上采取的备份策略都是xtrabackup全备+binlog备份,那么当某天某张表意外的删除那么如何从xtrabackup全备中恢复呢?从mysql 5.6版本开始,支持可移动表空间( ...
- Windows10安装Docker
一.Docker下载安装 一般情况下,我们可以从Docker官网docker下载安装文件,但是官方网站由于众所周知的原因,不是访问慢,就是下载慢.下载docker安装包动不动就要个把小时,真是极大的影 ...
- webpack 学习总结demo
github源码地址 https://github.com/ghshuo/webpack-demo webpack介绍 webpack 是一个现代 JavaScript 应用程序的静态模块打包器(mo ...
- PowerDesigner反向生成物理数据模型
什么是PowerDesigner Power Designer 是Sybase公司的CASE工具集,使用它可以方便地对管理信息系统进行分析设计,它几乎包括了数据库模型设计的全过程.利用Power De ...
- Hash table: why size should be prime?
Question: Possible Duplicate:Why should hash functions use a prime number modulus? Why is it necessa ...
- jsp使用servlet实现文件下载
1.在index.jsp写入如下代码 <a href="demo2">下载</a> 2.在src中创建ServletDemo2类 public class ...
- css清楚浮动的class
.clearfix:after { display: table; visibility: hidden; clear: both; height:; content: ''; } 直接在浮动元素的父 ...