
Lettuce_webdriver 自动化测试
这篇文章主要讲解以下几点:
1. Lettuce_webdriver环境搭建
2. lettuce_webdriver自动化实例讲解
一. lettuce_webdriver环境搭建
搭建lettuce_webdriver,主要需要安装:
1. lettuce
2. lettuce_webdriver
3. nose
这三个包均可以pip安装
因为pip下载地址默认为国外的pypi,下载过慢,很容易timeout,为了解决这一问题,可以pip命令后加上一个参数:--trusted-host pypi.douban.com
例如: pip install lettuce --truted-host pypi.douban.com 这一下载地址会指定为国内豆瓣代理pypi,速度比国外快了不知多少倍
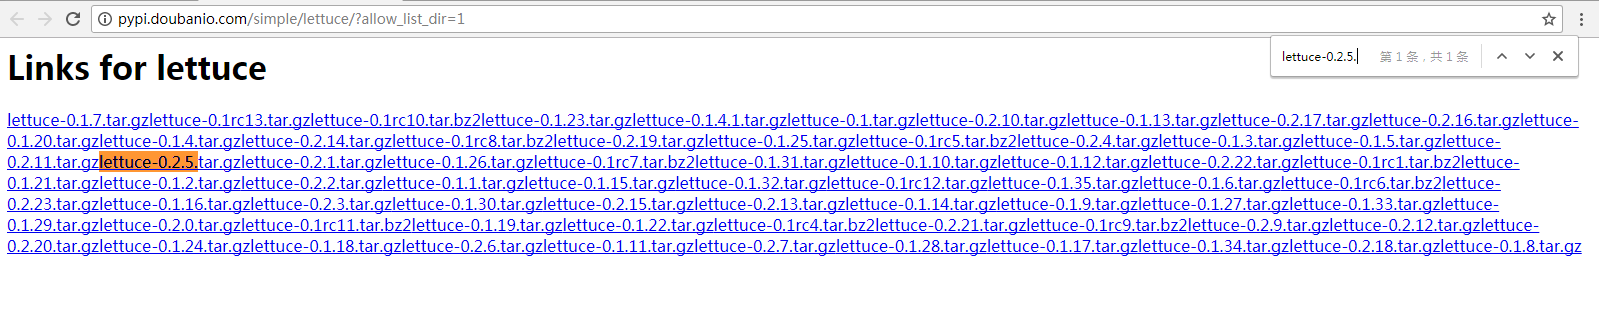
也可以直接访问 http://pypi.douban.com/simple/*** ***替换为你想找的python插件,找到合适的版本下载即可
二. 自动化实例
项目:baidu查找selenium
1. 为了更加深刻的理解接下来学习的lettuce语法,先在这里说一下所需要实现的自动化流程
如果是人工操作,步骤大概如下:
a. 打开浏览器
b. 输入网址www.baidu.com,进入baidu首页
c. 在查询框中输入 selenium
d. 点击查询按钮
f. 等待页面响应
g. 验证结果是否正确
h. 关闭浏览器
相信熟悉selenium的人,已经看出来了,这不就是selenium的自动化执行步骤么
我大声的告诉你,没错! lettuce其实就是数据驱动脚本,而且更加具有可读性
2. 废话不多说,先看个案例,再说理论
创建一个叫features的目录,目录下两个文件 baidu.feature 和 step.py
首先是baidu.feature,内容如下
 Feature: Baidu search test case

   Scenario: search selenium

     Given I go to "http://www.baidu.com/"

     When I fill in field with id "kw" with "selenium"

     And I click id "su" with baidu once

     Then I should see ".//*[@id='1']/h3/a" and value is "Selenium - Web Browser Automation" within 2 second

     Then I close browser
化身翻译狂魔,上面说的是:
第一行 功能:百度查询测试用例
第三行 场景:查询selenium
第四行 给定: 我进入网址“http://www.baidu.com/”
第五行 当: 我用“selenium”一词填充id为“kw”的输入框
第六行 和: 我点击id为“su”的按钮一词
第七行 此时: 我可以在2秒内看到“.//*[@id='1']/h3/a” 的值为“Selenium - Web Browser Automation” //这句太抽象,将就看吧
第八行 此时: 我关闭了浏览器
这就是全部的lettuce代码,简直就是流水帐有没有,英语渣渣表示也能啃懂
现在和之前步骤对比一下,发现几乎是一致的
脚本中的关键字(每行第一个单词)都是代表一定意义的
Feature 代表一个功能,其下可以写很多个场景
Scenario 代表一个场景,其下可以存在很多步骤
Give 代表的是操作步骤
When 代表触发条件,可以代替操作步骤
And 连接两个触发条件
Then 验证结果
接下来是step.py的内容
# coding: utf-8

import time

from lettuce import *

from selenium import webdriver

from lettuce_webdriver.util import AssertContextManager

@before.all

def setup_browser():

    world.browser = webdriver.Firefox()

    world.browser.maximize_window()

@step('I go to "(.*?)"')

def baidu_init(step, baidu_url):

    with AssertContextManager(step):

        print baidu_url

        world.browser.get(baidu_url)

        world.browser.maximize_window()

# 定位输入框输入关键字

@step('I fill in field with id "(.*?)" with "(.*?)"')

def baidu_text(step, field_name, value):

    with AssertContextManager(step):

        text_fied = get_element_by_id(world.browser, field_name)

        text_fied.clear()

        text_fied.send_keys(value)

# 点击“百度一下”按钮

@step('I click id "(.*)?" with baidu once')

def baidu_click(step, field_name):

    with AssertContextManager(step):

        click_field = get_element_by_id(world.browser, field_name)

        click_field.click()

@step('I should see "(.*?)" and value is "(.*?)" within 2 second')

def i_should_see(step, xpath, expect_value):

    time.sleep(2)

    elem = get_element_by_xpath(world.browser, xpath)

    active_value = elem.text

    assert expect_value == active_value, "Got value=%s " % active_value

# 关闭浏览器

@step('I close browser')

def close_browser(step):

    world.browser.close()

def get_element_by_id(browser, attribute):

    xpath = "//input[@id='%s']" % attribute

    elems = browser.find_elements_by_xpath(xpath)

    return elems[0] if elems else False

def get_element_by_xpath(browser, attribute):

    elems = browser.find_elements_by_xpath(attribute)

    return elems[0] if elems else False
代码比较长,不过没关系,首先,你会发现,baidu.feature中每一个步骤都会对应一个step.py中一个方法
且步骤说明写在了装饰器step("")中,唯一的不同就是,有些数据被替换成了奇怪的符号
对于代码来讲,这里的元素定位方法和selenium是相同的,唯一值得注意的就是step装饰器了
当启动这个脚本(如何启动后面说)时,出现的结果如下:

对于每一步,会分为灰/绿两种颜色的执行结果,灰色代表的是baidu.feature的代码行,绿色代表step.py的代码行,最后执行通过
看到这想到了什么?同步是不是,不同的两个文件,因为某种练习,步骤一一对应的进行
这里要说一下运行的原理
首先两个文件是有分工的,feature的工作是指导,即决定执行步骤的顺序,他提供操作需要的数据,但是不决定每一步怎么做;而setup.py文件是将每一步处理好,两部分分工明确,相辅相成
其次,feature如何传送给setup.py数据的呢?很简单,step.py中的每一步都对需要的数据进行了正则匹配,并传入到方法中,比如I go to ...这一步,使用了(.*?)对“http://www.baidu.com/”进行匹配,
并将该值赋值给baidu_init(step, baidu_url)方法中的参数baidu_url;当配置数据2个以上时,在下面的方法中再加一个参数,顺序获取之 例子:I should see这一行
例子介绍完了,说一下运行的事
想运行文件,不能直接python ... ,需要用lettuce命令
保证项目目录下有features目录
.feature文件一定要保证在features目录下,不然会报错
step.py文件可以在项目目录下的任意地方
运行时进入到项目目录,此时你可以看到features目录
直接输入lettuce,开始执行
当然,这只是一个场景,上面也说了,一个功能下可以设置多个场景,怎么办呢,将 Scenario及步骤复制,Scenario和所需的数据变一下就好了
Feature: Baidu search test case

  Scenario: search selenium

    Given I go to "http://www.baidu.com/"

    When I fill in field with id "kw" with "selenium"

    And I click id "su" with baidu once

    Then I should see ".//*[@id='1']/h3/a" and value is "Selenium - Web Browser Automation" within 2 second

    Then I close browser
由于本人太懒,没有换数据,值得注意的是,为了区分场景,场景名一定要取不同
此时你再去运行,会发现执行了三次
好的,本章letture_webdriver攻略就到这里,如果有问题欢迎留言
Lettuce_webdriver 自动化测试的更多相关文章
- lettuce webdriver 自动化测试---玩转BDD
行为驱动开发(BDD),依然高大上的矗立在远方,很少被人问津,一方面是BDD的思想不太容易理解,别一方面BDD的资料并不多.中文的资料就更少了. 之前增写过一篇<python BDD 框架之le ...
- 避免重复造轮子的UI自动化测试框架开发
一懒起来就好久没更新文章了,其实懒也还是因为忙,今年上半年的加班赶上了去年一年的加班,加班不息啊,好了吐槽完就写写一直打算继续的自动化开发 目前各种UI测试框架层出不穷,但是万变不离其宗,驱动PC浏览 ...
- python自动化测试(2)-自动化基本技术原理
python自动化测试(2) 自动化基本技术原理 1 概述 在之前的文章里面提到过:做自动化的首要本领就是要会 透过现象看本质 ,落实到实际的IT工作中就是 透过界面看数据. 掌握上面的这样的本领 ...
- AutoIt实现Webdriver自动化测试文件上传
在运用WebDriver进行自动化测试时,由于WebDriver自身的限制,对于上传文件时Windows弹出的文件选择窗口无法控制,通过在网上查找资料锁定使用AutoIt来控制文件上传窗口. Auto ...
- 手机GUI自动化测试工具选择
(Graphical User Interface,简称 GUI,又称图形用户接口) 我们需要针对自身产品的需求,从中选取一款合适的工具来实现自动化.对于移动客户端GUI的自动化而言,需要保证选取的工 ...
- Splinter学习——不仅仅是自动化测试哦
前两天,想抢购一个小米MIX,结果,一开始抢就没有了.于是想,作为程序猿,总得有点特殊手段吧,比如说一个小脚本.最近在学习python,百度了一下,发现了Splinter这个强大的东东!用了不到两小时 ...
- [转]Android Studio 里搭建自动化测试框架Robotium
Android的自动化测试框架可选择的不多,后来选了Robotium(https://code.google.com/p/robotium/),它的语法及易用性挺像我们用在iOS里的KIF. 官方文档 ...
- 接口自动化测试的"开胃小菜"---简单黑客攻击手段
Web应用系统的小安全漏洞及相应的攻击方式 接口自动化测试的"开胃小菜" 1 写作目的 本文讲述一个简单的利用WebAPI来进行一次基本没有破坏力的“黑客”行为. 主要目的如下 ...
- python自动化测试(4)-使用第三方python库技术实现
python自动化测试(4)-使用第三方python库技术实现 1 概述 关于测试的方法论,都是建立在之前的文章里面提到的观点: 功能测试不建议做自动化 接口测试性价比最高 接口测试可以做自动化 ...
随机推荐
- 如何在前端模版引擎开发中避免使用eval函数
前段时间,想着自己写一个简单的模版引擎,便于自己平时开发demo时使用.于是根据自己对模版引擎的理解,定义自己的模版格式,然后,根据自己定义的格式,编写处理函数,将模版标签中的字符串,解析成可执行的字 ...
- sql求和isnull注意事项
如果不用isnull函数判断则计算出来如果有一列是null 则相加就是null,如 两列:1 null 1+null = nullselect sum(ISNULL(jinE,0)+ISNULL(qi ...
- url地址栏拼接参数写法
<script> function jiedan_do(elm){ var id=$(elm).attr("a"); window.location="__U ...
- 网站优化html关键词代码使用
html的meta标签 .meta标签是内嵌在你网页中的特殊html标签,包含着你有关于你网页的一些隐藏信息.Meat标签的作用是向搜索引擎解释你的网页是有关哪方面信息的.对于高级的搜索引擎来说,ht ...
- php后台模板html拼接写法
public function get_kefu_reply_list(){ $wid=$this->_post('order_id'); if(!$wid){ echo('工单信息获取失败!' ...
- [leetcode-611-Valid Triangle Number]
Given an array consists of non-negative integers, your task is to count the number of triplets chose ...
- Mycat在MySQL主从模式(1主1从)下读写分离和及自动切换模式的验证
实验环境 两台Centos7 MySQL5.7.12 IP地址为:192.168.10.36 192.168.10.37 一台Centos7 Mycat IP地址为:192.168.10.31 一 ...
- Unrooted Tests错误
使用Junit4做测试,遇到如下问题: 条件如下: Eclipse里的Maven工程. 使用JUnit4(这个是否必须不知,反正我的工程用的4) 修改某个Test类里的方法名,或者增加一个Test方法 ...
- MySql单表最大8000W+ 之数据库遇瓶颈记
前言 昨晚救火到两三点,早上七点多醒来,朦胧中醒来发现电脑还开着,赶紧爬起来看昨晚执行的SQL命令结果.由于昨晚升级了阿里云的RDS,等了将近两个小时 还在 升降级中,早上阿里云那边回复升级过程中出现 ...
- java 对象与json互转
有时为了项目需求,会将对象数据转换成json数据,以下是个人根据项目需求实现的方法. 项目中需要将数据格式: [{ "node": "0", "ind ...