
spark集群搭建(三台虚拟机)——hadoop集群搭建(2)
!!!该系列使用三台虚拟机搭建一个完整的spark集群,集群环境如下:
virtualBox5.2、Ubuntu14.04、securecrt7.3.6_x64英文版(连接虚拟机)
jdk1.7.0、hadoop2.6.5、zookeeper3.4.5、Scala2.12.6、kafka_2.9.2-0.8.1、park1.3.1-bin-hadoop2.6
前面搭建了spark集群需要的系统环境,本文在前文基础上搭建hadoop集群
一、配置几个配置文件
hadoop的下载和配置只需在spark1上操作,然后拷贝到另外两台机器上即可,下面的配置均在spark1上进行
$ cd /usr/local/bigdata/hadoop  #进入hadoop安装目录
$ cd ./etc/hadoop
1、core-site.xml
$ vim core-site.xml
添加如下,指定namenode的地址:
<configuration>

    <property>

        <name>fs.default.name</name>

        <value>hdfs://spark1:9000</value>

    </property>

</configuration>
2、hdfs-site.xml
$ vim hdfs-site.xml
<configuration>

    <property>

        <name>dfs.name.dir</name>

        <value>/usr/local/hadoop/data/namenode</value>

    </property>

    <property>

        <name>dfs.data.dir</name>

        <value>/usr/local/hadoop/data/datanode</value>

    </property>

     <property>

        <name>dfs.tmp.dir</name>

        <value>/usr/local/hadoop/data/tmp</value>

     </property>

    <property>

        <name>dfs.replication</name>

        <value>3</value>

    </property>

</configuration>
3、mapred-site.xml,指定hadoop运行在yarn之上
$ mv mapred-site.xml.template mapred-site.xml
$ vim mapred-site.xml
<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

</configuration>
4、yarn-site.xml
$ vim yarn-site.xml
<configuration>

    <property>

        <name>yarn.resourcemanager.hostname</name>

        <value>spark1</value>

    </property>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

</configuration>
5、slaves
$ vim slaves
spark1

spark2

spark3
6、hadoop-env.sh
vim hadoop-env.sh
输入jdk完整路径
export JAVA_HOME=/usr/local/bigdata/jdk
二、另外两台机器
使用拷贝命令将hadoop拷贝过去
$ cd /usr/local/bigdata

$ scp -r hadoop root@spark2:/usr/local/bigdata
$ scp -r hadoop root@spark3:/usr/local/bigdata
三、配置hadoop环境变量,三台机器均需要配置
export HADOOP_HOME=/usr/local/bigdata/hadoop

export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin

export HADOOP_COMMOM_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native
四、启动hadoop集群
格式化namenode
$ hdfs namenode -format
$ start-dfs.sh
此时三台机器启动如下,才算成功
spark1
root@spark1:/usr/local/bigdata/hadoop/etc/hadoop# jps

4275 Jps

3859 NameNode

4120 SecondaryNameNode

3976 DataNode
spark2
root@spark2:/usr/local/bigdata/hadoop/etc/hadoop# jps

6546 DataNode

6612 Jps
spark3
root@spark3:/usr/local/bigdata/hadoop/etc/hadoop# jps

4965 DataNode

5031 Jps
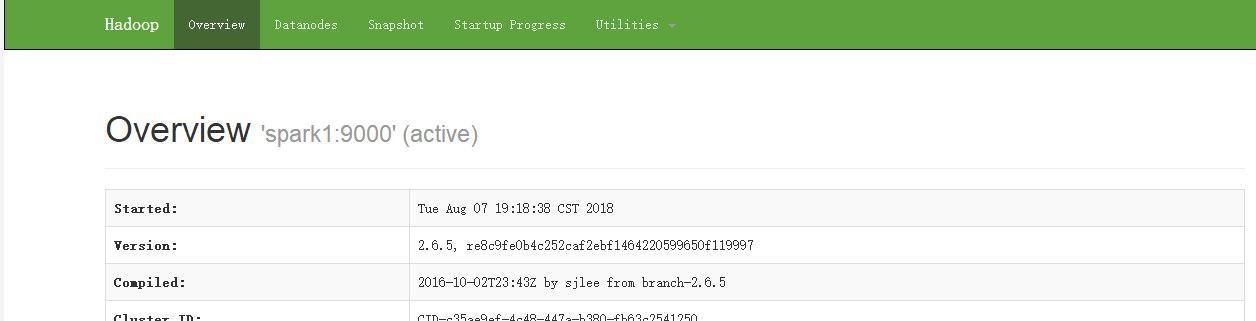
进入浏览器,访问http://spark1:50070
五、启动yarn集群
$ start-yarn.sh
此时spark1
root@spark1:/usr/local/bigdata/hadoop/etc/hadoop# jps
3859 NameNode
4803 Jps
4120 SecondaryNameNode
3976 DataNode
4443 ResourceManager
4365 NodeManager
spark2
root@spark2:/usr/local/bigdata/hadoop/etc/hadoop# jps
6546 DataNode
6947 Jps
6771 NodeManager
spark3
root@spark3:/usr/local/bigdata/hadoop/etc/hadoop# jps
5249 Jps
4965 DataNode
5096 NodeManager
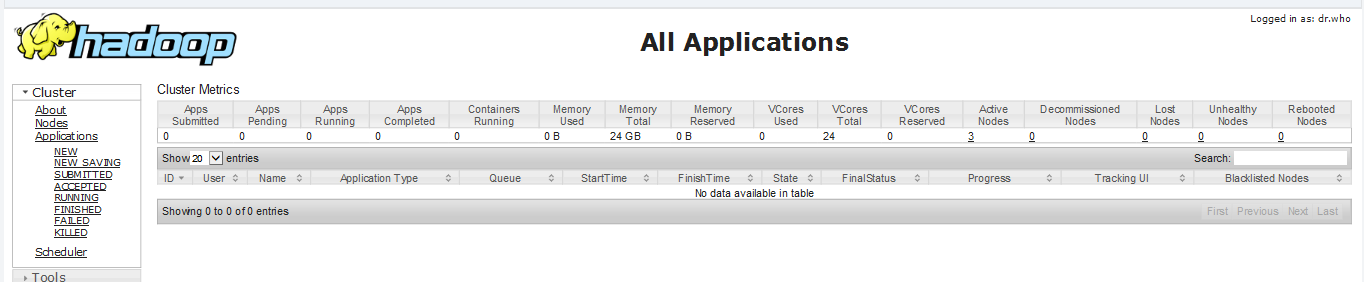
浏览器输入spark1:8088
spark集群搭建(三台虚拟机)——hadoop集群搭建(2)的更多相关文章
- Centos 7下VMware三台虚拟机Hadoop集群初体验
一.下载并安装Centos 7 传送门:https://www.centos.org/download/ 注:下载DVD ISO镜像 这里详解一下VMware安装中的两个过程 网卡配置 是Add ...
- 基于Docker快速搭建多节点Hadoop集群--已验证
Docker最核心的特性之一,就是能够将任何应用包括Hadoop打包到Docker镜像中.这篇教程介绍了利用Docker在单机上快速搭建多节点 Hadoop集群的详细步骤.作者在发现目前的Hadoop ...
- Hadoop4 利用VMware搭建自己的hadoop集群
前言: 前段时间自己学习如何部署伪分布式模式的hadoop环境,之前由于工作比较忙,学习的进度停滞了一段时间,所以今天抽出时间把最近学习的成果和大家分享一下. 本文要介绍的是如 ...
- 搭建简单的hadoop集群(译文)
本文翻译翻译自http://hadoop.apache.org/docs/r2.8.0/hadoop-project-dist/hadoop-common/ClusterSetup.html 具体的实 ...
- 在 Linux 服务器上搭建和配置 Hadoop 集群
实验条件:3台centos服务器,jdk版本1.8.0,Hadoop 版本2.8.0 注:hadoop安装和搭建过程中都是在用户lb的home目录下,master的主机名为host98,slave的主 ...
- Spark应用(app jar)发布到Hadoop集群的过程
记录了Spark,Hadoop集群的开启,关闭,以及Spark应用提交到Hadoop集群的过程,通过web端监控运行状态. 1.绝对路径开启集群 (每次集群重启,默认配置的hadoop集群中tmp文件 ...
- 虚拟机hadoop集群搭建
hadoop tar -xvf hadoop-2.7.3.tar.gz mv hadoop-2.7.3 hadoop 在hadoop根目录创建目录 hadoop/hdfs hadoop/hdfs/tm ...
- 搭建ubuntu版hadoop集群
用到的工具:VMware.hadoop-2.7.2.tar.jdk-8u65-linux-x64.tar.ubuntu-16.04-desktop-amd64.iso 1. 在VMware上安装ub ...
- Hadoop入门第四篇:手动搭建自己的hadoop小集群
前言 好几天没有更新了,本来是应该先写HDFS的相关内容,但是考虑到HDFS是我们后面所有学习的基础,而我只是简单的了解了一下而已,后面准备好好整理HDFS再写这块.所以大家在阅读这篇文章之前,请先了 ...
- Spark集群环境搭建——Hadoop集群环境搭建
Spark其实是Hadoop生态圈的一部分,需要用到Hadoop的HDFS.YARN等组件. 为了方便我们的使用,Spark官方已经为我们将Hadoop与scala组件集成到spark里的安装包,解压 ...
随机推荐
- lcx 内网转发
把放置到已经控制的内网主机 执行 内网主机输入命令lcx.exe -slave 外网ip 外网端口 内网ip 内网端口lcx.exe -slave 30.1.85.55 2222 127.0.0.1 ...
- MySQL常用sql语句-----数据表的增删改操作
常用sql操作如下: 1.查看当前数据库的所有表 show tables; 2.创建表 create table stu(sid int,sname char(20),sage int default ...
- 实用Linux控制台命令
实用Linux控制台命令 screen 例如用Xshell连接 服务器 screen -ls 列出当前用户所有的screen screen 回车直接创建新的screen screen -S scree ...
- C语言算法动态规划板子题汇总
本篇博客仅为对动态规划基础问题的状态转移方程进行求解,然后给出对应的注释代码,有关题目的具体内容可在算法导论或网络上进行查看 目录 1.钢管切割(最小值) 2.两条流水线调度 3.多条流水线调度 4. ...
- Java基础(二十三)集合(6)Map集合
Map接口作为Java集合框架中的第二类接口,其子接口为SortedMap接口,SortedMap接口的子接口为NavigableMap接口. 实现了Map接口具体类有:HashMap(子类Linke ...
- BOOL,int,float,指针变量 与“零值”比较的if语句
分别给出BOOL,int,float,指针变量 与“零值”比较的 if 语句(假设变量名为var) 解答: BOOL型变量:if(!var) int型变量: if(var==0) float型变量: ...
- VB.NET 与 SAP RFC连接问题点
与SAP RFC连接,电脑上必须要安装SAP软件,否则会报错ActiveX 输入工单号,无法带出SAP内接口RFC信息. 确认原因为:RFC接口需求的工单参数需要在前面加两位00,例如:1000541 ...
- st表、树状数组与线段树 笔记与思路整理
已更新(2/3):st表.树状数组 st表.树状数组与线段树是三种比较高级的数据结构,大多数操作时间复杂度为O(log n),用来处理一些RMQ问题或类似的数列区间处理问题. 一.ST表(Sparse ...
- Jquery+CSS在不使用Checked的情况下实现当前选中行样式变化
之前在做一个当前选中行样式变化时发现网上很多方法都是利用在行内添加checked,然后通过checked是否选中来判断当前选中行的位置,今天就整理了一个不需要在行内添加其他按钮直接通过变化当前选中行的 ...
- 《STL源码剖析》——List
List list位于头文件<<stl_list.h>>中 list是sequence containers中的一种 1 List的基本架构 list的基本结构的UML关系图如 ...