
java 如何爬取百度百科词条内容(java如何使用webmagic爬取百度词条)
这是老师所布置的作业
说一下我这里的爬去并非能把百度词条上的内容一字不漏的取下来(而是它分享链接的一个主要内容概括...)(他的主要内容我爬不到 也不想去研究大家有好办法可以call me)
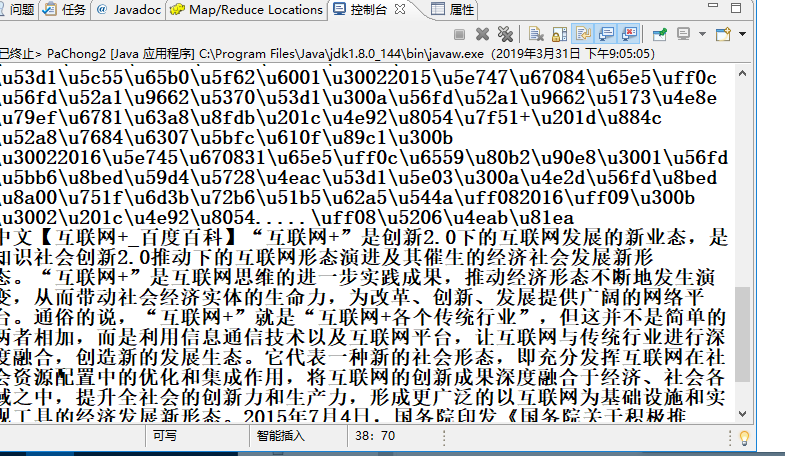
例如 互联网+这个词汇 我这里爬的解释为
中文【互联网+_百度百科】“互联网+”是创新2.0下的互联网发展的新业态,是知识社会创新2.0推动下的互联网形态演进及其催生的经济社会发展新形态。“互联网+”是互联网思维的进一步实践成果,推动经济形态不断地发生演变,从而带动社会经济实体的生命力,为改革、创新、发展提供广阔的网络平台。通俗的说,“互联网+”就是“互联网+各个传统行业”,但这并不是简单的两者相加,而是利用信息通信技术以及互联网平台,让互联网与传统行业进行深度融合,创造新的发展生态。它代表一种新的社会形态,即充分发挥互联网在社会资源配置中的优化和集成作用,将互联网的创新成果深度融合于经济、社会各域之中,提升全社会的创新力和生产力,形成更广泛的以互联网为基础设施和实现工具的经济发展新形态。2015年7月4日,国务院印发《国务院关于积极推进“互联网+”行动的指导意见》。2016年5月31日,教育部、国家语委在京发布《中国语言生活状况报告(2016)》。“互联.....(分享自
而不同于百度词条的长篇大论
webmagic 使用不再赘述 导入包实现PageProcessor接口
代码如下
 package com.test;

 import java.util.regex.Matcher;

 import java.util.regex.Pattern;

 import us.codecraft.webmagic.Page;

 import us.codecraft.webmagic.Site;

 import us.codecraft.webmagic.Spider;

 import us.codecraft.webmagic.pipeline.ConsolePipeline;

 import us.codecraft.webmagic.processor.PageProcessor;

 /**

  * @author 信1605-1 hjj

  *

  */

 public class PaChong2 implements PageProcessor{

     private Site site = Site.me()

             .setUserAgent("Mozilla/5.0 (Windows NT 10.0; WOW64; rv:56.0) Gecko/20100101 Firefox/56.0")

             .setRetryTimes(3)

             .setSleepTime(1000);

     @Override

     public Site getSite() {

         // TODO Auto-generated method stub

         return site;

     }

     public static void main(String[] args) {

         Spider.create(new PaChong2())

         .addUrl("https://baike.baidu.com/item/互联网+")//这里填写你第一次要爬的网址(后面直接跟你要查的词汇名称把互联网改了就行)

         .addPipeline(new ConsolePipeline())

         .thread(15)

         .run();

 }

     @Override

     public void process(Page page) {

     //这段代码重复获取

         System.out.println(mySplitBaiDu(page));

         System.out.println("中文"+unicodeToString(mySplitBaiDu(page)));

     }

     //爬取百度解释  为unicode文本

         public static String mySplitBaiDu(Page page)

         {

            String wordname=page.getUrl().toString().split("item/")[1];

             String basehtml=page.getJson().toString();

             String content =basehtml.split("bdText: \"")[1].split("@")[0];

             return content;

         }

         //unicode 转中文

         public static String unicodeToString(String str) {

             Pattern pattern = Pattern.compile("(\\\\u(\\p{XDigit}{4}))");

             Matcher matcher = pattern.matcher(str);

             char ch;

             while (matcher.find()) {

                 //group 6728

                 String group = matcher.group(2);

                 //ch:'木' 26408

                 ch = (char) Integer.parseInt(group, 16);

                 //group1 \u6728

                 String group1 = matcher.group(1);

                 str = str.replace(group1, ch + "");

             }

             return str;

         }

 }
结果
java 如何爬取百度百科词条内容(java如何使用webmagic爬取百度词条)的更多相关文章
- 爬虫实战(一) 用Python爬取百度百科
最近博主遇到这样一个需求:当用户输入一个词语时,返回这个词语的解释 我的第一个想法是做一个数据库,把常用的词语和词语的解释放到数据库里面,当用户查询时直接读取数据库结果 但是自己又没有心思做这样一个数 ...
- python简单爬虫 用beautifulsoup爬取百度百科词条
目标:爬取“湖南大学”百科词条并处理数据 需要获取的数据: 源代码: <div class="basic-info cmn-clearfix"> <dl clas ...
- python简单爬虫爬取百度百科python词条网页
目标分析:目标:百度百科python词条相关词条网页 - 标题和简介 入口页:https://baike.baidu.com/item/Python/407313 URL格式: - 词条页面URL:/ ...
- R语言爬虫:爬取百度百科词条
抓取目标:抓取花儿与少年的百度百科中成员信息 url <- "http://baike.baidu.com/item/%E8%8A%B1%E5%84%BF%E4%B8%8E%E5%B0 ...
- Python3爬取百度百科(配合PHP)
用PHP写了一个网页,可以获取百度百科词条.源代码已分享至github:https://github.com/1049451037/xiaobaike/tree/master 那么通过Python来爬 ...
- Python 爬虫实例(爬百度百科词条)
爬虫是一个自动提取网页的程序,它为搜索引擎从万维网上下载网页,是搜索引擎的重要组成.爬虫从一个或若干初始网页的URL开始,获得初始网页上的URL,在抓取网页的过程中,不断从当前页面上抽取新的URL放入 ...
- python爬虫—爬取百度百科数据
爬虫框架:开发平台 centos6.7 根据慕课网爬虫教程编写代码 片区百度百科url,标题,内容 分为4个模块:html_downloader.py 下载器 html_outputer.py 爬取数 ...
- python_爬百度百科词条
如何爬取? 明确目标:爬取百度百科,定初始百度词条:python,初始URL:http://baike.baidu.com/item/Python,爬取数据量为1000条,值爬取简介,标题,和简介中u ...
- Python开发简单爬虫(二)---爬取百度百科页面数据
一.开发爬虫的步骤 1.确定目标抓取策略: 打开目标页面,通过右键审查元素确定网页的url格式.数据格式.和网页编码形式. ①先看url的格式, F12观察一下链接的形式;② 再看目标文本信息的标签格 ...
随机推荐
- NB-IOT学习
一 信号穿透力强,覆盖面广(基站少成本低).低功耗(eDRX/PSM省电技术).适合小流量时延要求不高(10s.) 二 主要芯片: 华为:Hi2110/2115,基于此的模组有:中移的M5310 移芯 ...
- Django manager 命令笔记
1. 新建app startapp your_app_name 2. 删除app migrate your_app_name zero 此外还需要删除整个App文件夹,并在settings.py的In ...
- uniGUI 应用程序体系结构(11)
下图表示 uniGUI 服务器的内部结构. 每个 uniGUI 服务器都有一个ServerModule的副本, 每台服务器创建一次, 同时根据用户活动动态创建和销毁多个Session. uniGUI ...
- 140、Java内部类之实例化内部类对象
01.代码如下: package TIANPAN; class Outer { // 外部类 private String msg = "Hello World !"; class ...
- [转]网络协议-redis协议
Redis 通信协议(protocol) 本文档翻译自: http://redis.io/topics/protocol . Redis 协议在以下三个目标之间进行折中: 易于实现 可以高效地被计算机 ...
- 代码审计(1):sql注入漏洞
挖掘经验:sql注入经常出现在登录界面.获取HTTP请求头.订单处理等地方.而登录界面的注入现在来说大多是发生在HTTP头里面的client-ip和x-forward-for,一般用来记录登录的ip地 ...
- 【剑指Offer面试编程题】题目1388:跳台阶--九度OJ
题目描述: 一只青蛙一次可以跳上1级台阶,也可以跳上2级.求该青蛙跳上一个n级的台阶总共有多少种跳法. 输入: 输入可能包含多个测试样例,对于每个测试案例, 输入包括一个整数n(1<=n< ...
- github 创建分支
1.github网站创建 参考:https://www.cnblogs.com/autoXingJY/p/9004724.html 2.命令更新 参考:https://www.cnblogs.com/ ...
- [ERROR] error: error while loading <root>, error in opening zip file error: scala.reflect.internal.MissingRequirementError: object scala.runtime in compiler mirror not found.
在家编译一个Apache的开源项目,在编译时遇到错误如下: error: error while loading <root>, error in opening zip file [ER ...
- HTML有2种路径的写法:绝对路径和相对路径
HTML有2种路径的写法:绝对路径和相对路径 2016年11月30日 17:51:20 Bolon0708 阅读数 21775 版权声明:本文为博主原创文章,未经博主允许不得转载. https:/ ...