
python简单爬虫爬取百度百科python词条网页
目标分析:
目标:百度百科python词条相关词条网页 - 标题和简介
入口页:https://baike.baidu.com/item/Python/407313
URL格式:
- 词条页面URL:/item/xxxx
数据格式:
- 标题:
<dd class="lemmaWgt-lemmaTitle-title"><h1>***</h1></dd>
- 简介:
<div class="lemma-summary">***</div>
页面编码:utf-8
爬虫主入口文件
spider_main.py
# coding:utf-8

import url_manager

import html_downloader

import html_parser

import html_outputer

class SpiderMain(object):

    def __init__(self):

        # url管理器

        self.urls = url_manager.UrlManager()

        # 下载器

        self.downloader = html_downloader.HtmlDownloader()

        # 解析器

        self.parser = html_parser.HtmlParser()

        # 输出控制器

        self.outputer = html_outputer.HtmlOutputer()

    def craw(self, root_url):

        # 记录当前爬取的是第几个url

        count = 1

        self.urls.add_new_url(root_url)

        # 如果有待爬取的url就继续while循环

        '''

        while self.urls.has_new_url():

            try:

                new_url = self.urls.get_new_url()

                print 'craw %d : %s' % (count, new_url)

                # 下载url页面

                html_cont = self.downloader.download(new_url)

                # 进行url解析并获取url的数据

                new_urls, new_data = self.parser.parse(new_url, html_cont)

                # url解析及数据搜集

                self.urls.add_new_urls(new_urls)

                self.outputer.collect_data(new_data)

                if count >= 1000:

                    break

                count = count + 1

            except Exception as e:

                print 'craw failed'

                print e

        '''

        while self.urls.has_new_url():

            new_url = self.urls.get_new_url()

            print 'craw %d : %s' % (count, new_url)

            # 下载url页面

            html_cont = self.downloader.download(new_url)

            # print html_cont

            # 进行url解析并获取url的数据

            new_urls, new_data = self.parser.parse(new_url, html_cont)

            # url解析及数据搜集

            self.urls.add_new_urls(new_urls)

            self.outputer.collect_data(new_data)

            if count >= 10:

                break

            count = count + 1

        # 输出到指定页面

        self.outputer.output_html()

if __name__ == "__main__":

    root_url = "https://baike.baidu.com/item/Python/407313"

    obj_spider = SpiderMain()

    obj_spider.craw(root_url)
网页管理器
url_manager.py
# coding:utf-8

class UrlManager(object):

    def __init__(self):

        # 要爬取的url

        self.new_urls = set()

        # 爬取过的url

        self.old_urls = set()

    def add_new_url(self, url):

        if url is None:

            return

        # 如果url不在要爬取的url里面也不在爬取过的url里面就添加进来

        if url not in self.new_urls and url not in self.old_urls:

            self.new_urls.add(url)

    def add_new_urls(self, urls):

        if urls is None or len(urls) == 0:

            return

        for url in urls:

            self.add_new_url(url)

    def has_new_url(self):

        return len(self.new_urls) != 0

    def get_new_url(self):

        new_url = self.new_urls.pop()

        self.old_urls.add(new_url)

        return new_url
网页下载器
html_downloader.py
# coding:utf-8

import urllib2

class HtmlDownloader(object):

    def download(self, url):

        if url is None:

            return None

        response = urllib2.urlopen(url)

        if response.getcode() != 200:

            return None

        return response.read()
网页分析器
html_parser.py
# coding:utf-8

from bs4 import BeautifulSoup

import re

import urlparse

class HtmlParser(object):

    def _get_new_urls(self, page_url, soup):

        # 得到所有的词条url

        links = soup.find_all('a', href=re.compile(r"/item/.*"))

        # print links

        new_urls = set()

        for link in links:

            new_url = link['href']

            new_full_url = urlparse.urljoin(page_url, new_url)

            new_urls.add(new_full_url)

        return new_urls

    def _get_new_data(self, page_url, soup):

        res_data = {}

        # url

        res_data['url'] = page_url

        # <dd class="lemmaWgt-lemmaTitle-title">

        # <h1>Python</h1>

        title_node = soup.find('dd', class_='lemmaWgt-lemmaTitle-title').find("h1")

        res_data['title'] = title_node.get_text()

        # <div class="lemma-summary" label-module="lemmaSummary">

        summary_node = soup.find('div', class_="lemma-summary")

        res_data['summary'] = summary_node.get_text()

        return res_data

    def parse(self, page_url, html_cont):

        if page_url is None or html_cont is None:

            return

        soup = BeautifulSoup(html_cont, 'html.parser', from_encoding='utf-8')

        new_urls = self._get_new_urls(page_url, soup)

        new_data = self._get_new_data(page_url, soup)

        return new_urls,new_data
网页输出器
html_outputer.py
# coding:utf-8

class HtmlOutputer(object):

    def __init__(self):

        self.datas = []

    def collect_data(self, data):

        if data is None:

            return

        self.datas.append(data)

    # ascii

    def output_html(self):

        fout = open('output.html', 'w')

        fout.write("<html>")

        fout.write("<body>")

        fout.write("<table>")

        for data in self.datas:

            fout.write("<tr>")

            fout.write("<td>%s</td>" % data['url'])

            fout.write("<td>%s</td>" % data['title'].encode('utf-8'))

            fout.write("<td>%s</td>" % data['summary'].encode('utf-8'))

            fout.write("</tr>")

        fout.write("/table")

        fout.write("/body")

        fout.write("/html")
运行代码:
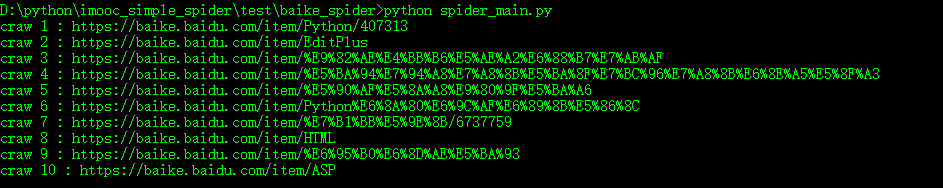
结果页面

python简单爬虫爬取百度百科python词条网页的更多相关文章
- python爬虫—爬取百度百科数据
爬虫框架:开发平台 centos6.7 根据慕课网爬虫教程编写代码 片区百度百科url,标题,内容 分为4个模块:html_downloader.py 下载器 html_outputer.py 爬取数 ...
- Python简易爬虫爬取百度贴吧图片
通过python 来实现这样一个简单的爬虫功能,把我们想要的图片爬取到本地.(Python版本为3.6.0) 一.获取整个页面数据 def getHtml(url): page=urllib.requ ...
- 【Python】Python简易爬虫爬取百度贴吧图片
通过python 来实现这样一个简单的爬虫功能,把我们想要的图片爬取到本地.(Python版本为3.6.0) 一.获取整个页面数据 def getHtml(url): page=urllib.requ ...
- 慕课爬虫实战 爬取百度百科Python词条相关1000个页面数据
http://www.imooc.com/learn/563 spider_main.py #!/usr/bin/python # coding=utf-8 #from baike_spider im ...
- Python——爬取百度百科关键词1000个相关网页
Python简单爬虫——爬取百度百科关键词1000个相关网页——标题和简介 网站爬虫由浅入深:慢慢来 分析: 链接的URL分析: 数据格式: 爬虫基本架构模型: 本爬虫架构: 源代码: # codin ...
- Python开发简单爬虫(二)---爬取百度百科页面数据
一.开发爬虫的步骤 1.确定目标抓取策略: 打开目标页面,通过右键审查元素确定网页的url格式.数据格式.和网页编码形式. ①先看url的格式, F12观察一下链接的形式;② 再看目标文本信息的标签格 ...
- 爬虫实战(一) 用Python爬取百度百科
最近博主遇到这样一个需求:当用户输入一个词语时,返回这个词语的解释 我的第一个想法是做一个数据库,把常用的词语和词语的解释放到数据库里面,当用户查询时直接读取数据库结果 但是自己又没有心思做这样一个数 ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
随机推荐
- 使用命令把类打成jar包
测试用类 public class Hello { public static void main(String[] args) { System.out.println("hello wo ...
- 参考手册(html css)
HTML CSS DOM XML DOM XML DOM Document JavaScript JavaScript RegExp JSP
- now code——小a和黄金街道(欧拉函数和快速幂模板)
小a和小b来到了一条布满了黄金的街道上.它们想要带几块黄金回去,然而这里的城管担心他们拿走的太多,于是要求小a和小b通过做一个游戏来决定最后得到的黄金的数量.游戏规则是这样的:假设道路长度为米(左端点 ...
- Mol Cell Proteomics. |廖文丽| 阿尔兹海默症临床前期的脑脊液中突触蛋白的变化先于神经变性标志物
大家好,本周分享的是发表在Molecular & Cellular Proteomics. 上的一篇关于阿尔兹海默病临床前期生物标志物鉴定的文章,题目是Changes in synaptic ...
- extern使用方法总结!(转)
extern 在源文件A里定义的函数,在其它源文件里是看不见的(即不能访问).为了在源文件B里能调用这个函数,应该在B的头部加上一个外部声明: extern 函数原型: 这样,在源文件B里也可以调 ...
- 14.PTD与的基址
0xC0300000就是页目录的基址. 随便找一个软件测试下 通过0xC0300000找到的物理页就是页目录表这个物理页即是页目录表本身也是页表页目录表是一张特殊的页表,每一项PTE指向的不是普通的物 ...
- jQuery 获取标签属性值的问题
jquery attr()无法获取属性值问题 css里明明已经设置过了: 可还是获取不了: 求指导. 一定是undefined,attr是用来获得或设置标签属性的,不是用来获得CSS属性的.如果你 ...
- 应用日志获取-web系统
1 场景 应用使开发写的,但应用使部署再服务器上,而开发没有ssh登陆服务器的权限. so,开发总是请运维查日志,下载日志. so and so,运维要花很多时间帮开发去搞日志. 这是件很没意义的事, ...
- js字符串与正则匹配
这里就说一下具体的使用方法,不做过多的解释. 字符串匹配正则的方法:str.方法(reg) 1.str.search() 参数是正则,将会从开始查找字符串中与正则匹配的字符,并返回该字符的第一次出现的 ...
- 2017 Multi-University Training Contest - Team 1 Balala Power!
Talented Mr.Tang has n strings consisting of only lower case characters. He wants to charge them wit ...