
斯坦福大学公开课机器学习:machine learning system design | trading off precision and recall(F score公式的提出:学习算法中如何平衡(取舍)查准率和召回率的数值)
一般来说,召回率和查准率的关系如下:1、如果需要很高的置信度的话,查准率会很高,相应的召回率很低;2、如果需要避免假阴性的话,召回率会很高,查准率会很低。下图右边显示的是召回率和查准率在一个学习算法中的关系。值得注意的是,没有一个学习算法是能同时保证高查准率和召回率的,要高查准率还是高召回率,取决于自己的需求。此外,查准率和召回率之间的关系曲线可以是多样性,不一定是图示的形状。

如何取舍查准率和召回率数值:
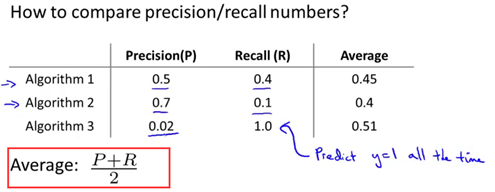
一开始提出来的算法有取查准率和召回率的平均值,如下面的公式average=(P+R)/2。显然,在给出的三个算法当中,算法3的平均值是最高的,然而通过查准率(0.02)和召回率(1.0)可以看出这并不是一个很好的模型。因此,取平均值这个评估模式是不可取的。
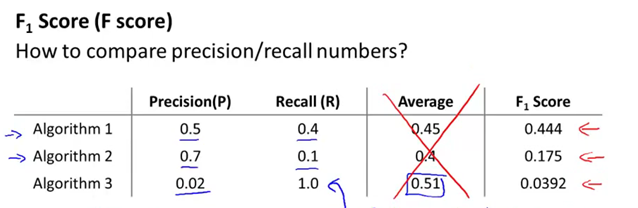
如果采用F score算法来同时评估查准率和召回率,则是比较有用的算法。分子的PR决定了查准率(P)和召回率(R)必须同时比较大,才能保证F score数值比较大。假如查准率或者召回率很低,接近于0,直接导致的后果PR值非常低,趋近于0,也就是F score也很低。

此时再比较三个算法,可发现算法1是最优的,同时我们观察到算法3在这个公式中F score值是最低的。很好的说明了算法3不是一个很好的模型(查准率太低)。说明F score是一个很好的同时评估查准率和召回率的公式。
斯坦福大学公开课机器学习:machine learning system design | trading off precision and recall(F score公式的提出:学习算法中如何平衡(取舍)查准率和召回率的数值)的更多相关文章
- 斯坦福大学公开课机器学习:advice for applying machine learning | diagnosing bias vs. variance(机器学习:诊断偏差和方差问题)
当我们运行一个学习算法时,如果这个算法的表现不理想,那么有两种原因导致:要么偏差比较大.要么方差比较大.换句话说,要么是欠拟合.要么是过拟合.那么这两种情况,哪个和偏差有关.哪个和方差有关,或者是不是 ...
- 第19月第8天 斯坦福大学公开课机器学习 (吴恩达 Andrew Ng)
1.斯坦福大学公开课机器学习 (吴恩达 Andrew Ng) http://open.163.com/special/opencourse/machinelearning.html 笔记 http:/ ...
- 斯坦福大学公开课机器学习:machine learning system design | error metrics for skewed classes(偏斜类问题的定义以及针对偏斜类问题的评估度量值:查准率(precision)和召回率(recall))
上篇文章提到了误差分析以及设定误差度量值的重要性.那就是设定某个实数来评估学习算法并衡量它的表现.有了算法的评估和误差度量值,有一件重要的事情要注意,就是使用一个合适的误差度量值,有时会对学习算法造成 ...
- 斯坦福大学公开课机器学习:advice for applying machine learning | model selection and training/validation/test sets(模型选择以及训练集、交叉验证集和测试集的概念)
怎样选用正确的特征构造学习算法或者如何选择学习算法中的正则化参数lambda?这些问题我们称之为模型选择问题. 在对于这一问题的讨论中,我们不仅将数据分为:训练集和测试集,而是将数据分为三个数据组:也 ...
- 斯坦福大学公开课机器学习: machine learning system design | error analysis(误差分析:检验算法是否有高偏差和高方差)
误差分析可以更系统地做出决定.如果你准备研究机器学习的东西或者构造机器学习应用程序,最好的实践方法不是建立一个非常复杂的系统.拥有多么复杂的变量,而是构建一个简单的算法.这样你可以很快地实现它.研究机 ...
- 斯坦福大学公开课机器学习: machine learning system design | prioritizing what to work on : spam classification example(设计复杂机器学习系统的主要问题及构建复杂的机器学习系统的建议)
当我们在进行机器学习时着重要考虑什么问题.以垃圾邮件分类为例子.假如你想建立一个垃圾邮件分类器,看这些垃圾邮件与非垃圾邮件的例子.左边这封邮件想向你推销东西.注意这封垃圾邮件有意的拼错一些单词,就像M ...
- 斯坦福大学公开课机器学习:Neural Networks,representation: non-linear hypotheses(为什么需要做非线性分类器)
如上图所示,如果用逻辑回归来解决这个问题,首先需要构造一个包含很多非线性项的逻辑回归函数g(x).这里g仍是s型函数(即 ).我们能让函数包含很多像这的多项式,当多项式足够多时,那么你也许能够得到可以 ...
- 斯坦福大学公开课机器学习:machine learning system design | data for machine learning(数据量很大时,学习算法表现比较好的原理)
下图为四种不同算法应用在不同大小数据量时的表现,可以看出,随着数据量的增大,算法的表现趋于接近.即不管多么糟糕的算法,数据量非常大的时候,算法表现也可以很好. 数据量很大时,学习算法表现比较好的原理: ...
- 斯坦福大学公开课机器学习:advice for applying machine learning - deciding what to try next(设计机器学习系统时,怎样确定最适合、最正确的方法)
假如我们在开发一个机器学习系统,想试着改进一个机器学习系统的性能,我们应该如何决定接下来应该选择哪条道路? 为了解释这一问题,以预测房价的学习例子.假如我们已经得到学习参数以后,要将我们的假设函数放到 ...
随机推荐
- CDH 6.0.1 集群搭建 「Before install」
从这一篇文章开始会有三篇文章依次介绍集群搭建 「Before install」 「Process」 「After install」 继上一篇使用 docker 部署单机 CDH 的文章,当我们使用 d ...
- idea的pom.xml中提示dependency‘’not found
今天下午在更新svn上的项目到本地,发现pom文件中的如下依赖的version一直标红,鼠标放上去显示“dependency not found.” 同时检查了Maven Projects中该项目引入 ...
- Chrome 75 & lazy-loading
Chrome 75 & lazy-loading https://addyosmani.com/blog/lazy-loading/ https://chromestatus.com/feat ...
- Java多线程3:Thread中的实例方法
一.Thread类中的方法调用方式 学习Thread类中的方法是学习多线程的第一步.在学习多线程之前特别提出一点,调用Thread中的方法的时候,在线程类中,有两种方式,一定要理解这两种方式的区别: ...
- 解析xml文件 selectSingleNode取不到节点
今天在做批量生成XML的时候,碰到一个情况 解析xml文件 selectSingleNode一直返回NULL. XML的格式开头有一句这个<CE401Message xmlns="ht ...
- 由 POST 400 错误拔出来的萝卜
缘起 前段时间遇到扫描问题,好不容易拿到了扫描出来的数据,结果调用接口时弹了个 400(Bad request) 给我,匆匆找了点资料修补上线后,忐忑的心也可以安分点.然后,顺着这个 400 的萝卜, ...
- Mysql(Mariadb)数据库主从复制
Mysql主从复制的实现原理图大致如下: MySQL之间数据复制的基础是以二进制日志文件(binary log file)来实现的,一台MySQL数据库一旦启用二进制日志后,其作为master,它数据 ...
- 【RNN】资源汇总
wesome Recurrent Neural Networks A curated list of resources dedicated to recurrent neural networks ...
- 【题解】K乘积
题目描述 有N个数,每个数的范围是[-50,50],现在你要从这N个数中选出K个,使得这K个数的乘积最大. 输入格式 第一行,N和K. 1 <= N <= 50. 1 <= K & ...
- Go语言类型的本质
如果给这个类型增加或者删除某个值,是要创建一个新值,还是要更改当前的值? 如果是要创建一个新值,该类型的方法就使用值接收者. 如果是要修改当前值,就使用指针接收者. 这个答案也会影响程序内部传递这个类 ...