
python3使用requests模块完成get/post/代理/自定义header/自定义Cookie
一、背景说明
http请求的难易对一门语言来说是很重要的而且是越来越重要,但对于python一是urllib一些写法不太符合人的思维习惯文档也相当难看,二是在python2.x和python3.x中写法还有差别。
实在是太难用,开始差点由于这个原因想放弃python,直到看urllib.request文档时看到下边这句话,认识了requests。总的而言requests配得上“HTTP for Humans”的口号。

1.1 适用版本
适用于python2.6、python2.7、python3.4及以上版本,参见官方说明。我这里使用的是当前最新的python3.7。
1.2 安装requests模块
pip install requests

# ubuntu类系统也可以直接用apt安装

# sudo apt-get install python-requests
二、使用requests模块完成各种操作
下边对于https的链接请求时会带上”verify=False“参数,因为默认Python会进行证书校验如果不是信任的证书会报错,带上”verify=False“指示不进行证书校验。
2.1 引用requests模块
import requests
2.2 get请求
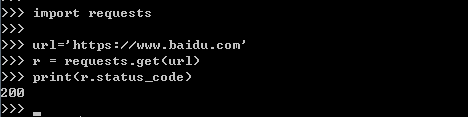
import requests

url='https://www.baidu.com'

r = requests.get(url,verify=False)

print(r.status_code)
2.3 post请求
import requests

url='https://www.baidu.com'

data='username=ls&password=toor'

r = requests.post(url,data=data,verify=False)

print(r.status_code)


当前很多api是以json形式提交的,所以在使用post的时候我们可能想提交json数据。
提交json有两步:一是data要编码成json形式(python中的字典形式上和json一样但本质上不一样所以要编码),二是设置“Content-type”头的值为application/json(设置头部参见下面2.5,这里先用)
import json

import requests

# 一定要设置Content-Type值为application/json

headers={}

headers['Content-Type']='application/json'

url='https://www.baidu.com'

data={"username":"ls","password":"toor"}

# 一定要用json.dumps把data格式化成json

# r = requests.post(url,headers=headers,data=json.dumps(data),verify=False)

# 或者直接使用json参数代替data,此时requests会自动进行格式化和设置Content-Type头的工作

r = requests.post(url,json=data,verify=False)

print(r.status_code)

为了方便对比验证,另外再附curl post提交的方法:
curl -H "Content-Type:application/json" -X POST --data '{"username": "ls","password":"toor"}' https://www.baidu.com/
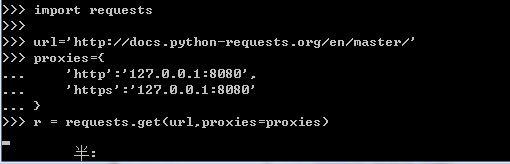
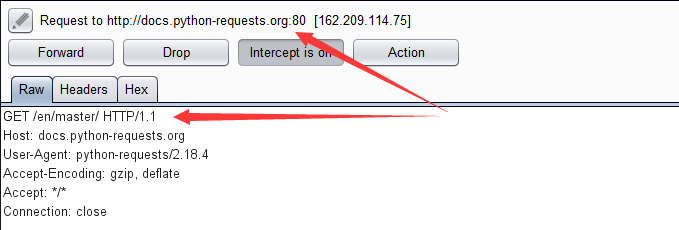
2.4 使用代理
import requests

url='http://docs.python-requests.org/en/master/'

proxies={

    'http':'127.0.0.1:8080',

    'https':'127.0.0.1:8080'

}

r = requests.get(url,proxies=proxies)

print(r.status_code)
2.5 自定义header
import requests

url='http://docs.python-requests.org/en/master/'

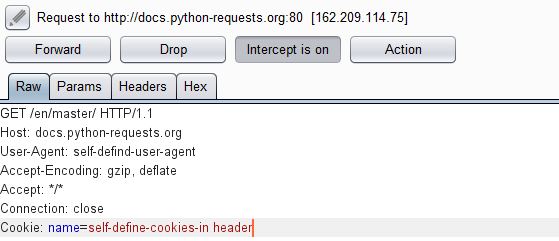
headers={

    'User-Agent':'self-defind-user-agent',

    'Cookie':'name=self-define-cookies-in header'

}

r = requests.get(url,headers=headers)

print(r.status_code)

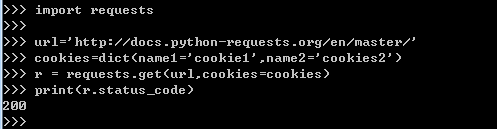
2.6 自定义Cookie
实验发现如果自定义header中定义了cookies那么此处设置的cookies不生效
import requests

url='http://docs.python-requests.org/en/master/'
cookies={'name1':'cookie1','name2':'cookies2'}
#cookies=dict(name1='cookie1',name2='cookies2')
r = requests.get(url,cookies=cookies)
print(r.status_code)
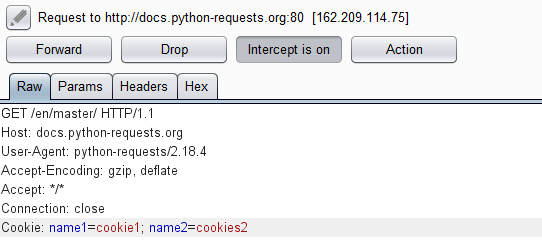
2.7 会话保执
经常很多请求只有在登录后才能进行,实现登录效果一般的做法是执行登录请求,然后从返回结果中提取sessionid放入自定义cookie中。
这种方法在requests中也行得通,但requests提供了更为简单的方法,直接使用request.Session类来请求即可,其保持登录的原理是保留之前请求中服务端通过set-cookie等设置的参数。
s = Session()

url='http://docs.python-requests.org/en/master/'

# 所有方法和直接使用requests时一样用即可

s.get(url)
参考:
http://docs.python-requests.org/en/master/(官方文档)
https://www.cnblogs.com/landhu/p/7048255.html
https://stackoverflow.com/questions/9733638/post-json-using-python-requests
python3使用requests模块完成get/post/代理/自定义header/自定义Cookie的更多相关文章
- Python3:Requests模块的异常值处理
Python3:Requests模块的异常值处理 用Python的requests模块进行爬虫时,一个简单高效的模块就是requests模块,利用get()或者post()函数,发送请求. 但是在真正 ...
- python3 get/post/使用代理/自定义header/自定义Cookie
说明:urllib发送http请求并不是很人性化,更推荐使用在urllib基础上封装的.python2和python3都兼容的requests模块,移步查看. 一.get请求 get请求就是在构造Re ...
- Python3之Requests模块详解
# 导入 Request模块 # 若本机无自带Request模块,可自行下载或者使用pip进行安装 # python版本Python3 import requests import json #### ...
- [实战演练]python3使用requests模块爬取页面内容
本文摘要: 1.安装pip 2.安装requests模块 3.安装beautifulsoup4 4.requests模块浅析 + 发送请求 + 传递URL参数 + 响应内容 + 获取网页编码 + 获取 ...
- (转)Python3之requests模块
原文:https://www.cnblogs.com/wang-yc/p/5623711.html Python标准库中提供了:urllib等模块以供Http请求,但是,它的 API 太渣了.它是为另 ...
- Python3之requests模块
Python标准库中提供了:urllib等模块以供Http请求,但是,它的 API 太渣了.它是为另一个时代.另一个互联网所创建的.它需要巨量的工作,甚至包括各种方法覆盖,来完成最简单的任务. 发送G ...
- (四)requests模块的cookies和代理操作
基于requests模块的cookie操作 引言:有些时候,我们在使用爬虫程序去爬取一些用户相关信息的数据(爬取某个人“人人网”个人主页数据)时,如果使用之前requests模块常规操作时,往往达不到 ...
- Python——python3的requests模块的导入
前言 突然就要搞python,我这个心哦~ 版本 | python 3.7 步骤 配置环境变量 右击-->属性-->打开文件位置 进入到脚本目录: C:\Users\Administrat ...
- 03爬虫-requests模块基础(1)
requests模块基础 什么是requests模块 requests模块是python中原生基于网络模拟浏览器发送请求模块.功能强大,用法简洁高效. 为什么要是用requests模块 用以前的url ...
随机推荐
- spring读取bean有几种方式
bean加载到spring的方式: 第一种:xml 第二种:注释「一定要配合包扫描」: <context:component-scan base-package="Cristin.Co ...
- Easy Graphics Engine vs2015使用
vs2017: 下载 https://pan.baidu.com/s/1qWxAgeK 里面的 “ege19.01_vs2017 (推荐, 修正win10 1809 上无法正常运行的问题).zip” ...
- matplotlib.transforms
来自:龙哥盟飞龙 变换教程 像任何图形包一样,matplotlib建立在变换框架之上,以便在坐标系,用户数据坐标系,轴域者坐标系,图形坐标系和显示坐标系之间轻易变换.在95%的绘图中,你不需要考虑这一 ...
- sklearn.learning_curve
学习曲线函数: from sklearn.learning_curve import learning_curve 调用格式: learning_curve(estimator, X, y, trai ...
- N的阶乘(10000) 51 nod——1057 (大数)
像这些大整数加法或者乘法什么的思想都一样,就是截位存取,累积进位,最后逆序输出就可以啦 PS:小生是用10000来存取的,300MS就能A,如果单个存取有点危险,题目时间限制好像是1000ms,大家可 ...
- python web.py实现简单的get和post请求
使用web.py框架,实现简单的get和post请求: py文件名:mytest.py import web urls = ( '/', 'hello' ) app = web.application ...
- 清除div重叠浮动的方法
在最后加入这样一个div. 并且为div加入以下属性: .clear { clear:both;}
- stop 用法
1. stop 文档 $(selector).stop(stopAll,goToEnd) stopAll 可选.规定是否停止被选元素的所有加入队列的动画.goToEnd 可选.规定是否允许完成当前的动 ...
- jQuery 的 prevObject
1. prevObject jquery选择器在遍历的过程中都会找到一组元素(一个jQuery对象),然后jQuery会把这组元素推入到栈中.prevObject属性就指向这个对象栈中的前一个对象,而 ...
- Fiddler 简单介绍
fiddler 也已经使用了几年了,前面做免登录时就是用了fiddler,为了抓取cookie等信息.但是一直没有对他进行整理出一篇文章来介绍其使用. Fiddler的基本介绍 Fiddler的官方网 ...