
Trino Master OOM 排查记录
背景
最近线上的 trino 集群 master 节点老是因为 OOM crash,我们注意到 trino crash 前集群正在运行的查询数量正常,不太像是因为并发查询数据太多导致的 OOM。遂配置 trino master 的 jvm,使其在崩溃后生成一份 dump 文件,方便我们进行问题排查。
排查问题过程
收集到了 Trino master oom dump 文件,用 mat 工具对其分析得出报告。
从报告得知,trino master crash 前有一条查询消耗掉了大量资源,还有一大堆的 DeleteFileIndex 实例也消耗掉很多资源。

我们有收集 trino 上所有的查询语句,通过 query_id 定位到那条异常 SQL。初看 SQL 逻辑,没太大问题,应该不会导致 trino master oom。
于是找一个 trino 集群做故障还原,发现并发执行 异常SQL 4条,master 就会 crash。
于是进 trino-master 容器内,用 arthas 实时观察 jvm 状况。
发现当 异常SQL 发起查询时,jvm 内 iceberg-work-pool 线程的 cpu 暂用率会飙升到 100%,且此时 jvm 内存也在飙升,过程持续 20s,刚好是异常SQL 生成执行计划所花费的时间。
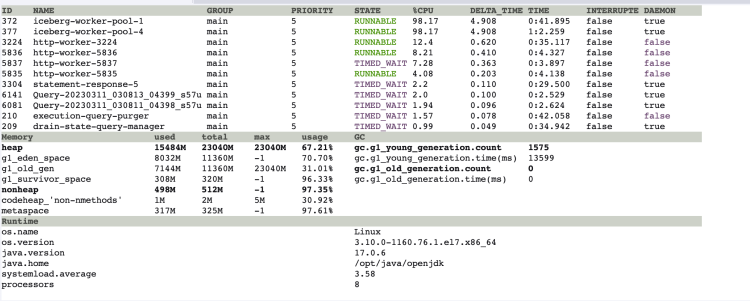
然后使用 arthas 查看 iceberg-work-pool 线程在干嘛?发现其在调用 DeleteFileIndex 这个类,在报告里面也是属于 top 10 comsumer 。

看栈信息,得到信息在扫描 iceberg 的 manifestlist 时,会去扫描已删除的文件。猜测大概率是需要找到已删除的数据 和 现在存在的数据 做一个 merge,才是当前快照的真实数据。
于是分析 怀疑表 nft_orders_v2 的元数据信息,发现 snapshow 里需要读取大量的删除文件。
snapshots
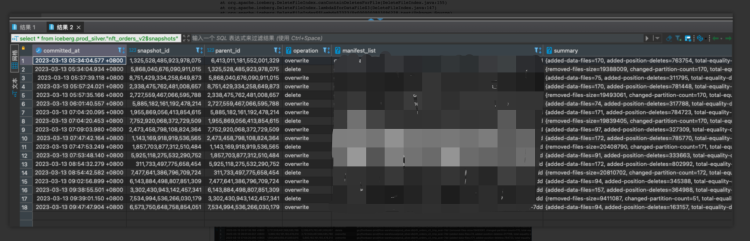
而 Trino 是使用 merge on read 模式进行 merge/update/delete 操作的,这样的话每次查询时,得扫描 "delete file" 来和 "data file" 进行合并,得出真实数据。

所以问题就出现在这,由于该表每半小时生产一次,底层存在大量的 'delete file' ,每次查询时都要扫描这些 'delete file' 然后做 merge 操作生成执行计划。这步操作消耗掉很多 cpu资源和内存资源,导致 trino master 节点崩溃。
解决方案
使用 trino 的小文件合并功能,重写底层数据文件即可修复。
ALTER TABLE nft_orders_v2 EXECUTE optimize (file_size_threshold => '100MB')
为了规避此类问题再次分析,还需要找出哪些查询的查询计划时间大于 10s,找出这些查询并分析用到的表的元数据是否合理,不合理要及时修正。
Trino Master OOM 排查记录的更多相关文章
- Linux 遭入侵,挖矿进程被隐藏排查记录
今天来给大家分享下这两天遇到的一个问题,服务器被挖矿了,把我的排查记录分享下,希望能帮到有需要的同学. 问题原因 多台服务器持续告警CPU过高,服务器为K8s的应用节点,正常情况下CPU使用率都挺低的 ...
- 【转】又一次线上 OOM 排查经过
又一次线上OOM排查经过 最近线上一个服务又出现了频繁Full GC的情况,导致提供的业务经常超时.问题出现非常不稳定,经过两周的时候,终于又捕捉到了一次Full GC,于是联系运维做Heap Dum ...
- FastDFS----recovery状态问题排查记录
FastDFS问题排查记录现象今天有人反馈,客户端部分图标时而不能显示问题定位用jemter将图片地址进行简单测试后,发现偶尔有404 NOT FOUND的情况在服务器上对八台nginx分别进行测试 ...
- Shiro权限管理框架(五):自定义Filter实现及其问题排查记录
明确需求 在使用Shiro的时候,鉴权失败一般都是返回一个错误页或者登录页给前端,特别是后台系统,这种模式用的特别多.但是现在的项目越来越多的趋向于使用前后端分离的方式开发,这时候就需要响应Json数 ...
- 一次内核 crash 的排查记录
一次内核 crash 的排查记录 使用的发行版本是 CentOS,内核版本是 3.10.0,在正常运行的情况下内核发生了崩溃,还好有 vmcore 生成. 准备排查环境 crash 内核调试信息rpm ...
- 记录一次OOM排查经历
我是用了netty搭建了一个UDP接收日志,堆启动配置 Xmx256 Xms256 ,项目刚启动的时候,系统进程占用内存很正常,在250M左右. 长时间运行之后发现,进程占用内存不断增长,远远超过了 ...
- 记录一次OOM排查经历(一)
一.经历概要 程序里有个跑数据的job,这个job的主要功能是往数据库写假数据. 既需要跑历史数据(传给job的日期是过去的时间),也需要能够上线后,实时跑(十秒钟触发一次,传入触发时的当前时间). ...
- Kubernetes Pod OOM 排查日记
一.发现问题 在一次系统上线后,我们发现某几个节点在长时间运行后会出现内存持续飙升的问题,导致的结果就是Kubernetes集群的这个节点会把所在的Pod进行驱逐OOM:如果调度到同样问题的节点上,也 ...
- 一次完整的JVM堆外内存泄漏故障排查记录
前言 记录一次线上JVM堆外内存泄漏问题的排查过程与思路,其中夹带一些JVM内存分配机制以及常用的JVM问题排查指令和工具分享,希望对大家有所帮助. 在整个排查过程中,我也走了不少弯路,但是在文章中我 ...
- 一次MySQL死锁的排查记录
前几天线上收到一条告警邮件,生产环境MySQL操作发生了死锁,邮件告警的提炼出来的SQL大致如下. update pe_order_product_info_test set end_time = ' ...
随机推荐
- MacOS如何使用语音输入
Siri是Apple旗下强大的语音助手,而Siri的语音输入是必不可少的的存在.目前的MacOS中都有语音听写功能,可以让它把我们的语音转化成为文字.如果你此时不想打字,或是不方便打字的情况下,这个功 ...
- Finder是什么?Mac下的Finder有什么用?
Finder是什么?Mac OS X系统下的Finder即相当于Windows系统下的"我的电脑"资源管理器.通过Finder,您能查看Mac 上几乎全部内容,包括应⽤软件.硬盘. ...
- Date 日期字符串自定义格式化
Date.prototype.Format = function (fmt) { var o = { "M+": this.getMonth() + 1, //月份 "d ...
- nginx的nginx.conf目录简单配置
我的nginx.conf是在 etc/nginx/目录下 我是直接在http随便找了个地方添加如下代码的: server { listen 8066; server_name 192.168.0.2 ...
- django:django同步数据库的时候app models表没有成功创建
解决方式: python3 manage.py makemigrations --empty managerbook # managerbook就是你的app名字,此处要写成自己的app名字 pyt ...
- G6-Editor 编辑器入门使用教程
一.前言 G6-Editor 是 AntV 官方提供的.专注于图可视化编辑器的类库,也是市面上完成度较高的图可视化编辑器.然而令人诟病的是其文档对新手极度不友好,我一度怀疑此文档只有他们自己开发人员才 ...
- 06 Spark SQL 及其DataFrame的基本操作
1.Spark SQL出现的 原因是什么? Spark SQL是Spark用来处理结构化数据的一个模块,它提供了一个叫作Data Frame的编程抽象结构数据模型(即带有Schema信息的RDD),S ...
- go理论知识总结
基于const常量理解个中类型的内存分配引入参考 官方:Constant expressions may contain only constant operands and are evaluate ...
- python机器学习——KNN(K近邻算法)
背景与原理: KNN算法其实是逻辑最简单的分类算法--我们认为一个数据的类型是由与其最接近的数据决定的,而"接近"实际上就是我们度量两个数据点之间的距离,如果我们把一组数据看做一个 ...
- 从零开始:在树莓派上安装OpenEuler
树莓派(Raspberry Pi)是一款基于ARM架构的小型电脑,它的便携性和低功耗性能使它成为制作物联网设备或运行嵌入式系统的理想选择.在这篇博客中,我们将介绍如何在树莓派上安装OpenEuler操 ...