
Python网络爬虫_爬取Ajax动态加载和翻页时url不变的网页
1 . 什么是 AJAX ?
AJAX = 异步 JavaScript 和 XML。
AJAX 是一种用于创建快速动态网页的技术。
通过在后台与服务器进行少量数据交换,AJAX 可以使网页实现异步更新。这意味着可以在不重新加载整个网页的情况下,对网页的某部分进行更新。
传统的网页(不使用 AJAX)如果需要更新内容,必需重载整个网页面。
几个常见的用到ajax的场景。
比如你在逛知乎,你没有刷新过网页,但是你却能看到你关注的用户或者话题有了新动态的消息提示。
还比如,我们在看视频时,可以看到下面的评论没有完全全部加载出来,而是你向下拖动一点,它给你加载一点。
为什么要用到ajax呢?
从上述场景你应该也可以发现它的优点,
第一,方便与用户的交互,不用重新加载整个网页,就可以实现刷新,不用中断用户的行为。你正在看程序员如何找对象呢,此时来个消息推送,整个网页被刷新了,你说你气不气!
第二个呢,还是你在看程序员如何找对象,但是此时通信状况不好啊。回答加载不出来,页面就空白的卡那了,回答加载不出来,你说急不急!那这样咯,先给你看几个回答,在你看的时候我再悄悄的加载其它的数据,那不就解决了吗?就跟吃饭一个道理,你点了一桌子菜,难道菜全做好了再给你上吗?肯定不会的呀,做好一道上一道嘛,对不对。
第三,从服务端的发送过来的ajax数据,体积比较小。浏览器知道怎么渲染它,这样就减轻了服务端的压力,让客户端,也就是浏览器承担了一些任务。
Ajax技术的核心是XMLHttpRequest对象(简称XHR),可以通过使用XHR对象获取到服务器的数据,然后再通过DOM将数据插入到页面中呈现。虽然名字中包含XML,但Ajax通讯与数据格式无关,所以我们的数据格式可以是XML或JSON等格式。
XMLHttpRequest对象用于在后台与服务器交换数据,具体作用如下:
- 在不重新加载页面的情况下更新网页
- 在页面已加载后从服务器请求数据
- 在页面已加载后从服务器接收数据
- 在后台向服务器发送数据
2. Ajax对爬虫有什么影响?
还是对应着上述的场景,我爬虫肯定要爬取一个完整数据。但是你一次就只教我两种找对象的方法。还不够我举一反三呢,万一其中还有几个段子,那这样的数据不具有完整性,不够全面。但是不滑动浏览器,数据不出来怎么办?
更坑爹是什么,ajax加载出来的数据是通过浏览器渲染给我们的呀,源代码不一定能找到我们要的数据。那该肿么办!浏览器知道怎么加载, 我们不知道呀!
3.如何爬取这样的ajax动态加载的网页。
1. Selenium + PhantomJs
PhantomJS是一个无界面的,可脚本编程的WebKit浏览器引擎。它原生支持多种web 标准:DOM 操作,CSS选择器,JSON,Canvas 以及SVG。它的作用是和浏览器类似,可以渲染js处理的页面。
selenium是什么呢?它本来是个自动化测试工具,但是被广泛的用户爬虫啊。它是一个工具,这个工具可以用代码操作浏览器。比如控制浏览器的下滑之类。不过我并不是很熟悉,以前了解过一点。
不过,我没用这种方法。为啥呢,因为慢。操作浏览器的时间加起来好多好多了呗,而且又不是没有更好的办法。
2. 自己找,找真实请求。
只要是有数据发送过来,那肯定是有发送到服务器的请求的吧。我们只需找出它悄悄加载出的页面的真实请求在哪发送的。
寻找实例:爬取杭州萧山机场一天的航班信息。
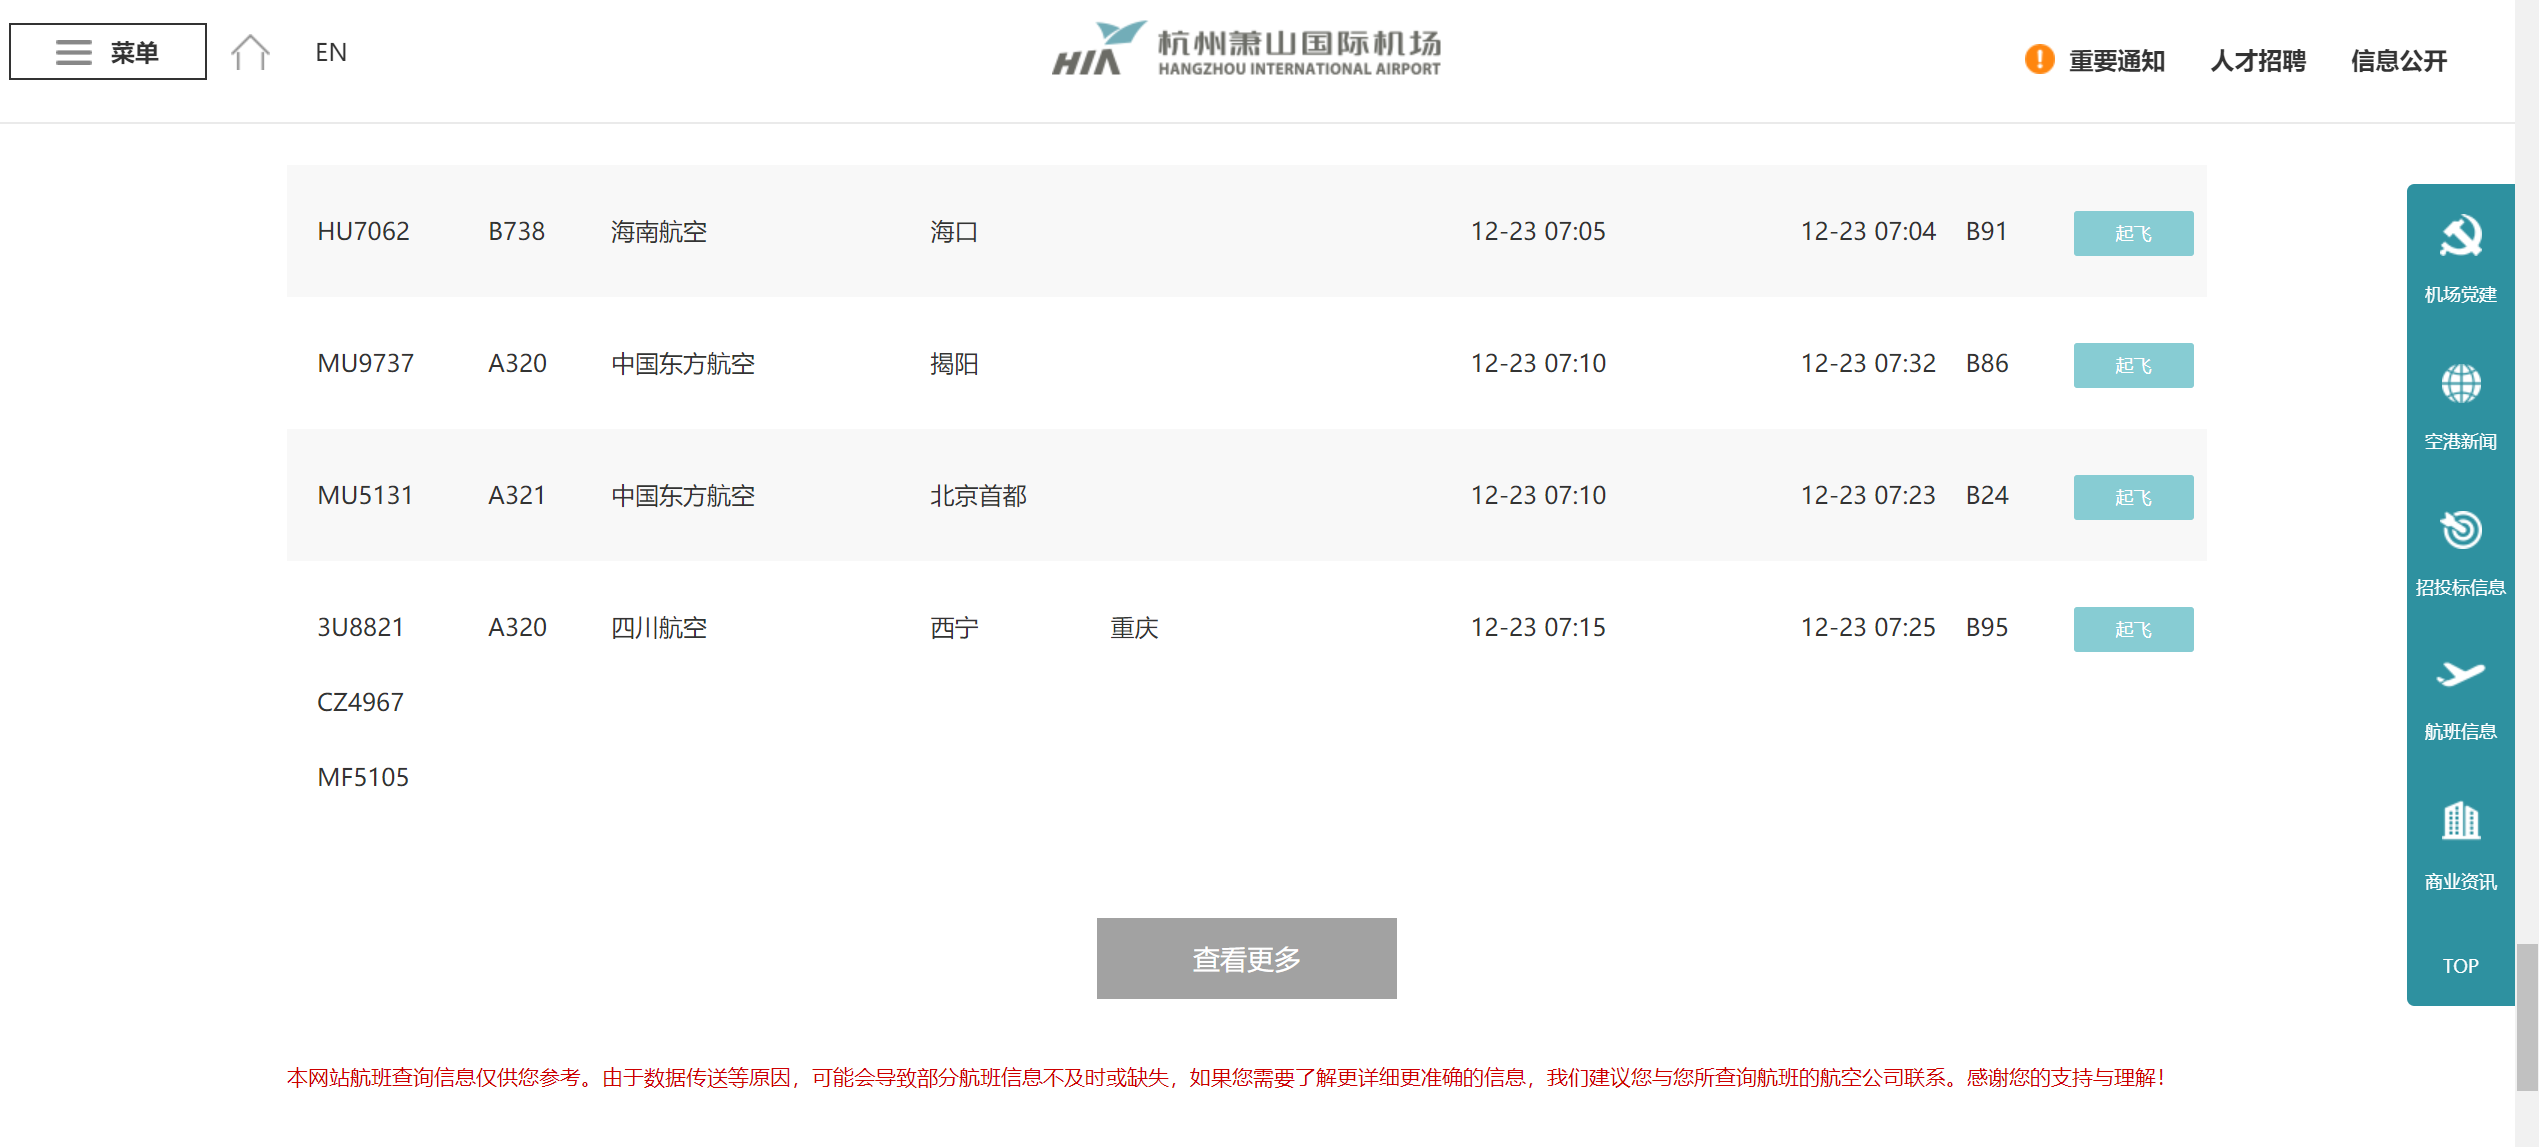
1)右键单击查看网页源码,发现点击“查看更多”之后的页面源码里没有新出现的航班信息,所以猜测它是使用了Ajax技术。用Wireshark抓个包先。
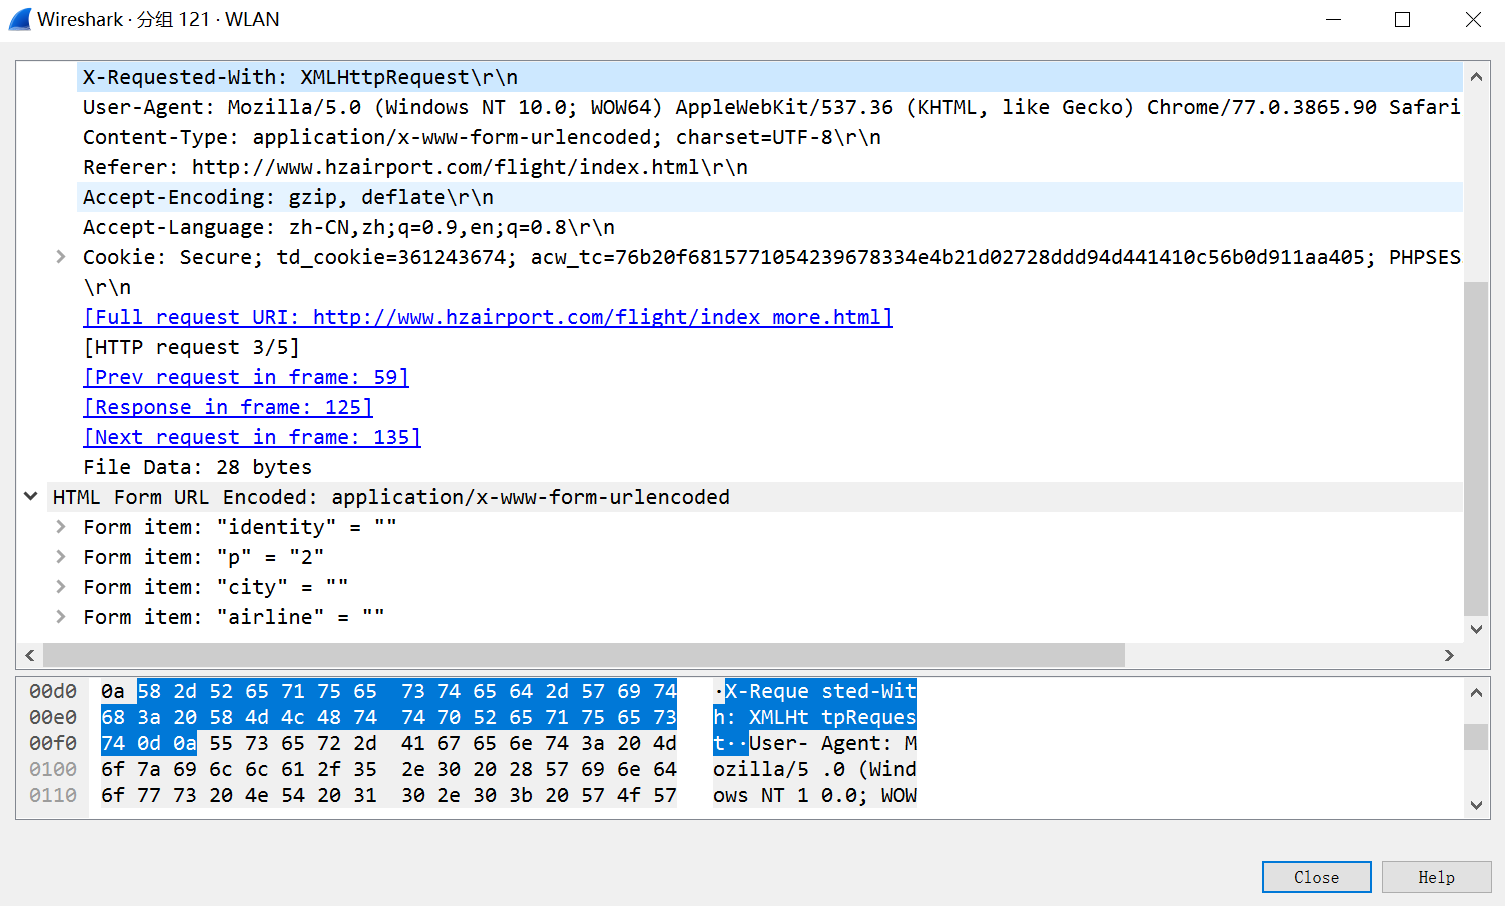
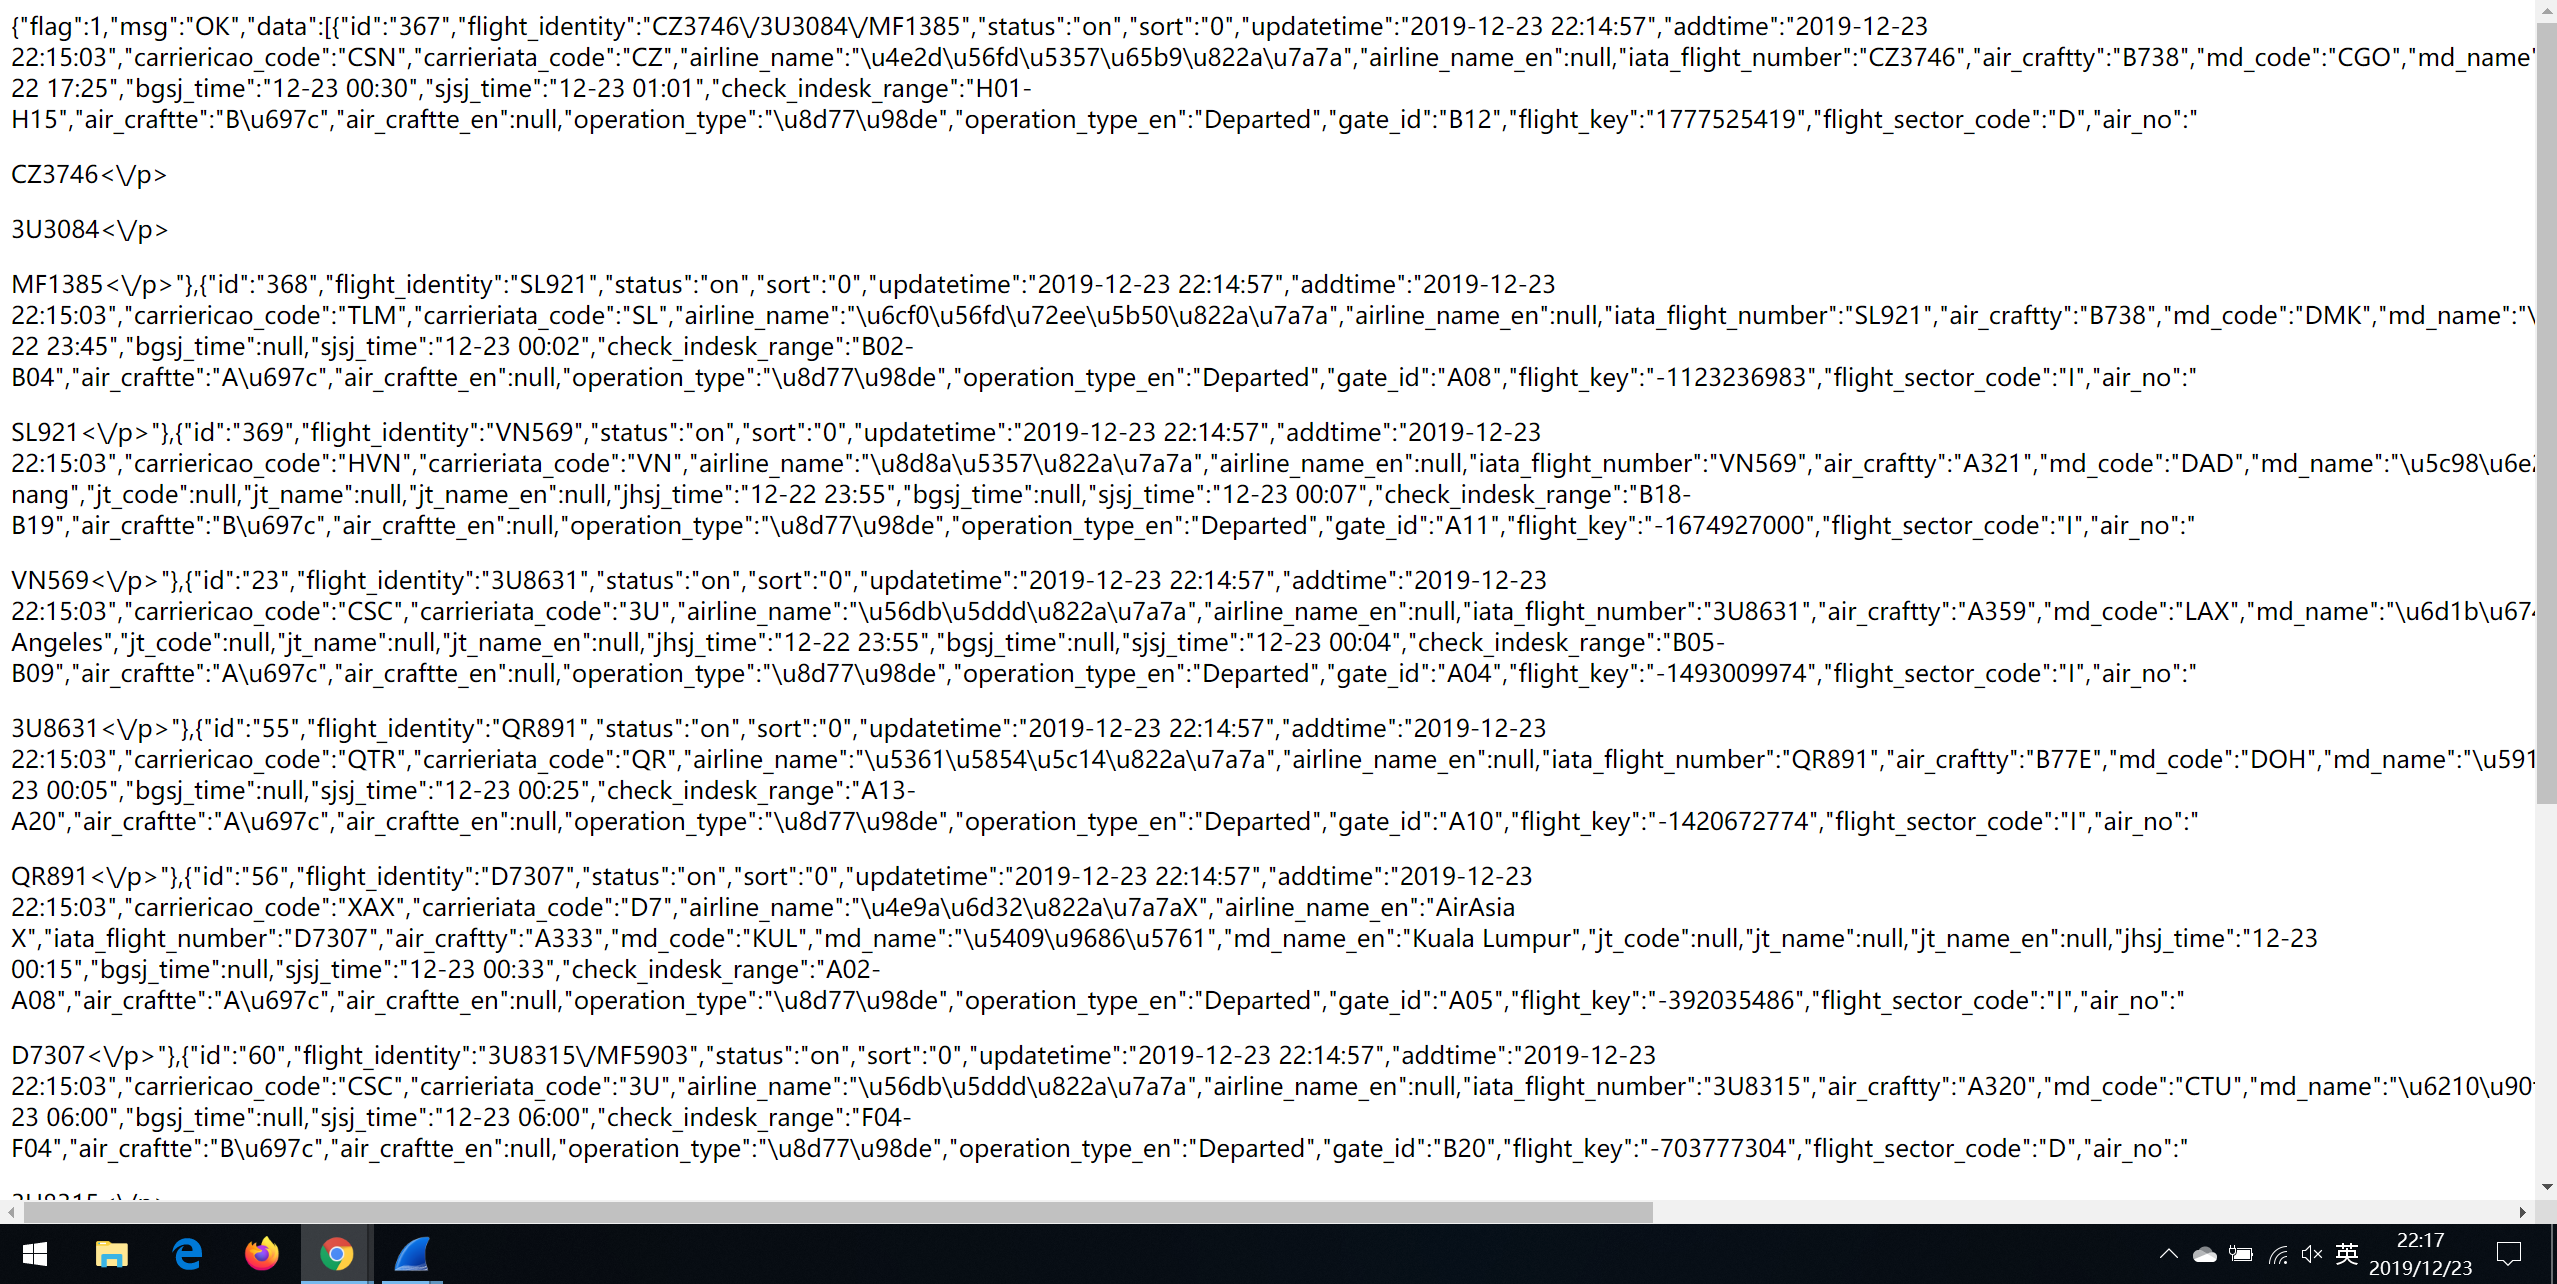
2.寻找传送XMLHttpRequest对象的参数。目测服务器是依据这个p值来选择传送的数据。
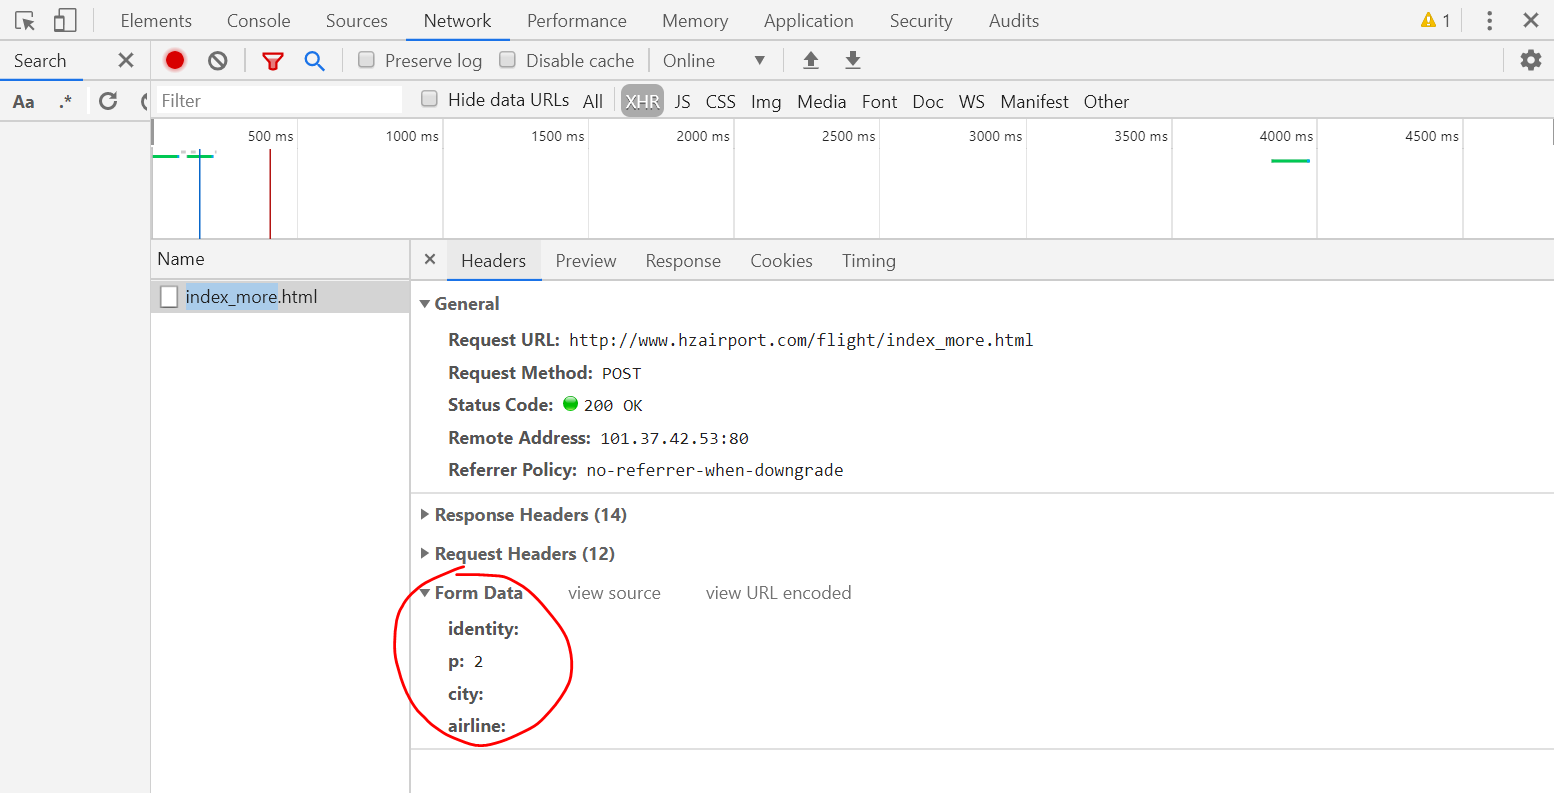
json格式检测:http://www.bejson.com/
原文链接:https://zhuanlan.zhihu.com/p/27346009
Python网络爬虫_爬取Ajax动态加载和翻页时url不变的网页的更多相关文章
- 爬虫——爬取Ajax动态加载网页
常见的反爬机制及处理方式 1.Headers反爬虫 :Cookie.Referer.User-Agent 解决方案: 通过F12获取headers,传给requests.get()方法 2.IP限制 ...
- scrapy项目5:爬取ajax形式加载的数据,并用ImagePipeline保存图片
1.目标分析: 我们想要获取的数据为如下图: 1).每本书的名称 2).每本书的价格 3).每本书的简介 2.网页分析: 网站url:http://e.dangdang.com/list-WY1-dd ...
- Python3 网络爬虫:漫画下载,动态加载、反爬虫这都不叫事
一.前言 作者:Jack Cui 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经做案例的人,却不知道如何去学习更加高深的知识.那 ...
- python网络爬虫《爬取get请求的页面数据》
一.urllib库 urllib是python自带的一个用于爬虫的库,其主要作用就是可以通过代码模拟浏览器发送请求.其常被用到的子模块在python3中的为urllib.request和urllib. ...
- python网络爬虫--简单爬取糗事百科
刚开始学习python爬虫,写了一个简单python程序爬取糗事百科. 具体步骤是这样的:首先查看糗事百科的url:http://www.qiushibaike.com/8hr/page/2/?s=4 ...
- Python网络爬虫 | Scrapy爬取妹子图网站全站照片
根据现有的知识,写了一个下载妹子图(meizitu.com)Scrapy脚本,把全站两万多张照片下载到了本地. 网站的分析 网页的网址分析 打开网站,发现网页的网址都是以 http://www.mei ...
- Python爬虫学习——使用selenium和phantomjs爬取js动态加载的网页
1.安装selenium pip install selenium Collecting selenium Downloading selenium-3.4.1-py2.py3-none-any.wh ...
- 第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
第三百三十四节,web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息 crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多 ...
- 十三 web爬虫讲解2—Scrapy框架爬虫—Scrapy爬取百度新闻,爬取Ajax动态生成的信息
crapy爬取百度新闻,爬取Ajax动态生成的信息,抓取百度新闻首页的新闻rul地址 有多网站,当你浏览器访问时看到的信息,在html源文件里却找不到,由得信息还是滚动条滚动到对应的位置后才显示信息, ...
随机推荐
- 【VS开发】OutputWnd自动滚动
最近在尝试VS2010中的各种新鲜插件,首先从最简单的输出窗口入手. VS2010向导中产生的输出窗口是通过CMainFrame中的COutputWnd类的对象m_wndOutput生成的.为了向输出 ...
- Apache Zookeeper 集群环境搭建
Zookeeper 是 一个分布式.开放源码的分布式应用程序协调服务,是Google Chubby的一个开源实现,大多数的分布式应用都需要Zookeeper的支持,这篇文章先简单的和大家分享如何搭建一 ...
- hashmap C++实现
hashmap.h #ifndef _HASHMAP_H_ #define _HASHMAP_H_ template<class Key, class Value> class HashN ...
- java 给不同成绩分等级
题目:利用条件运算符的嵌套来完成此题:学习成绩>=90分的同学用A表示,60-89分之间的用B表示,60分以下的用C表示. 程序分析:(a>b)?a:b这是条件运算符的基本例子. pack ...
- DBGridEh列宽自动适应内容的简单方法
///////Begin Source uses Math; function DBGridRecordSize(mColumn: TCo ...
- 用Python快速找到出现次数最多的数据
给你一个文件,每行一个iip?
- java限流工具类
代码 import com.google.common.util.concurrent.RateLimiter; import java.util.concurrent.ConcurrentHashM ...
- python网络爬虫(12)去哪网酒店信息爬取
目的意义 爬取某地的酒店价格信息,示例使用selenium在Firefox中的使用. 来源 少部分来源于书.python爬虫开发与项目实战 构造 本次使用简易的方案,模拟浏览器访问,然后输入字段,查找 ...
- CentOS7实现Nginx+Tomcat 负载均衡
0. 说明 将nginx作为负载均衡器,反向代理,tomcat作为节点服务器 192.168.100.201:nginx服务器 192.168.100.202:Tomcat 1服务器 192.168. ...
- HDFS中NameNode管理元数据机制
NameNode职责 响应客户端请求 维护目录树 管理元数据(查询,修改) HDFS元数据存储 内存中有一份完整的元数据(特定数据结构) 磁盘有一个“准完整”的元数据的镜像文件 当客户端对HDFS中的 ...