
sklearn中的model_selection模块(1)
sklearn作为Python的强大机器学习包,model_selection模块是其重要的一个模块:
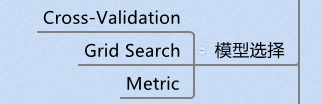
1.model_selection.cross_validation:
(1)分数,和交叉验证分数
众所周知,每一个模型会得出一个score方法用于裁决模型在新的数据上拟合的质量。其值越大越好。
from sklearn import datasets, svm

digits = datasets.load_digits()

X_digits = digits.data

 y_digits = digits.target

svc = svm.SVC(C=1, kernel='linear')

svc.fit(X_digits[:-100], y_digits[:-100]).score(X_digits[-100:], y_digits[-100:])
为了获得一个更好的预测精确度度量,我们可以把我们使用的数据折叠交错地分成训练集和测试集:
import numpy as np

X_folds = np.array_split(X_digits, 3)

y_folds = np.array_split(y_digits, 3)

scores = list()

for k in range(3):

    # We use 'list' to copy, in order to 'pop' later on

    X_train = list(X_folds)

    X_test  = X_train.pop(k)

    X_train = np.concatenate(X_train)

    y_train = list(y_folds)

    y_test  = y_train.pop(k)

    y_train = np.concatenate(y_train)

    scores.append(svc.fit(X_train, y_train).score(X_test, y_test))

print(scores)
这被称为KFold交叉验证
(2)交叉验证生成器
上面将数据划分为训练集和测试集的代码写起来很是沉闷乏味。scikit-learn为此自带了交叉验证生成器以生成目录列表:from sklearn import cross_validation
k_fold = cross_validation.KFold(n=6, n_folds=3)
for train_indices, test_indices in k_fold:
print('Train: %s | test: %s' % (train_indices, test_indices))
接着交叉验证就可以很容易实现了:
kfold = cross_validation.KFold(len(X_digits), n_folds=3)

[svc.fit(X_digits[train], y_digits[train]).score(X_digits[test], y_digits[test])

         for train, test in kfold]
为了计算一个模型的score,scikit-learn自带了一个帮助函数:
cross_validation.cross_val_score(svc, X_digits, y_digits, cv=kfold, n_jobs=-1)n_jobs=-1意味着将计算任务分派个计算机的所有CPU.
交叉验证生成器:KFold(n,k) 交叉分割,K-1上进行训练,生于数据样例用于测试StratifiedKFold(y,K) 保存每一个fold的类比率/标签分布leaveOneOut(n) 至预留一个观测样例leaveOneLabelOut(labels) 采用一个标签数组把观测样例分组
2.model_selection.grid search 网格搜索和交叉验证模型
网格搜索:
scikit-learn提供一个对象,他得到数据可以在采用一个参数的模型拟合过程中选择使得交叉验证分数最高的参数。该对象的构造函数需要一个模型作为参数:
from sklearn.grid_search import GridSearchCV

Cs = np.logspace(-6, -1, 10)

clf = GridSearchCV(estimator=svc, param_grid=dict(C=Cs),

                   n_jobs=-1)

clf.fit(X_digits[:1000], y_digits[:1000])

clf.best_score_

clf.best_estimator_.C

# Prediction performance on test set is not as good as on train set

clf.score(X_digits[1000:], y_digits[1000:])
默认情况下,GridSearchCV使用3-fold交叉验证。然而,当他探测到是一个分类器而不是回归量,将会采用分层的3-fold。
嵌套 交叉验证
cross_validation.cross_val_score(clf, X_digits, y_digits)两个交叉验证循环是并行执行的:一个GridSearchCV模型设置gamma,另一个使用cross_val_score 度量模型的预测表现。结果分数是在新数据预测分数的无偏差估测。
【警告】你不能在并行计算时嵌套对象(n_jobs不同于1)
交叉验证估测:
在算法by算法的基础上使用交叉验证去设置参数更高效。这也是为什么对于一个特定的模型/估测器引入Cross-validation:评估估测器表现模型去自动的通过交叉验证设置参数。
from sklearn import linear_model, datasets

lasso = linear_model.LassoCV()

diabetes = datasets.load_diabetes()

X_diabetes = diabetes.data

y_diabetes = diabetes.target

lasso.fit(X_diabetes, y_diabetes)

# The estimator chose automatically its lambda:

lasso.alpha_
这些模型的称呼和他们的对应模型很相似,只是在他们模型名字的后面加上了'CV'.
【补充】嵌套交叉验证
通过嵌套交叉验证选择算法
- 如果需要在不同机器学习算法之间做选择,则可以使用嵌套交叉验证
- 分为内层嵌套和外层:一般使用GridSearchCV()进行内层的交叉验证,使用cross_val_score()进行外层交叉验证;
原理
- 在嵌套交叉验证的外围循环中,将数据划分为训练块及测试块
- 在内部循环中,则基于这些训练块,使用k折交叉验证
- 完成模型选择后,使用测试块进行模型性能的评估
- 如下图所示,是一种5*2交叉验证
gs = GridSearchCV(estimator=pipe_svc,

                  param_grid=param_grid,

                  scoring='accuracy',

                  cv=2)

# Note: Optionally, you could use cv=2

# in the GridSearchCV above to produce

# the 5 x 2 nested CV that is shown in the figure.

scores = cross_val_score(gs, X_train, y_train, scoring='accuracy', cv=5)

print('CV accuracy: %.3f +/- %.3f' % (np.mean(scores), np.std(scores)))

CV accuracy: 0.965 +/- 0.025
- 也可以使用该方法比较模型。如比较SVM模型和决策树模型
from sklearn.tree import DecisionTreeClassifier

gs = GridSearchCV(estimator=DecisionTreeClassifier(random_state=0),

                  param_grid=[{'max_depth': [1, 2, 3, 4, 5, 6, 7, None]}],

                  scoring='accuracy',

                  cv=2)

scores = cross_val_score(gs, X_train, y_train, scoring='accuracy', cv=5)

print('CV accuracy: %.3f +/- %.3f' % (np.mean(scores), np.std(scores)))

CV accuracy: 0.921 +/- 0.029
sklearn中的model_selection模块(1)的更多相关文章
- sklearn中的metrics模块中的Classification metrics
metrics是sklearn用来做模型评估的重要模块,提供了各种评估度量,现在自己整理如下: 一.通用的用法:Common cases: predefined values 1.1 sklearn官 ...
- 决策树在sklearn中的实现
1 概述 1.1 决策树是如何工作的 1.2 构建决策树 1.2.1 ID3算法构建决策树 1.2.2 简单实例 1.2.3 ID3的局限性 1.3 C4.5算法 & CART算法 1.3.1 ...
- sklearn.model_selection模块
后续补代码 sklearn.model_selection模块的几个方法参数
- scikit-learn 0.18中的cross_validation模块被移除
环境:scikit-learn 0.18 , python3 from sklearn.cross_validation import train_test_split from sklearn.gr ...
- Sklearn 中的 CrossValidation 交叉验证
1. 交叉验证概述 进行模型验证的一个重要目的是要选出一个最合适的模型,对于监督学习而言,我们希望模型对于未知数据的泛化能力强,所以就需要模型验证这一过程来体现不同的模型对于未知数据的表现效果. 最先 ...
- 关于sklearn中的导包交叉验证问题
机器学习sklearn中的检查验证模块: 原版本导包: from sklearn.cross_validation import cross_val_score 导包报错: 模块继承在cross_va ...
- sklearn中的Pipeline
在将sklearn中的模型持久化时,使用sklearn.pipeline.Pipeline(steps, memory=None)将各个步骤串联起来可以很方便地保存模型. 例如,首先对数据进行了PCA ...
- 第十三次作业——回归模型与房价预测&第十一次作业——sklearn中朴素贝叶斯模型及其应用&第七次作业——numpy统计分布显示
第十三次作业——回归模型与房价预测 1. 导入boston房价数据集 2. 一元线性回归模型,建立一个变量与房价之间的预测模型,并图形化显示. 3. 多元线性回归模型,建立13个变量与房价之间的预测模 ...
- sklearn中的模型评估-构建评估函数
1.介绍 有三种不同的方法来评估一个模型的预测质量: estimator的score方法:sklearn中的estimator都具有一个score方法,它提供了一个缺省的评估法则来解决问题. Scor ...
随机推荐
- 软件工程 speedsnail 第二次冲刺10
20150527 完成任务:蜗牛碰到线后速度方向的调整:已经基本实现多方向的反射: 遇到问题: 问题1 反射角的问题 解决1 利用tan()三角函数 明日任务: 大总结.找到新问题.布置下一次冲刺方案
- 基础系列(4)—— C#装箱和拆箱
一 装箱和拆箱的概念 装箱是将值类型转换为引用类型 : 拆箱是将引用类型转换为值类型 : 值类型:包括原类型(Sbyte.Byte.Short.Ushort.Int.Uint.Long.Ulong.C ...
- linux普通用户被内存被限制的问题
把应用从root用户迁移到普通用户test,由于普通用户会被限制最大的进程数,当进程数占满后出现了下面的错误 /bin/bash: Resource temporarily unavailable. ...
- SQL中的declare用法
平时写SQL查询.存储过程都是凭着感觉来,没有探究过SQL的具体语法,一直都是按c#那一套往SQL上模仿,前几天项目中碰到一个问题引起了我对declare定义变量的作用域的兴趣. 大家都知道c#中的局 ...
- H Hip To Be Square Day5——NWERC2012
这个题目巨坑啊.调试的时间加起来绝对超过1天整. 不过终于调试出来了,真心感动地尿流满面啊. 题目的意思是给你一个区间[A,B],可以从区间里选出任意多个整数,使得这些整数的积是一个不超过 2^126 ...
- bzoj2429- 聪明的猴子
题意其实就是说有很多个点,求一组边把它们都连接起来,并且最大的那条边最小.很明显这就是一个最小生成树,是一颗保证最长边最短的树. 代码 刚刚学了个Borůvka算法,于是写了两个. Borůvka # ...
- 转---秒杀多线程第十二篇 多线程同步内功心法——PV操作上 (续)
PV操作的核心就是 PV操作可以同时起到同步与互斥的作用. 1.同步就是通过P操作获取信号量,V操作释放信号量来进行. 2.互斥其实就是,同时操作P操作,结束后进行V操作即可做到. Java上实现PV ...
- puthon进程开发
进程 本节目录 一 背景知识 二 什么是进程 三 进程调度 四 并发与并行 五 同步\异步\阻塞\非阻塞 六 进程的创建与结束 七 multiprocess模块 八 进程池和mutiprocess.P ...
- [六]SpringBoot 之 连接数据库(mybatis)
在进行配置之前首先要了解springboot是如何使用纯java代码方式初始化一个bean的 以前的版本是在xml中使用beans标签,在其里面配置bean,那么纯Java代码怎么实现呢? 答案就是使 ...
- Unity3D手游开发日记(1) - 移动平台实时阴影方案
阴影这个东西,说来就话长了,很多年前人们就开始研究出各种阴影技术,但都存在各种瑕疵和问题,直到近几年出现了PSSM,也就是CE3的CSM,阴影技术才算有个比较完美的解决方案.Unity自带的实时阴影, ...