
神经网络优化篇:详解神经网络的权重初始化(Weight Initialization for Deep NetworksVanishing / Exploding gradients)
神经网络的权重初始化
这是一个神经单元初始化地例子,然后再演变到整个深度网络。
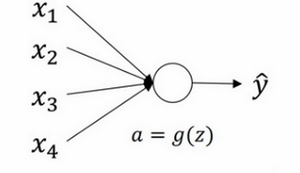
来看看只有一个神经元的情况,然后才是深度网络。
单个神经元可能有4个输入特征,从\(x_{1}\)到\(x_{4}\),经过\(a=g(z)\)处理,最终得到\(\hat{y}\),稍后讲深度网络时,这些输入表示为\(a^{[l]}\),暂时用\(x\)表示。
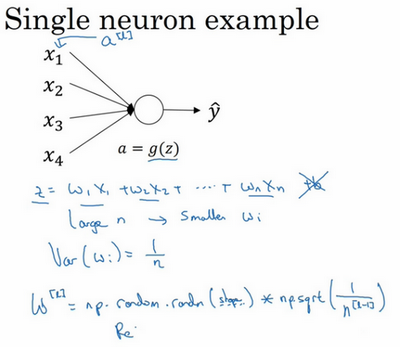
\(z = w_{1}x_{1} + w_{2}x_{2} + \ldots +w_{n}x_{n}\),\(b=0\),暂时忽略\(b\),为了预防\(z\)值过大或过小,可以看到\(n\)越大,希望\(w_{i}\)越小,因为\(z\)是\(w_{i}x_{i}\)的和,如果把很多此类项相加,希望每项值更小,最合理的方法就是设置\(w_{i}=\frac{1}{n}\),\(n\)表示神经元的输入特征数量,实际上,要做的就是设置某层权重矩阵\(w^{[l]} = np.random.randn( \text{shape})*\text{np.}\text{sqrt}(\frac{1}{n^{[l-1]}})\),\(n^{[l - 1]}\)就是喂给第\(l\)层神经单元的数量(即第\(l-1\)层神经元数量)。
结果,如果是用的是Relu激活函数,而不是\(\frac{1}{n}\),方差设置为\(\frac{2}{n}\),效果会更好。常常发现,初始化时,尤其是使用Relu激活函数时,\(g^{[l]}(z) =Relu(z)\),它取决于对随机变量的熟悉程度,这是高斯随机变量,然后乘以它的平方根,也就是引用这个方差\(\frac{2}{n}\)。这里,用的是\(n^{[l - 1]}\),因为本例中,逻辑回归的特征是不变的。但一般情况下\(l\)层上的每个神经元都有\(n^{[l - 1]}\)个输入。如果激活函数的输入特征被零均值和标准方差化,方差是1,\(z\)也会调整到相似范围,这就没解决问题(梯度消失和爆炸问题)。但它确实降低了梯度消失和爆炸问题,因为它给权重矩阵\(w\)设置了合理值,也知道,它不能比1大很多,也不能比1小很多,所以梯度没有爆炸或消失过快。
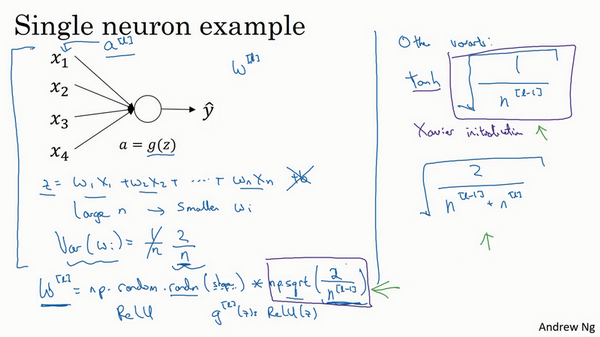
提到了其它变体函数,刚刚提到的函数是Relu激活函数,一篇由Herd等人撰写的论文曾介绍过。对于几个其它变体函数,如tanh激活函数,有篇论文提到,常量1比常量2的效率更高,对于tanh函数来说,它是\(\sqrt{\frac{1}{n^{[l-1]}}}\),这里平方根的作用与这个公式作用相同(\(\text{np.}\text{sqrt}(\frac{1}{n^{[l-1]}})\)),它适用于tanh激活函数,被称为Xavier初始化。Yoshua Bengio和他的同事还提出另一种方法,可能在一些论文中看到过,它们使用的是公式\(\sqrt{\frac{2}{n^{[l-1]} + n^{\left[l\right]}}}\)。其它理论已对此证明,但如果想用Relu激活函数,也就是最常用的激活函数,会用这个公式\(\text{np.}\text{sqrt}(\frac{2}{n^{[l-1]}})\),如果使用tanh函数,可以用公式\(\sqrt{\frac{1}{n^{[l-1]}}}\),有些作者也会使用这个函数。
实际上,认为所有这些公式只是给一个起点,它们给出初始化权重矩阵的方差的默认值,如果想添加方差,方差参数则是另一个需要调整的超级参数,可以给公式\(\text{np.}\text{sqrt}(\frac{2}{n^{[l-1]}})\)添加一个乘数参数,调优作为超级参数激增一份子的乘子参数。有时调优该超级参数效果一般,这并不是想调优的首要超级参数,但发现调优过程中产生的问题,虽然调优该参数能起到一定作用,但考虑到相比调优,其它超级参数的重要性,通常把它的优先级放得比较低。
希望现在对梯度消失或爆炸问题以及如何为权重初始化合理值已经有了一个直观认识,希望设置的权重矩阵既不会增长过快,也不会太快下降到0,从而训练出一个权重或梯度不会增长或消失过快的深度网络。在训练深度网络时,这也是一个加快训练速度的技巧。
神经网络优化篇:详解神经网络的权重初始化(Weight Initialization for Deep NetworksVanishing / Exploding gradients)的更多相关文章
- [深度学习] 权重初始化--Weight Initialization
深度学习中的weight initialization对模型收敛速度和模型质量有重要影响! 在ReLU activation function中推荐使用Xavier Initialization的变种 ...
- Andrej Karpathy | 详解神经网络和反向传播(基于 micrograd)
只要你懂 Python,大概记得高中学过的求导知识,看完这个视频你还不理解反向传播和神经网络核心要点的话,那我就吃鞋:D Andrej Karpathy,前特斯拉 AI 高级总监.曾设计并担任斯坦福深 ...
- PHP函数篇详解十进制、二进制、八进制和十六进制转换函数说明
PHP函数篇详解十进制.二进制.八进制和十六进制转换函数说明 作者: 字体:[增加 减小] 类型:转载 中文字符编码研究系列第一期,PHP函数篇详解十进制.二进制.八进制和十六进制互相转换函数说明 ...
- 走向DBA[MSSQL篇] 详解游标
原文:走向DBA[MSSQL篇] 详解游标 前篇回顾:上一篇虫子介绍了一些不常用的数据过滤方式,本篇详细介绍下游标. 概念 简单点说游标的作用就是存储一个结果集,并根据语法将这个结果集的数据逐条处理. ...
- Scala进阶之路-Scala函数篇详解
Scala进阶之路-Scala函数篇详解 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.传值调用和传名调用 /* @author :yinzhengjie Blog:http: ...
- 详解神经网络基础部件BN层
摘要:在深度神经网络训练的过程中,由于网络中参数变化而引起网络中间层数据分布发生变化的这一过程被称为内部协变量偏移(Internal Covariate Shift),而 BN 可以解决这个问题. 本 ...
- CentOS 7 下编译安装lnmp之PHP篇详解
一.安装环境 宿主机=> win7,虚拟机 centos => 系统版本:centos-release-7-5.1804.el7.centos.x86_64 二.PHP下载 官网 http ...
- CentOS 7 下编译安装lnmp之MySQL篇详解
一.安装环境 宿主机=> win7,虚拟机 centos => 系统版本:centos-release-7-5.1804.el7.centos.x86_64 二.MySQL下载 MySQL ...
- CentOS 7 下编译安装lnmp之nginx篇详解
一.安装环境 宿主机=> win7,虚拟机 centos => 系统版本:CentOS Linux release 7.5.1804 (Core),ip地址 192.168.1.168 ...
- Android开发之线性布局详解(布局权重)
布局权重 线性布局支持给个别的子视图设定权重,通过android:layout_weight属性.就一个视图在屏幕上占多大的空间而言,这个属性给其设 定了一个重要的值.一个大的权重值,允许它扩大到填充 ...
随机推荐
- 【AI 模型】首个 Joy 模型诞生!!!全民生成 Joy 大片
接上一篇文章 "只要10秒,AI生成IP海报,解放双手",这次是全网第一个"共享joy模型",真的赚到了! 经过这段时间无数次的探索.试错.实验,最终积累了非常 ...
- How to start with Gradle?
How to start with Gradle? Download the latest Gradle release from http://www.gradle.org/downloads Se ...
- 软件开发人员 Kubernetes 入门指南|Part 2
在第 1 部分中,我们讲解了 Kubernetes 的核心组件,Kubernetes 是一种开源容器编排器,用于在分布式环境中部署和扩展应用程序:我们还讲解了如何在集群中部署一个简单的应用程序,然后更 ...
- 普冉PY32系列(八) GPIO模拟和硬件SPI方式驱动无线收发芯片XN297LBW
目录 普冉PY32系列(一) PY32F0系列32位Cortex M0+ MCU简介 普冉PY32系列(二) Ubuntu GCC Toolchain和VSCode开发环境 普冉PY32系列(三) P ...
- 记一次MySQL5初始化被kill的问题排查
写在前面 由于测试环境JED申请比较繁琐,所以Eone提供了单机版Mysql供用户使用,近期Eone搭建Mysql5的时候发现莫名被kill了,容器规格是4C8G,磁盘30G 这不科学,之前都是可以的 ...
- GameFramework摘录 - 3. 使用interface定义对外接口
GameFramework的模块密封性相当好,如果使用unity的assemblydef,其设计可以把框架项目与自己的游戏逻辑分离开来. 除一些常用的基类.枚举等,核心模块设置为internal权限, ...
- 让物体动起来,Unity的几种移动方式
一.前言 在大部分的Unity游戏开发中,移动是极其重要的一部分,移动的手感决定着游戏的成败,一个优秀的移动手感无疑可以给游戏带来非常舒服的体验.而Unity中有多种移动方法,使用Transform, ...
- 使用单卡v100 32g或更低显存的卡,使用peft工具qlora或lora混合精度训练大模型chatGLM2-6b,torch混合精度加速稳定训练,解决qlora loss变成nan的问题!
最近新换了工作,以后的工作内容会和大模型相关,所以先抽空跑了一下chatGLM2-6b的demo,使用Qlora或lora微调模型 今天简单写个文档记录一下,顺便也是一个简单的教程,并且踩了qlora ...
- Kubernetes:kube-apiserver 和 etcd 的交互
kubernetes:kube-apiserver 系列文章: Kubernetes:kube-apiserver 之 scheme(一) Kubernetes:kube-apiserver 之 sc ...
- [WPF]浅析资源引用(pack URI)
WPF中我们引用资源时常常提到一个概念:pack URI,这是WPF标识和引用资源最常见的方式,但不是唯一的方式.本文将介绍WPF中引用资源的几种方式,并回顾一下pack URI标识引用在不同位置的资 ...