
“达观杯”文本分类--baseline
结合tfidf权重,对“达观杯”提供的文本,进行文本分类,作为baseline,后续改进均基于此。
1.比赛地址及数据来源
2.代码及解析
# -*- coding: utf-8 -*-

"""

@简介:tfidf特征/ SVM模型

@成绩: 0.77

"""

#导入所需要的软件包

import pandas as pd

from sklearn.svm import LinearSVC

from sklearn.feature_extraction.text import TfidfVectorizer

print("开始...............")

#====================================================================================================================

# @代码功能简介:从硬盘上读取已下载好的数据,并进行简单处理

# @知识点定位:数据预处理

#====================================================================================================================

df_train = pd.read_csv('./data/train_set.csv')  # 数据读取

df_test = pd.read_csv('./data/test_set.csv')

# 观察数据,原始数据包含id、article(原文)列、word_seg(分词列)、class(类别标签)

df_train.drop(columns=['article', 'id'], inplace=True) # drop删除列

df_test.drop(columns=['article'], inplace=True)

#==========================================================

# @代码功能简介:将数据集中的字符文本转换成数字向量,以便计算机能够进行处理(一段文字 ---> 一个向量)

# @知识点定位:特征工程

#==========================================================

vectorizer = TfidfVectorizer(ngram_range=(1, 2), min_df=3, max_df=0.9)

'''

    ngram_range=(1, 2) : 词组长度为1和2

    min_df : 忽略出现频率小于3的词

    max_df : 忽略在百分之九十以上的文本中出现过的词

'''

vectorizer.fit(df_train['word_seg'])  # 构造tfidf矩阵

x_train = vectorizer.transform(df_train['word_seg'])  # 构造训练集的tfidf矩阵

x_test = vectorizer.transform(df_test['word_seg'])  # 构造测试的tfidf矩阵

y_train = df_train['class']-1 #训练集的类别标签(减1方便计算)

#==========================================================

# @代码功能简介:训练一个分类器

# @知识点定位:传统监督学习算法之线性逻辑回归模型

#==========================================================

classifier = LinearSVC()  # 实例化逻辑回归模型

classifier.fit(x_train, y_train)  # 模型训练,传入训练集及其标签

#根据上面训练好的分类器对测试集的每个样本进行预测

y_test = classifier.predict(x_test)

#将测试集的预测结果保存至本地

df_test['class'] = y_test.tolist()

df_test['class'] = df_test['class'] + 1

df_result = df_test.loc[:, ['id', 'class']]

df_result.to_csv('./results/beginner.csv', index=False)

print("完成...............")
3.问题修复
由于提供的数据集较大,一般运行时间再10到15分钟之间,基础电脑配置在4核8G的样子(越消耗内存在6.2G),因此,一般可能会遇到内存溢出的错误。
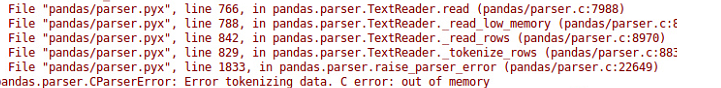
可限制每次读取的数据量,具体解决办法如下:
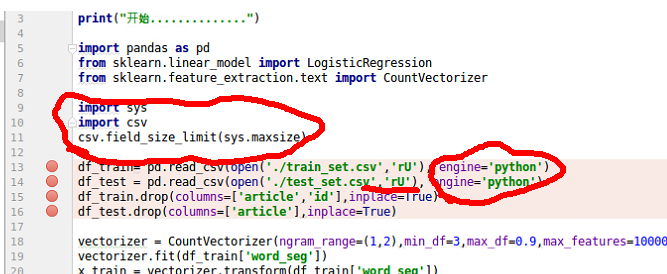
当然,你也可以换一个配置更高的电脑。
“达观杯”文本分类--baseline的更多相关文章
- Bert文本分类实践(一):实现一个简单的分类模型
写在前面 文本分类是nlp中一个非常重要的任务,也是非常适合入坑nlp的第一个完整项目.虽然文本分类看似简单,但里面的门道好多好多,作者水平有限,只能将平时用到的方法和trick在此做个记录和分享,希 ...
- Bert文本分类实践(二):魔改Bert,融合TextCNN的新思路
写在前面 文本分类是nlp中一个非常重要的任务,也是非常适合入坑nlp的第一个完整项目.虽然文本分类看似简单,但里面的门道好多好多,博主水平有限,只能将平时用到的方法和trick在此做个记录和分享 ...
- python - 实现文本分类[简单使用第三方库完成]
第三方库 pandas sklearn 数据集 来自于达观杯 训练:train.txt 测试:test.txt 概述 TF-IDF 模型提取特征值建立逻辑回归模型 代码 # _*_ coding:ut ...
- 在 TensorFlow 中实现文本分类的卷积神经网络
在TensorFlow中实现文本分类的卷积神经网络 Github提供了完整的代码: https://github.com/dennybritz/cnn-text-classification-tf 在 ...
- fastText文本分类算法
1.概述 FastText 文本分类算法是有Facebook AI Research 提出的一种简单的模型.实验表明一般情况下,FastText 算法能获得和深度模型相同的精度,但是计算时间却要远远小 ...
- FastText 文本分类使用心得
http://blog.csdn.net/thriving_fcl/article/details/53239856 最近在一个项目里使用了fasttext[1], 这是facebook今年开源的一个 ...
- NLP(七) 信息抽取和文本分类
命名实体 专有名词:人名 地名 产品名 例句 命名实体 Hampi is on the South Bank of Tungabhabra river Hampi,Tungabhabra River ...
- NLP(十六)轻松上手文本分类
背景介绍 文本分类是NLP中的常见的重要任务之一,它的主要功能就是将输入的文本以及文本的类别训练出一个模型,使之具有一定的泛化能力,能够对新文本进行较好地预测.它的应用很广泛,在很多领域发挥着重要 ...
- 基于Text-CNN模型的中文文本分类实战 流川枫 发表于AI星球订阅
Text-CNN 1.文本分类 转眼学生生涯就结束了,在家待就业期间正好有一段空闲期,可以对曾经感兴趣的一些知识点进行总结. 本文介绍NLP中文本分类任务中核心流程进行了系统的介绍,文末给出一个基于T ...
随机推荐
- Spark集群安装与配置
一.Scala安装 1.https://www.scala-lang.org/download/2.11.12.html下载并复制到/home/jun下解压 [jun@master ~]$ cd sc ...
- Java IO编程——字符流与字节流
在java.io包里面File类是唯一 一个与文件本身有关的程序处理类,但是File只能够操作文件本身而不能够操作文件的内容,或者说在实际的开发之中IO操作的核心意义在于:输入与输出操作.而对于程序而 ...
- vue订阅者模式
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- 在vue中使用Ueditor
今天研究的主角是:UEditor UEditor是由百度WEB前端研发部开发的所见即所得的开源富文本编辑器,具有轻量.可定制.用户体验优秀等特点. 版本有很多 我用的是:[1.4.3.3 PHP 版本 ...
- fenby C语言 P28
#include <stdio.h> int main(){ int *p1,*p2,a=10,b=20,c; p1=&a; p2=&b; if(a<b) { c=a ...
- Python环境的搭建(windows系统)
1.首先访问http://www.python.org/download/去下载最新的python版本. 2.安装下载包,一路next. 3.为计算机添加安装目录搭到环境变量,如图把python的安装 ...
- Pycharm 专业版激活码(转) 有效期到2020/06月
亲测有效!!! 有效期截止为2020年06月,多谢大家支持与讨论! K6IXATEF43-eyJsaWNlbnNlSWQiOiJLNklYQVRFRjQzIiwibGljZW5zZWVOYW1lIjo ...
- 【MySQL】MySQL服务启动失解决方法
写在前面的话:前段时间,为了更加流畅愉快的玩PUBG,我在任务管理器中,关闭了mysqld服务.后来我在使用MySQL数据库服务的时候,发现去到MySQL安装目录下双击运行mysqld.exe(数据库 ...
- Android H5混合开发(3):原生Android项目里嵌入Cordova
前言 如果安卓项目已经存在了,那么如何使用Cordova做混合开发? 方案1(适用于插件会持续增加或变化的项目): 新建Cordova项目并添加Android平台,把我们的安卓项目导入Android平 ...
- [翻译]——MySQL 8.0 Histograms
前言: 本文是对这篇博客MySQL 8.0 Histograms的翻译,翻译如有不当的地方,敬请谅解,请尊重原创和翻译劳动成果,转载的时候请注明出处.谢谢! 英文原文地址:https://lefred ...