
Hadoop MapReduce的Shuffle过程
一、概述
理解Hadoop的Shuffle过程是一个大数据工程师必须的,笔者自己将学习笔记记录下来,以便以后方便复习查看。
二、
MapReduce确保每个reducer的输入都是按键排序的。系统执行排序、将map输出作为输入传给reducer的过程称为Shuffle。
2.1 map端
map函数开始产生输出时,利用缓冲的方式写到内存并排序具体分一下几个步骤。
1.map数据分片:把输入数据源进行分片,根据分片来决定有多少个map,每个map任务都有一个环形内存缓冲区用于存储任务输出,默认情况下缓冲区大小为100MB,可通过mapreduce.task.io.sort.mb来调整。
2.map排序:当map缓冲区大小达到阈值时(mapreduce.map.sort.spill.percent),就会将内存的数据溢写到磁盘,根据reducer的来划分成相应的partition,在内存中按键值进行排序,如果有combiner函数,在排序后就会应用,排序后写入分区磁盘文件中。溢写的过程中,map会阻塞直到写磁盘过程完成。每次内存缓冲区到达溢出阈值,就会新建一个溢出文件件,在map写完最后一个输出记录之后,会有几个溢出文件,在任务完成之前溢出文件会被合并成一个已分区且已经排序的输出文件。mapreduce.task.io.sort.factor控制着一次最多能合并多少溜,默认10。mapreduce.map.output.compress进行压缩,提高写磁盘速度。
2.2reduce端
1.reduce复制:reducer通过http得到输出文件的分区,用于文件分区的工作线程数量由任务的mapreduce.shuffle.max.threads属性控制。每个map任务的完成时间不同,在每个任务完成时,reduce任务就开始复制其输出,这就是reduce任务的复制阶段,reduce的复制线程数量mapreduce.reduce.shuffle.parallelcopies决定。
复制详解:如果map输出很小,会被复制到reduce任务JVM的内存,否则输出被复制到磁盘。如果内存缓冲区达到阈值大小(mapreduce.reduce.shuffle.merge.percent)或达到map输出阈值(mapreduce.reduce.merge.inmem.threshold),则合并溢出写到磁盘中,如果指定combiner,则在合并期间运行它。随着磁盘上副本增多,后台线程会将他们合并为更大的,排序的文件。
2.reduce合并排序:这个阶段合并map输出,维持其顺序排序,这是循环进行的,如果有50个map输出,合并因子是10(mapreduce.task.io.sort.factor),合并将进行5次,最后有5个中间文件。
3.reduce:直接把数据输入reduce函数,从而省略了一次磁盘的往返行程。
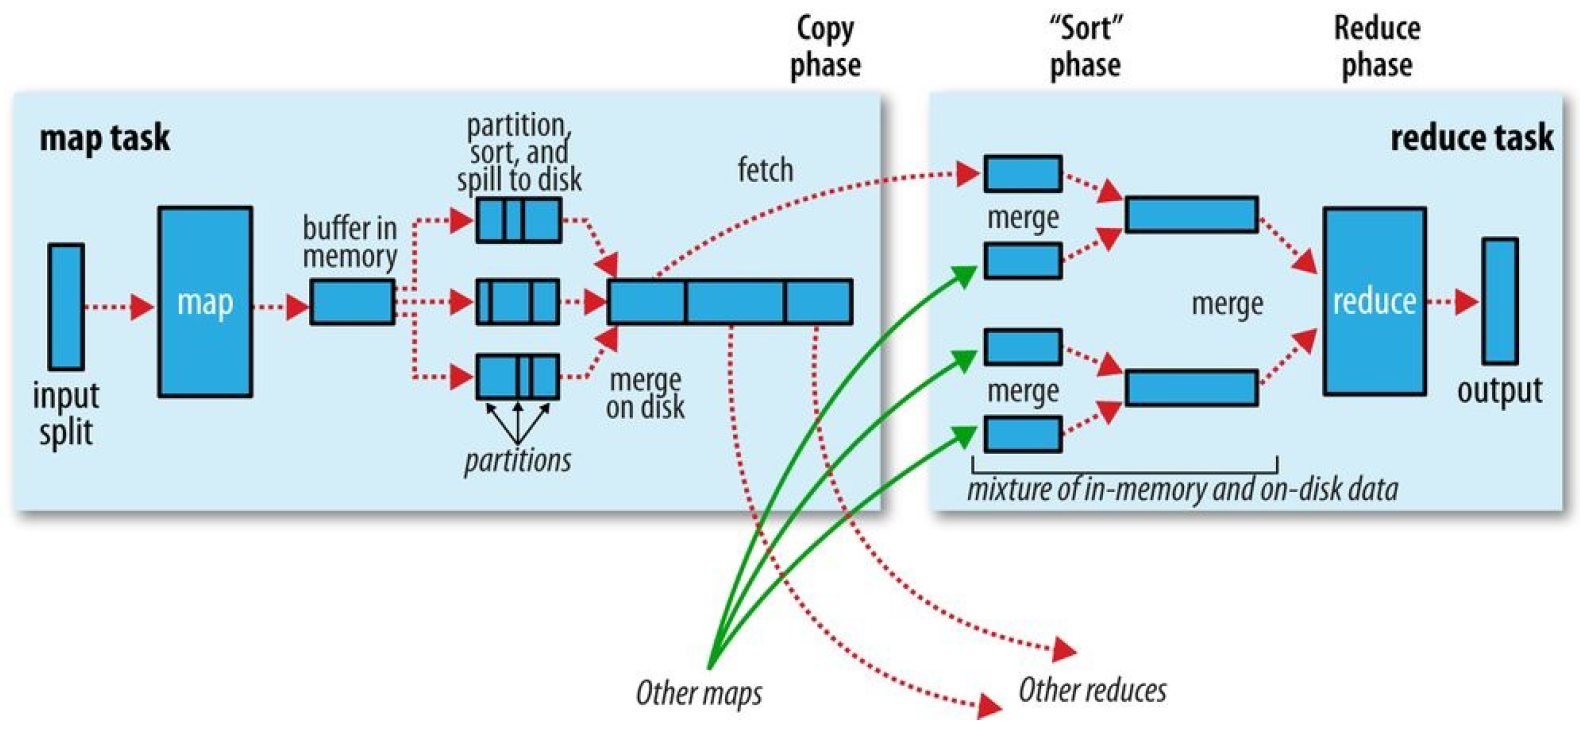
至此mapreduce过程完毕,具体参考Hadoop权威指南第四版。
Hadoop MapReduce的Shuffle过程的更多相关文章
- Hadoop Mapreduce的shuffle过程详解
1.map task读取数据时默认调用TextInputFormat的成员RecoreReader,RecoreReader调用自己的read()方法,进行逐行读取,返回一个key.value; 2. ...
- MapReduce的Shuffle过程介绍
MapReduce的Shuffle过程介绍 Shuffle的本义是洗牌.混洗,把一组有一定规则的数据尽量转换成一组无规则的数据,越随机越好.MapReduce中的Shuffle更像是洗牌的逆过程,把一 ...
- Hadoop学习之shuffle过程
转自:http://langyu.iteye.com/blog/992916,多谢分享,学习Hadopp性能调优的可以多关注一下 Shuffle过程是MapReduce的核心,也被称为奇迹发生的地方, ...
- MapReduce:Shuffle过程详解
1.Map任务处理 1.1 读取HDFS中的文件.每一行解析成一个<k,v>.每一个键值对调用一次map函数. <0,hello you> & ...
- Hadoop Mapreduce中shuffle 详解
MapReduce 里面的shuffle:描述者数据从map task 输出到reduce task 输入的这段过程 Shuffle 过程: 首先,map 输出的<key,value > ...
- mapReduce的shuffle过程
http://www.jianshu.com/p/c97ff0ab5f49 总结shuffle 过程: map端的shuffle: (1)map端产生数据,放入内存buffer中: (2)buffer ...
- MapReduce 的 shuffle 过程中经历了几次 sort ?
shuffle 是从map产生输出到reduce的消化输入的整个过程. 排序贯穿于Map任务和Reduce任务,是MapReduce非常重要的一环,排序操作属于MapReduce计算框架的默认行为,不 ...
- Hadoop Mapreduce中wordcount 过程解析
将文件split 文件1: 分割结果: hello world ...
- MapReduce的shuffle过程详解
[学习笔记] 结果分析:shuffle的英文是洗牌,混洗的意思,洗牌就是越乱越好的意思.当在集群的情况下是这样的,假如有三个map节点和三个reduce节点,一号reduce节点的数据会来自于三个ma ...
随机推荐
- 算法与数据结构基础 - 堆栈(Stack)
堆栈基础 堆栈(stack)具有“后进先出”的特性,利用这个特性我们可以用堆栈来解决这样一类问题:后续的输入会影响到前面的阶段性结果.线性地遍历输入并用stack处理,这类问题较简单,求解时间复杂度一 ...
- Programming In Lua 第六章
1, 2, 3,
- 32| 无实例无真相:基于LoadRunner实现企业级服务器端性能测试的实践(上)
- Java上机题(封装)(编写student类)
今天帮大一的童鞋写Java上机题 题目虽然很简单,但是刚拿到题目的时候愣了一下,然后就疯狂get set QuQ 其实这是一个特别基本的封装的题目(之前实验室面试大二的时候竟然还有蛮多人不知道封装的概 ...
- Appium+python自动化(十八)- 你难道是猴哥失散多年的混血弟弟还是妹妹???- Monkey事件(超详解)
操作事件简介 Monkey所执行的随机事件流中包含11大事件,分别是触摸事件.手势事件.二指缩放事件.轨迹事件.屏幕旋转事件.基本导航事件.主要导航事件.系统按键事件.启动Activity事件.键盘事 ...
- Weblogic 'wls-wsat' XMLDecoder 反序列化_CVE-2017-10271漏洞复现
Weblogic 'wls-wsat' XMLDecoder 反序列化_CVE-2017-10271漏洞复现 一.漏洞概述 WebLogic的 WLS Security组件对外提供webservic ...
- c++ 二分答案
c++ 二分答案 问题 使得x^x达到或超过n位数字的最小正整数x是多少?n<=2000000000 分析 对与这种较难求解的问题,我们很难想出较好的解决策略.但是,我们至少知道答案一定在1与2 ...
- 嵊州D2T1 “我只是来打个电话”
嵊州D2T1 “我只是来打个电话” 精神病院有一个这样的测试. 给出一个正整数集合,集合中的数各不相同,然后要求病人回答: 其中有多少个数,恰好等于集合中另外两个(不同的)数之和? 回答正确的人,即可 ...
- Greenplum主备节点切换
1. 场景描述 Greenplum主节点出现故障,需要将standby节点手动切换为master节点,当master节点修复完成后,再将新修复的master节点设置为standyb节点加入到集群中. ...
- [HNOI2011]数学作业 题解
这道题看着挺难然而其实看破了也挺容易的.首先N极其的大,几乎要炸掉long long ,所以O(n)的算法一定是扑街了,身为一个脑残志坚的OIer,怎能不想到矩阵快速幂优化呢? 有趣的是这道题矩阵有很 ...