
Python3.x:Selenium+PhantomJS爬取带Ajax、Js的网页及获取JS返回值
前言
现在很多网站的都大量使用JavaScript,或者使用了Ajax技术。这样在网页加载完成后,url虽然不改变但是网页的DOM元素内容却可以动态的变化。如果处理这种网页是还用requests库或者python自带的urllib库那么得到的网页内容和网页在浏览器中显示的内容是不一致的。
解决方案
使用Selenium+PhantomJS。这两个组合在一起,可以运行非常强大的爬虫,可以处理cookie,JavaScript,header以及其他你想做的任何事情。
安装第三方库
Selenium是一个强大的网络数据采集工具,最初是为网站自动化测试开发的,其有对应的Python库;
Selenium安装命令:
pip install selenium
安装PhantomJS
PhantomJS是一个基于webkit内核的无头浏览器,即没有UI界面,即它就是一个浏览器,只是其内的点击、翻页等人为相关操作需要程序设计实现。通过编写js程序可以直接与webkit内核交互,在此之上可以结合java语言等,通过java调用js等相关操作。需要去官网下载对应平台的压缩文件;
PhantomJS(phantomjs-2.1.1-windows)下载地址:http://phantomjs.org/download.html,按照不同的系统选择相应的版本
对windows系统来说,下载PhantomJs 然后将 解压后的执行文件放在被设置过环境变量的地方,不设置的话,后续代码就要设, 所以这里直接放进来方便;

然后检测下,在cmd窗口输入phantomjs:

出现这样的画面,即表示成功;
对Mac系统来说,下载后保存到一个路径中,可以直接保存在环境变了路径中,也可以在环境变量路径中创建一个指向phantomjs的软连接
ln -s /usr/local/opt/my/phantomjs-2.1.1-macosx/bin/phantomjs /usr/local/bin
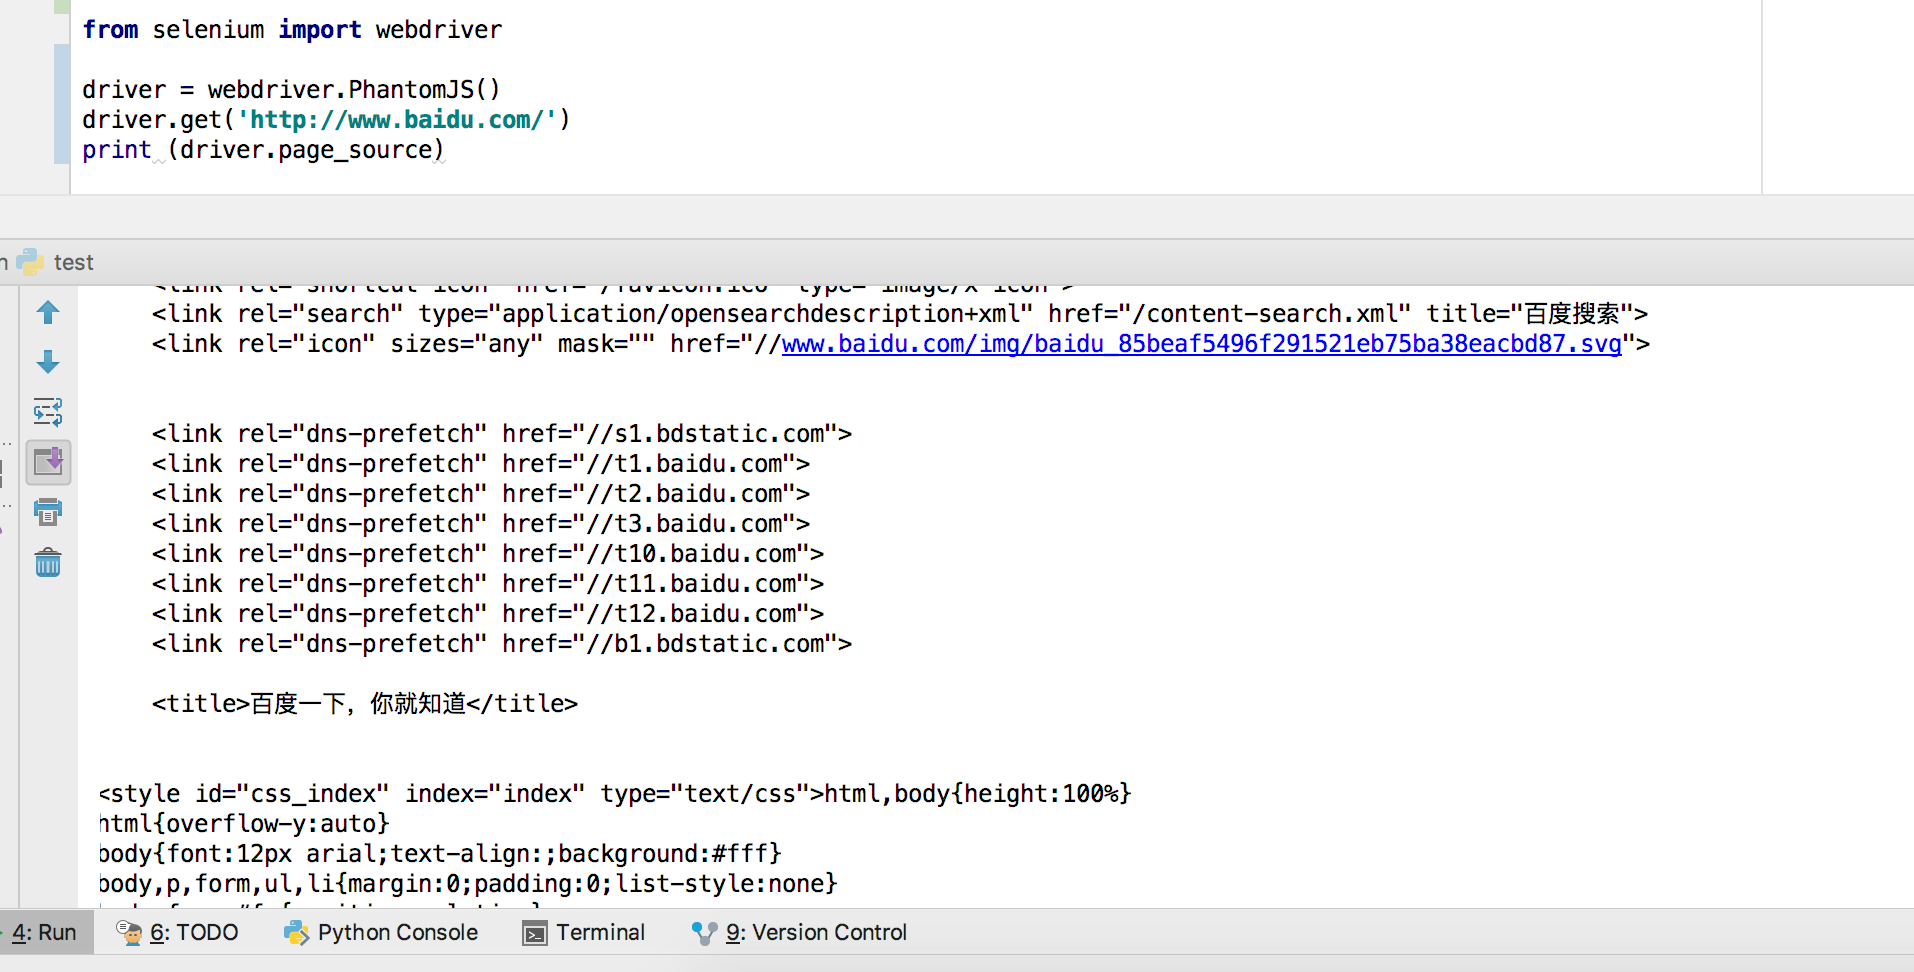
测试代码:
from selenium import webdriver

driver = webdriver.PhantomJS()

driver.get('http://www.baidu.com/')

print (driver.page_source)
能成功获取到页面元素即为安装成功
示例一:
Selenium+PhantomJS示例代码:
from selenium import webdriver

driver = webdriver.PhantomJS()

driver.get('http://www.cnblogs.com/feng0815/p/8735491.html')

#获取网页源码

data = driver.page_source

print(data)

#获取元素的html源码

tableData = driver.find_elements_by_tag_name('tableData').get_attribute('innerHTML')

#获取元素的id值

tableI = driver.find_elements_by_tag_name('tableData').get_attribute('id')

#获取元素的文本内容

tableI = driver.find_elements_by_tag_name('tableData').text

driver.quit()
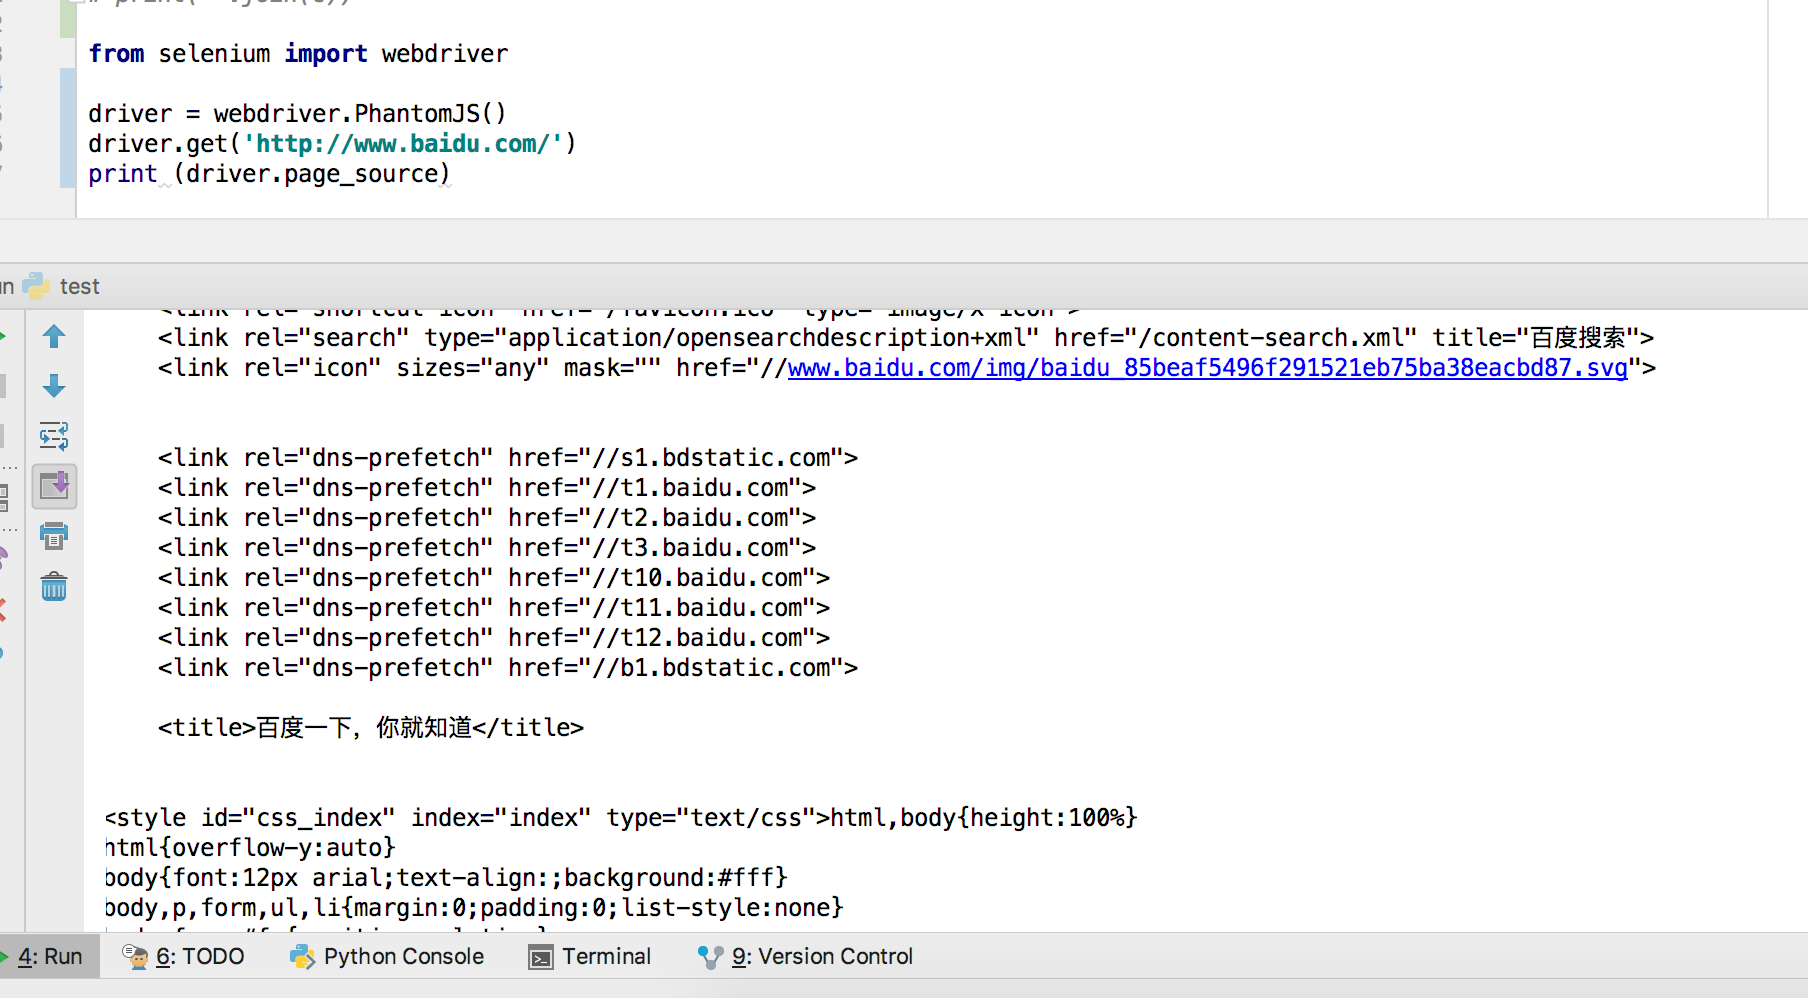
能输出网页源码,说明安装成功
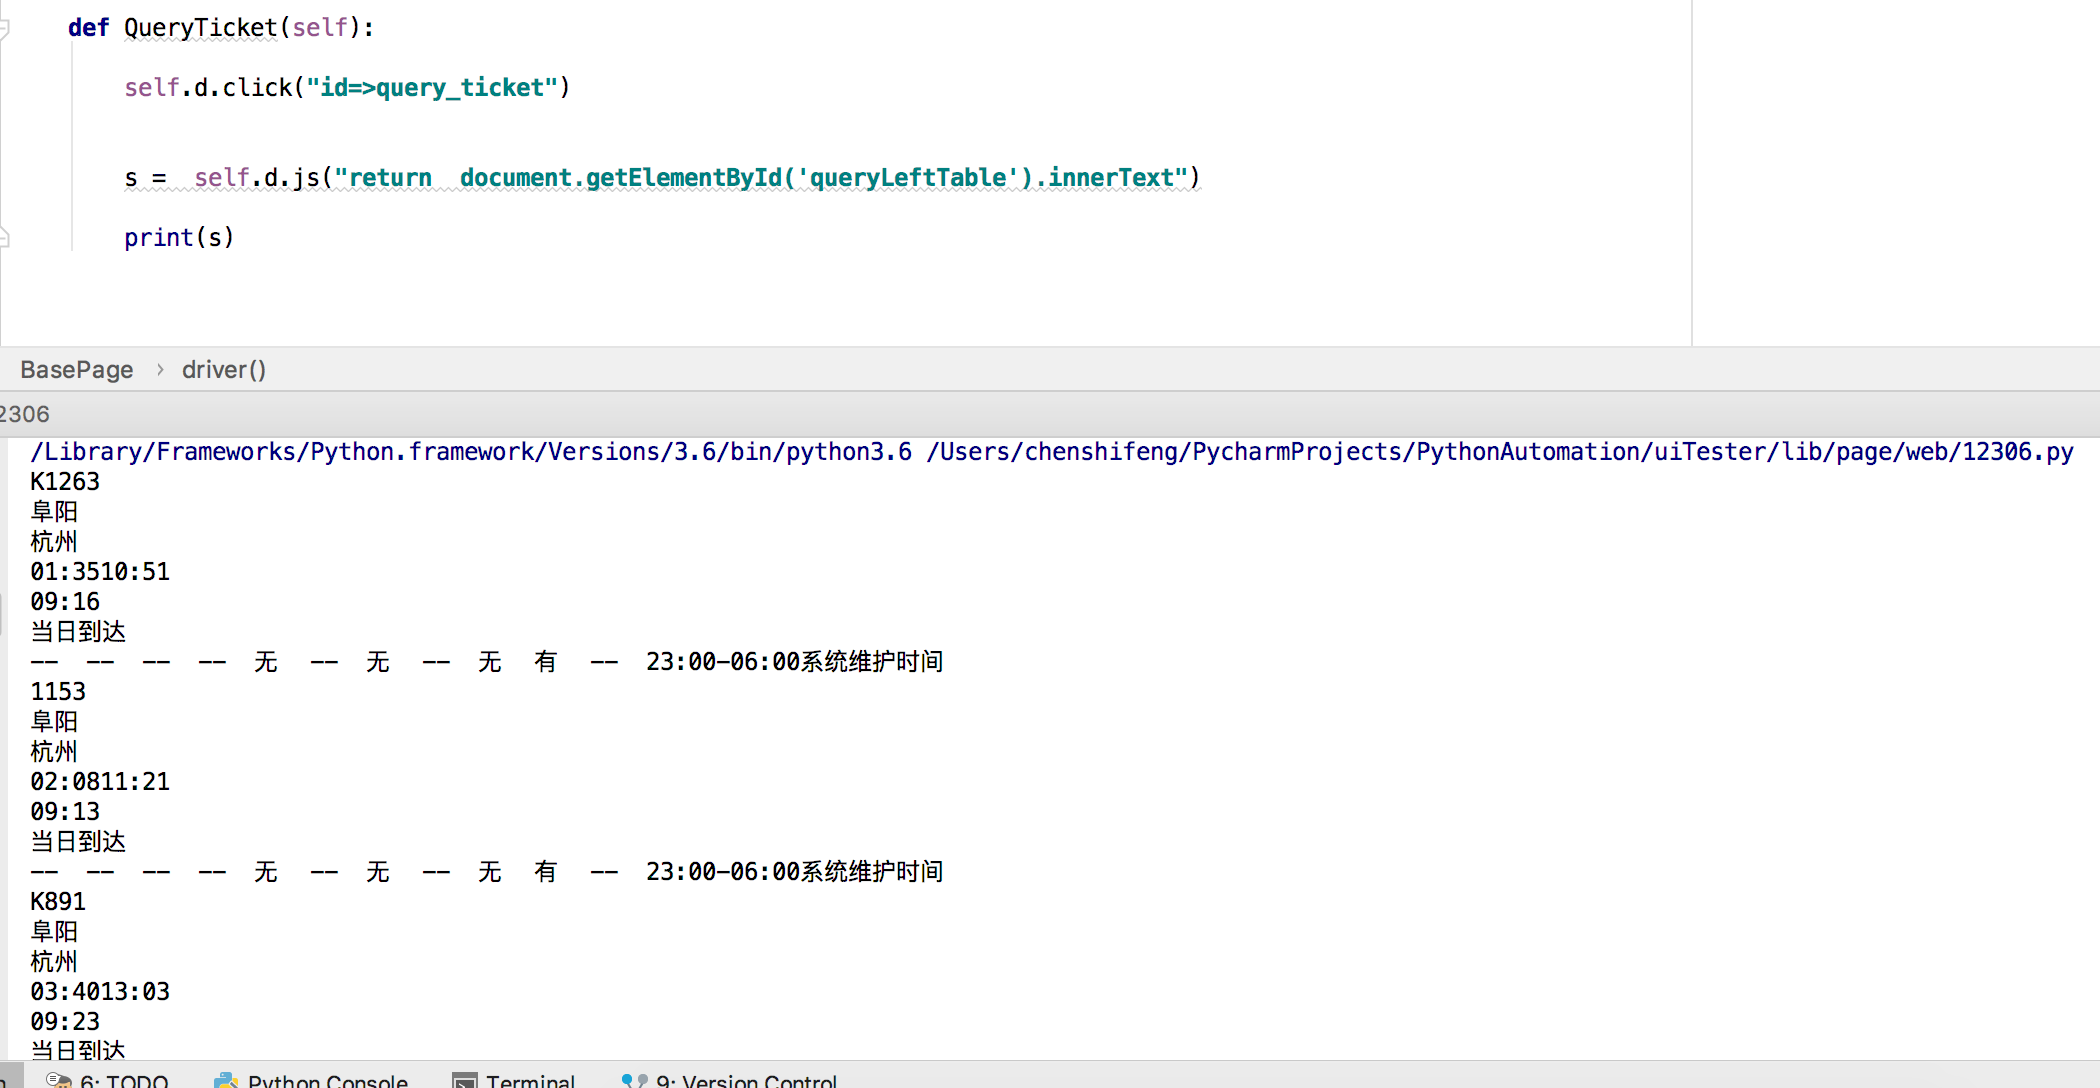
获取JS返回值
Python3.x:Selenium+PhantomJS爬取带Ajax、Js的网页及获取JS返回值的更多相关文章
- Python3.x:Selenium+PhantomJS爬取带Ajax、Js的网页
Python3.x:Selenium+PhantomJS爬取带Ajax.Js的网页 前言 现在很多网站的都大量使用JavaScript,或者使用了Ajax技术.这样在网页加载完成后,url虽然不改变但 ...
- selenium+phantomjs爬取京东商品信息
selenium+phantomjs爬取京东商品信息 今天自己实战写了个爬取京东商品信息,和上一篇的思路一样,附上链接:https://www.cnblogs.com/cany/p/10897618. ...
- selenium+phantomjs爬取bilibili
selenium+phantomjs爬取bilibili 首先我们要下载phantomjs 你可以到 http://phantomjs.org/download.html 这里去下载 下载完之后解压到 ...
- python+selenium+PhantomJS爬取网页动态加载内容
一般我们使用python的第三方库requests及框架scrapy来爬取网上的资源,但是设计javascript渲染的页面却不能抓取,此时,我们使用web自动化测试化工具Selenium+无界面浏览 ...
- selenium + PhantomJS 爬取js页面
from selenium import webdriver import time _url="http://xxxxxxxx.com" driver = webdriver.P ...
- Selenium+PhantomJs 爬取网页内容
利用Selenium和PhantomJs 可以模拟用户操作,爬取大多数的网站.下面以新浪财经为例,我们抓取新浪财经的新闻版块内容. 1.依赖的jar包.我的项目是普通的SSM单间的WEB工程.最后一个 ...
- selenium + phantomjs 爬取落网音乐
题记: 作为一个业余程序猿,最大的爱好就是电影和音乐了,听音乐当然要来点有档次的.落网的音乐的逼格有点高,一听听了10年.学习python一久了,于是想用python技术把落网的音乐爬下来随便听. 目 ...
- 看我怎么扒掉CSDN首页的底裤(python selenium+phantomjs爬取CSDN首页内容)
这里只是学习一下动态加载页面内容的抓取,并不适用于所有的页面. 使用到的工具就是python selenium和phantomjs,另外调试的时候还用了firefox的geckodriver.exe. ...
- selenium+phantomjs爬取动态页面数据
1.安装selenium pip/pip3 install selenium 注意依赖关系 2.phantomjs for windows 下载地址:http://phantomjs.org/down ...
随机推荐
- vue路由的配置
一.准备工作 1安装vue-cli npm install vue-cli -g 2检查是否安装成功 vue -V(大写V) 3初始化一个新的项目 vue init webpack vue-dem ...
- Java并发编程(十三)线程间协作的两种方式:wait、notify、notifyAll和Condition
在现实中,需要线程之间的协作.比如说最经典的生产者-消费者模型:当队列满时,生产者需要等待队列有空间才能继续往里面放入商品,而在等待的期间内,生产者必须释放对临界资源(即队列)的占用权.因为生产者如果 ...
- Kotlin入门(4)声明与操作数组
上一篇文章介绍了基本变量类型在Kotlin中的用法,不过这只针对单个变量,如果要求把一组相同类型的变量排列起来,形成一个变量数组,那又该如何声明和操作呢? 在Java中声明数组,跟在C语言中声明是一样 ...
- JavaWeb:Listener和Filter
本文内容: Listener Filter 首发日期:2018-07-15 Listener 监听器Listener负责监听事件的发生.我们能在事件发生后执行一些自定义的操作,这就是监听器的意义. 监 ...
- 12、多线程:Threading、守护线程
线程与进程: 线程对于进程来说,就好似工厂里的工人,分配资源是分配到工厂,工人再去处理. 线程是被系统独立调度和分派的基本单位,线程自己不拥有系统资源,只拥有一点儿在运行中必不可少的资源,但它可与同属 ...
- 12-openldap使用AD密码
阅读视图 本文严重参考 Openldap 整合windows AD认证 本文其他参考 OpenLDAP使用AD密码 Configuring OpenLDAP pass-through authenti ...
- C#微信公众号开发——获取access_token
access_token是公众号的全局唯一票据,公众号调用各接口时都需使用access_token.正常情况下access_token有效期为7200秒(两个小时),微信获取access_token接 ...
- SQL SERVER孤立帐号的处理
Step1:查询 Use KSHR_F23 Go exec sp_change_users_login @Action='Report' Go Step2:处理 Use KSHR_F23 Go exe ...
- Chrome 百度搜索热点过滤插件 - 开源软件
学习时,为了搜集最全的中文资料,有时候不得不使用Baidu搜索引擎.在你还是个小菜鸡的时候你可能会花费大量时间在百度上! 但是,时间久了你会发现,你总会被网络上一些奇奇怪怪或者有趣的事情吸引过去而逐渐 ...
- Linux运维之每日小技巧-检测网站状态以及PV、UV等介绍
[root@ELK-chaofeng07 httpd]# curl -o /dev/null -w %{http_code}\\n -s www.baidu.com 状态码为200表示成功. PV.U ...