
使用nodejs的puppeteer库爬取瓜子二手车网站
const puppeteer = require('puppeteer');

(async () => {

    const fs = require("fs");

    const rootUrl = 'https://www.guazi.com'

    const workPath = './contents';

    if (!fs.existsSync(workPath)) {

        fs.mkdirSync(workPath)

    }

    const browser = await (puppeteer.launch({ headless: false }));

    const page = await browser.newPage()

    await page.setViewport({ width: 1128, height: 736 });

    await page.setRequestInterception(true); // 拦截器

    page.on('request', request => { //拦截图片

        if (request.resourceType() === 'image')

            request.abort();

        else

            request.continue();

    });

    await page.goto("https://www.guazi.com/fuzhou/buy")

    const m_cityList = await page.evaluate(() => { //           获取所有城市

        const elements = Array.from(document.querySelectorAll('.all-city dl'))

        return elements.map(s => {

            let dd = s.getElementsByTagName("dd").item(0)

            let ddList = []

            for (let i = 0; i < dd.getElementsByTagName("a").length; i++) {

                ddList.push({

                    "cityName": dd.getElementsByTagName("a").item(i).innerHTML,

                    "url": dd.getElementsByTagName("a").item(i).getAttribute("href")

                })

            }

            return ddList

        })

    })

    //数组扁平化

    const flattenNew = arr => arr.reduce((prev, next) => Object.prototype.toString.call(next) == '[object Array]' ? prev.concat(flattenNew(next)) : prev.concat(next), [])

    const cityList = flattenNew(m_cityList)

    console.log("城市列表爬取完毕")

    await page.waitFor(2000 + Math.round(Math.random() * 100))

    for (let i = 0; i < cityList.length; i++) {

        await page.waitFor(1000 + Math.round(Math.random() * 100))

        await page.goto(rootUrl + cityList[i].url)

        console.log("跳转到" + cityList[i].cityName)

        console.log("开始爬取" + cityList[i].cityName + "的所有二手车品牌")

        try {

            let brandList = await page.evaluate(() => {  //品牌

                let Array = []

                const dl = document.querySelectorAll('.screen').item(0).getElementsByTagName("dl")

                const div = dl.item(0).getElementsByTagName("dd").item(0).getElementsByTagName("div").item(1)

                const ul = div.getElementsByTagName("ul")

                for (let i = 0; i < ul.length; i++) {

                    let li = ul.item(i).getElementsByTagName("li")

                    for (let j = 0; j < li.length; j++) {

                        let a = li.item(j).getElementsByTagName("p").item(0).getElementsByTagName("a")

                        for (let k = 0; k < a.length; k++) {

                            Array.push({

                                "brand": a.item(k).innerHTML,

                                "url": a.item(k).getAttribute("href")

                            })

                        }

                    }

                }

                return Array

            })

            console.log(cityList[i].cityName + "的所有二手车品牌爬取完毕")

            for (let j = 0; j < brandList.length; j++) {

                console.log("开始爬取" + cityList[i].cityName + "-" + brandList[j].brand + "的所有车系")

                await page.waitFor(1000 + Math.round(Math.random() * 100))

                await page.goto(rootUrl + brandList[j].url)

                try {

                    const carTypeList = await page.evaluate(() => {  //车型

                        let Array = []

                        const dl = document.querySelectorAll('.screen').item(0).getElementsByTagName("dl")

                        const div = dl.item(1).getElementsByTagName("dd").item(0).getElementsByTagName("div").item(1)

                        const li = div.getElementsByTagName("ul").item(0).getElementsByTagName("li")

                        for (let j = 0; j < li.length; j++) {

                            let a = li.item(j).getElementsByTagName("p").item(0).getElementsByTagName("a")

                            for (let k = 0; k < a.length; k++) {

                                Array.push({

                                    "carType": a.item(k).innerHTML.replace(/\s*/g, ""),

                                    "url": a.item(k).getAttribute("href")

                                })

                            }

                        }

                        return Array

                    })

                    console.log(cityList[i].cityName + "-" + brandList[j].brand + "的所有车系爬取完毕")

                    for (let k = 0; k < carTypeList.length; k++) {

                        await page.waitFor(1000 + Math.round(Math.random() * 100))

                        console.log("开始爬取" + cityList[i].cityName + "-" + brandList[j].brand + "-" + carTypeList[k].carType + "的所有二手车")

                        let newUrl = rootUrl + carTypeList[k].url

                        pathArray = newUrl.split("/") //拿到第一页url,得到后面的页面的url

                        let urlArray = []

                        try {

                            await page.goto(newUrl)

                            const pageNum = await page.evaluate(() => {   //获取总页数

                                let li = document.querySelectorAll("ul.pageLink").item(0).getElementsByTagName("li")

                                let liNum = li.length

                                return li.item(li.length - 2).getElementsByTagName("a").item(0).getElementsByTagName("span").item(0).innerHTML

                            })

                            for (let i = 1; i <= pageNum; i++) { //将所有的页面存入数组中

                                urlArray.push(newUrl.replace(new RegExp("/" + pathArray[pathArray.length - 1], 'g'), "/o" + i + "/" + pathArray[pathArray.length - 1]))

                            }

                        } catch (error) {

                            console.log(cityList[i].cityName + "-" + brandList[j].brand + "-" + carTypeList[k].carType + "的所有二手车列表爬取失败,该车型可能只有少量或者没有")

                        }

                        if (urlArray.length != 0) {

                            for (let i = 0; i < urlArray.length; i++) {

                                await page.goto(urlArray[i]);

                                const list = await page.evaluate(() => {

                                    let carArray = []

                                    let li = document.querySelectorAll("ul.carlist").item(0).getElementsByTagName("li")

                                    for (let i = 0; i < li.length; i++) {

                                        a = li.item(i).getElementsByTagName("a").item(0)

                                        carArray.push({

                                            "url": a.getAttribute("href"),

                                            "imgUrl": a.getElementsByTagName("img").item(0).getAttribute("src"),

                                            "carName": a.getElementsByTagName("h2").item(0).innerHTML,

                                            "carData": (a.getElementsByTagName("div").item(0).innerHTML).replace(new RegExp('<span class="icon-pad">', 'g'), "").replace(new RegExp('</span>', 'g'), ""),

                                            "price": a.getElementsByTagName("div").item(1).getElementsByTagName("p").item(0).innerHTML.replace(new RegExp('<span>', 'g'), "").replace(new RegExp('</span>', 'g'), "").replace(/\s*/g, "")

                                        })

                                    }

                                    return carArray

                                })

                                await page.waitFor(500 + Math.round(Math.random() * 100))

                                console.log(list)

                            }

                        }else{

                            try {

                                const list = await page.evaluate(() => {

                                    let carArray = []

                                    let li = document.querySelectorAll("ul.carlist").item(0).getElementsByTagName("li")

                                    console.log("该车型少量")

                                    for (let i = 0; i < li.length; i++) {

                                        a = li.item(i).getElementsByTagName("a").item(0)

                                        carArray.push({

                                            "url": a.getAttribute("href"),

                                            "imgUrl": a.getElementsByTagName("img").item(0).getAttribute("src"),

                                            "carName": a.getElementsByTagName("h2").item(0).innerHTML,

                                            "carData": (a.getElementsByTagName("div").item(0).innerHTML).replace(new RegExp('<span class="icon-pad">', 'g'), "").replace(new RegExp('</span>', 'g'), ""),

                                            "price": a.getElementsByTagName("div").item(1).getElementsByTagName("p").item(0).innerHTML.replace(new RegExp('<span>', 'g'), "").replace(new RegExp('</span>', 'g'), "").replace(/\s*/g, "")

                                        })

                                    }

                                    return carArray

                                })

                                await page.waitFor(500 + Math.round(Math.random() * 100))

                                console.log(list)

                            } catch (error) {

                                console.log("该车型没有")

                            }

                        }

                    }

                } catch (error) {

                    console.log(cityList[i].cityName + "-" + brandList[i].brand + "的所有车系爬取失败")

                }

            }

        } catch (error) {

            console.log(cityList[i].cityName + "二手车品牌爬取失败")

        }

        await page.waitFor(1000 + Math.round(Math.random() * 100))

    }

})();
时间比较赶,先附上代码和运行截图
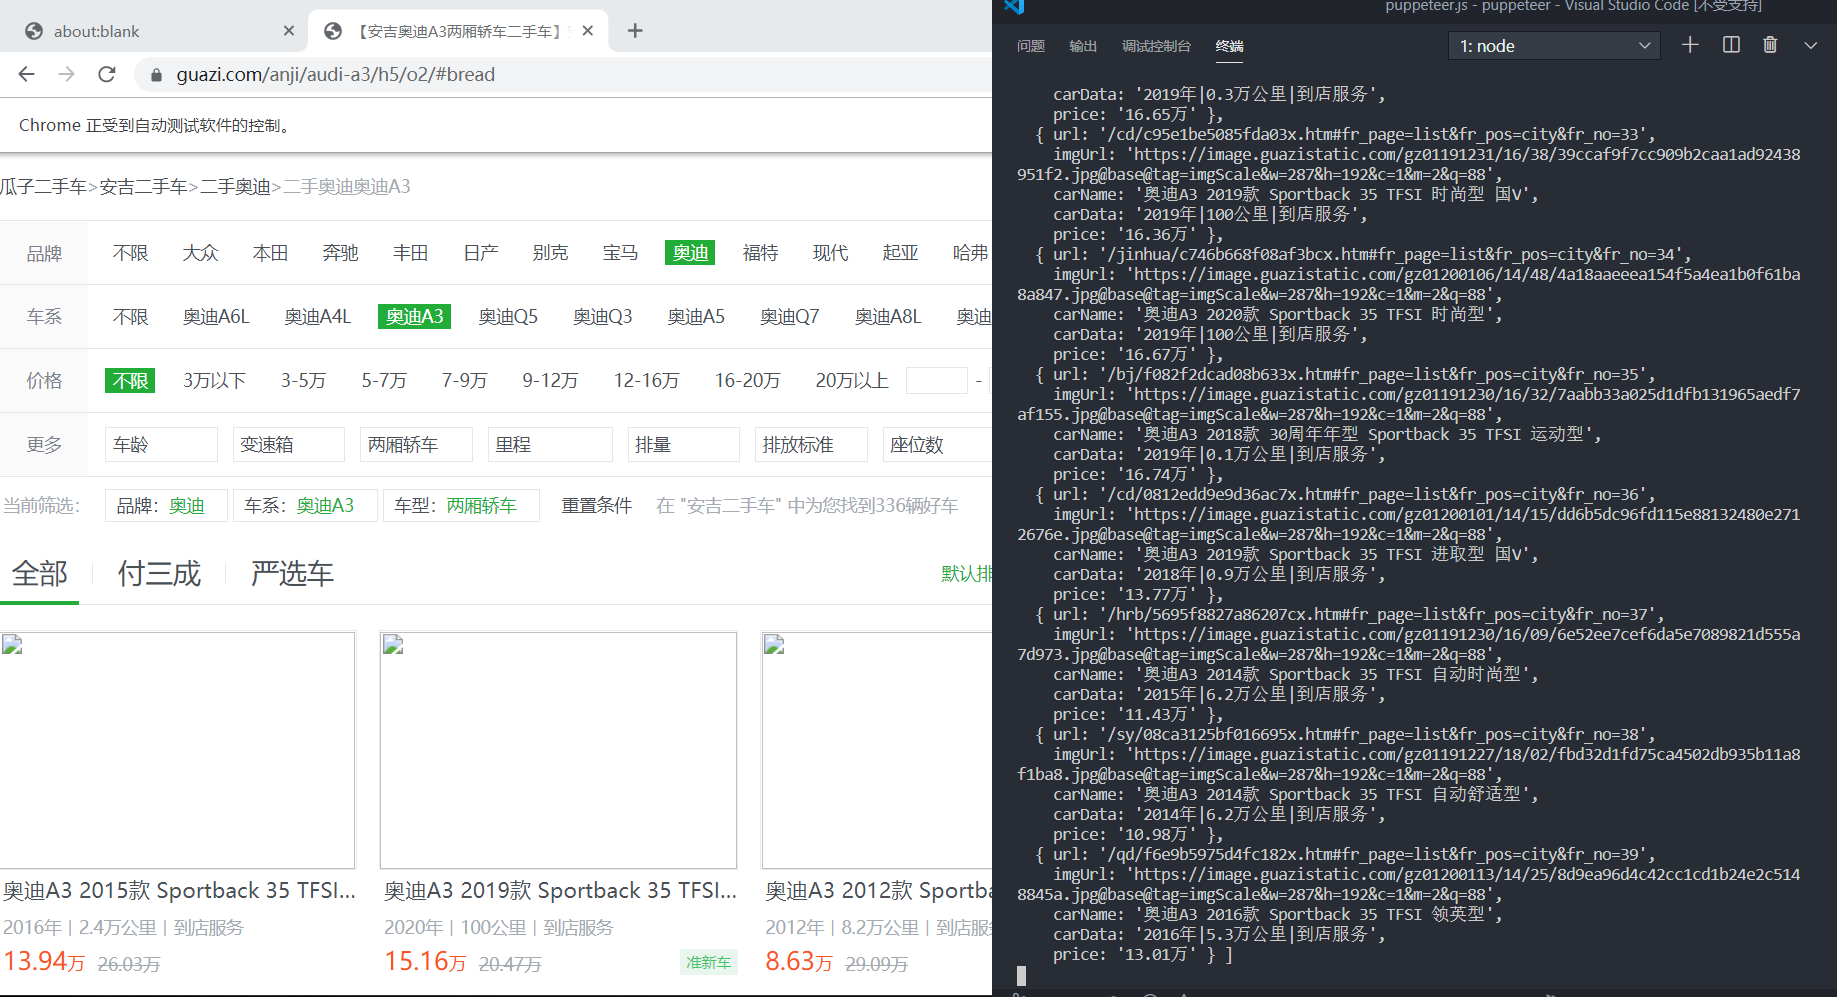
有兴趣的可以 看一下项目地址
https://gitee.com/xu_hui_hong/nodejs_puppeteer_guazi2
使用nodejs的puppeteer库爬取瓜子二手车网站的更多相关文章
- Python——爬取瓜子二手车
# coding:utf8 # author:Jery # datetime:2019/5/1 5:16 # software:PyCharm # function:爬取瓜子二手车 import re ...
- python爬虫学习之使用BeautifulSoup库爬取开奖网站信息-模块化
实例需求:运用python语言爬取http://kaijiang.zhcw.com/zhcw/html/ssq/list_1.html这个开奖网站所有的信息,并且保存为txt文件和excel文件. 实 ...
- Python scrapy框架爬取瓜子二手车信息数据
项目实施依赖: python,scrapy ,fiddler scrapy安装依赖的包: 可以到https://www.lfd.uci.edu/~gohlke/pythonlibs/ 下载 pywi ...
- nodejs中使用cheerio爬取并解析html网页
nodejs中使用cheerio爬取并解析html网页 转 https://www.jianshu.com/p/8e4a83e7c376 cheerio用于node环境,用法与语法都类似于jquery ...
- 一起学爬虫——使用xpath库爬取猫眼电影国内票房榜
之前分享了一篇使用requests库爬取豆瓣电影250的文章,今天继续分享使用xpath爬取猫眼电影热播口碑榜 XPATH语法 XPATH(XML Path Language)是一门用于从XML文件中 ...
- python爬虫学习(三):使用re库爬取"淘宝商品",并把结果写进txt文件
第二个例子是使用requests库+re库爬取淘宝搜索商品页面的商品信息 (1)分析网页源码 打开淘宝,输入关键字“python”,然后搜索,显示如下搜索结果 从url连接中可以得到搜索商品的关键字是 ...
- Python 爬取所有51VOA网站的Learn a words文本及mp3音频
Python 爬取所有51VOA网站的Learn a words文本及mp3音频 #!/usr/bin/env python # -*- coding: utf-8 -*- #Python 爬取所有5 ...
- scrapy爬取西刺网站ip
# scrapy爬取西刺网站ip # -*- coding: utf-8 -*- import scrapy from xici.items import XiciItem class Xicispi ...
- Python开发爬虫之BeautifulSoup解析网页篇:爬取安居客网站上北京二手房数据
目标:爬取安居客网站上前10页北京二手房的数据,包括二手房源的名称.价格.几室几厅.大小.建造年份.联系人.地址.标签等. 网址为:https://beijing.anjuke.com/sale/ B ...
随机推荐
- 王艳 201771010127《面向对象程序设计(java)》第十六周学习总结
一:理论部分 1.程序:是一段静态的代码,它是应用程序执行的蓝本. 2.进程:是程序的一次动态执行,它对应了从代码加载.执行至执行完毕的一个完整过程. 3.多线程:是进程执行过程中产生的多条执行线索. ...
- 王艳 201771010127《面向对象程序设计(java)》第二周学习总结
王艳 201771010127<面向对象程序设计(java)>第二周学习总结 第一部分:理论知识学习部分 3.1:基本概念. 1)标识符:标识符由字母.数字.美元符号以及下划线组成.且第 ...
- MySQL(6)— 事务
六.事务 ACID: 原子性.一致性.隔离性和持久性 原子性(atomicity) :一组事务,不能再细分了,其中的sql, 要么全部提交成功,要么全部失败回滚,不能只提交其中的一部分操作. 一致性( ...
- Multisim-74LS08\74LS02\74LS86逻辑功能仿真实验
一. 实验目的 了解TTL门电路的外观封装.引脚分布和使用方法. 掌握数字电路试验台.万用表和示波器的使用方法. 掌握TTL与门.或非门和异或门的逻辑功能. 认识门电路对信号的控制作用. 二.实验内容 ...
- 一、CentOS6.8安装MySQL5.6
一.官网下载rpm安装包 https://dev.mysql.com/downloads/ 版本选中如图中红色框 二.卸载旧mysql 1.检查是否安装有mysql rpm -qa | grep -i ...
- 将`VuePress`建立的博客部署到GitHub或Gitee上
将VuePress建立的博客部署到GitHub或Gitee上 在上一篇中,我们详细介绍了如何利用VuePress搭建起个人博客系统,但这只是在本地debug启动的,接下来,我们把它部署到Github网 ...
- Android_四大组件之Service
一.概述 Service是四大组件之一.它主要用于在后台执行耗时的逻辑,即使用户切换到其他应用甚至退出应用,它也能继续在后台运行. 下面主要介绍了service的两种形式启动和绑定 ,并通过简单例子说 ...
- [自动化-脚本]002.cocos2dx-lua lua代码windows加密批处理
在开发软件的时候,我们都会在项目上线时候对代码进行加密,用来防止被不法分子盗走牟利.不同的语言有不同的加密方式,比较出名的有加壳,代码混淆等.在Lua开发cocos2dx的时候,框架会有提供加密的脚本 ...
- Linux 比较常用的命令
#磁盘空间 df -h 显示已经挂载的分区列表 du -sh [file] 估算当前使用磁盘空间 du -sk * | sort -rn 以容量大小递减排序 文件搜索 find find [file_ ...
- jchdl - RTL Module
https://mp.weixin.qq.com/s/Sr4ffU4TPPoUJpdInwWd6w jchdl Module类在概念上对应Verilog的module,作为所有用户自定义模块的父 ...