
【Spark】SparkStreaming与flume进行整合
文章目录
注意事项
一、首先要保证安装了flume,flume相关安装文章可以看【Hadoop离线基础总结】日志采集框架Flume二、把flume的lib目录下自带的过时的scala-library-2.10.5.jar包替换成scala-library-2.11.8.jar
三、下载需要的jar包,下载地址献上:https://repo1.maven.org/maven2/org/apache/spark/spark-streaming-flume_2.11/2.2.0/spark-streaming-flume_2.11-2.2.0.jar
并把jar包也放到flume的lib目录下
SparkStreaming从flume中poll数据
步骤
一、开发flume配置文件
在安装了flume的虚拟机执行以下操作命令
mkdir -p /export/servers/flume/flume-poll		//受监控的文件夹

cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin/conf

vim flume-poll.conf
# 命名flume的各个组件

a1.sources = r1

a1.sinks = k1

a1.channels = c1

# 配置source组件

a1.sources.r1.channels = c1

a1.sources.r1.type = spooldir

a1.sources.r1.spoolDir = /export/servers/flume/flume-poll

a1.sources.r1.fileHeader = true

# 配置channel组件 选用memory channel

a1.channels.c1.type =memory

a1.channels.c1.capacity = 20000

a1.channels.c1.transactionCapacity=5000

# 配置sink组件

a1.sinks.k1.channel = c1

a1.sinks.k1.type = org.apache.spark.streaming.flume.sink.SparkSink

a1.sinks.k1.hostname=node03

a1.sinks.k1.port = 8888

a1.sinks.k1.batchSize= 2000
二、启动flume
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin/

bin/flume-ng agent -c conf -f conf/flume-poll.conf -n a1 -Dflume.root.logger=DEBUG,CONSOLE
三、开发sparkStreaming代码
1.创建maven工程,导入jar包
<properties>

    <scala.version>2.11.8</scala.version>

    <spark.version>2.2.0</spark.version>

</properties>

<dependencies>

    <dependency>

        <groupId>org.apache.spark</groupId>

        <artifactId>spark-streaming-flume_2.11</artifactId>

        <version>2.2.0</version>

    </dependency>

    <dependency>

        <groupId>org.scala-lang</groupId>

        <artifactId>scala-library</artifactId>

        <version>${scala.version}</version>

    </dependency>

    <dependency>

        <groupId>org.apache.spark</groupId>

        <artifactId>spark-core_2.11</artifactId>

        <version>${spark.version}</version>

    </dependency>

    <dependency>

        <groupId>org.apache.spark</groupId>

        <artifactId>spark-sql_2.11</artifactId>

        <version>${spark.version}</version>

    </dependency>

    <!-- https://mvnrepository.com/artifact/org.apache.spark/spark-streaming -->

    <dependency>

        <groupId>org.apache.spark</groupId>

        <artifactId>spark-streaming_2.11</artifactId>

        <version>2.2.0</version>

    </dependency>

    <dependency>

        <groupId>org.apache.hadoop</groupId>

        <artifactId>hadoop-client</artifactId>

        <version>2.7.5</version>

    </dependency>

    <dependency>

        <groupId>org.apache.spark</groupId>

        <artifactId>spark-hive_2.11</artifactId>

        <version>2.2.0</version>

    </dependency>

    <dependency>

        <groupId>mysql</groupId>

        <artifactId>mysql-connector-java</artifactId>

        <version>5.1.38</version>

    </dependency>

</dependencies>

<build>

    <sourceDirectory>src/main/scala</sourceDirectory>

    <testSourceDirectory>src/test/scala</testSourceDirectory>

    <plugins>

        <plugin>

            <groupId>org.apache.maven.plugins</groupId>

            <artifactId>maven-compiler-plugin</artifactId>

            <version>3.0</version>

            <configuration>

                <source>1.8</source>

                <target>1.8</target>

                <encoding>UTF-8</encoding>

                <!--    <verbal>true</verbal>-->

            </configuration>

        </plugin>

        <plugin>

            <groupId>net.alchim31.maven</groupId>

            <artifactId>scala-maven-plugin</artifactId>

            <version>3.2.0</version>

            <executions>

                <execution>

                    <goals>

                        <goal>compile</goal>

                        <goal>testCompile</goal>

                    </goals>

                    <configuration>

                        <args>

                            <arg>-dependencyfile</arg>

                            <arg>${project.build.directory}/.scala_dependencies</arg>

                        </args>

                    </configuration>

                </execution>

            </executions>

        </plugin>

        <plugin>

            <groupId>org.apache.maven.plugins</groupId>

            <artifactId>maven-shade-plugin</artifactId>

            <version>3.1.1</version>

            <executions>

                <execution>

                    <phase>package</phase>

                    <goals>

                        <goal>shade</goal>

                    </goals>

                    <configuration>

                        <filters>

                            <filter>

                                <artifact>*:*</artifact>

                                <excludes>

                                    <exclude>META-INF/*.SF</exclude>

                                    <exclude>META-INF/*.DSA</exclude>

                                    <exclude>META-INF/*.RSA</exclude>

                                </excludes>

                            </filter>

                        </filters>

                        <transformers>

                            <transformer implementation="org.apache.maven.plugins.shade.resource.ManifestResourceTransformer">

                                <mainClass></mainClass>

                            </transformer>

                        </transformers>

                    </configuration>

                </execution>

            </executions>

        </plugin>

    </plugins>

</build>
2.开发代码
import org.apache.spark.streaming.dstream.{DStream, ReceiverInputDStream}

import org.apache.spark.streaming.flume.{FlumeUtils, SparkFlumeEvent}

import org.apache.spark.streaming.{Seconds, StreamingContext}

import org.apache.spark.{SparkConf, SparkContext}

object SparkFlumePoll {

  // 定义updateFunc函数

  def updateFunc(newValues: Seq[Int],runningCount: Option[Int]): Option[Int] = {

    Option(newValues.sum + runningCount.getOrElse(0))

  }

  def main(args: Array[String]): Unit = {

    // 获取SparkConf

    val sparkConf: SparkConf = new SparkConf().set("spark.driver.host", "localhost").setAppName("SparkFlume-Poll").setMaster("local[6]")

    // 获取SparkContext

    val sparkContext = new SparkContext(sparkConf)

    // 设置日志级别

    sparkContext.setLogLevel("WARN")

    //获取StreamingContext

    val streamingContext = new StreamingContext(sparkContext, Seconds(5))

    streamingContext.checkpoint("./poll-Flume")

    // 通过FlumeUtils调用createPollingStream方法获取flume中的数据

    /*

    createPollingStream所需参数:

      ssc: StreamingContext,

      hostname: String,

      port: Int,

     */

    val stream: ReceiverInputDStream[SparkFlumeEvent] = FlumeUtils.createPollingStream(streamingContext, "node03", 8888)

    // 拿到数据后,所有的数据都会封装在SparkFlumeEvent中

    // 将SparkFlumeEvent封装的数据转换为DStream

    val line: DStream[String] = stream.map(x => {

      // x代表SparkFlumeEvent封装对象,里面封装了event数据,通过以下方法转换成数组

      val array: Array[Byte] = x.event.getBody.array()

      // 将拿到的数组转换为String

      val str = new String(array)

      str

    }

    )

    // 进行单词计数操作

    val value: DStream[(String, Int)] = line.flatMap(_.split(" ")).map((_, 1)).updateStateByKey(updateFunc)

    //输出结果

    value.print()

    streamingContext.start()

    streamingContext.awaitTermination()

  }

}
四、向监控目录中导入文本文件
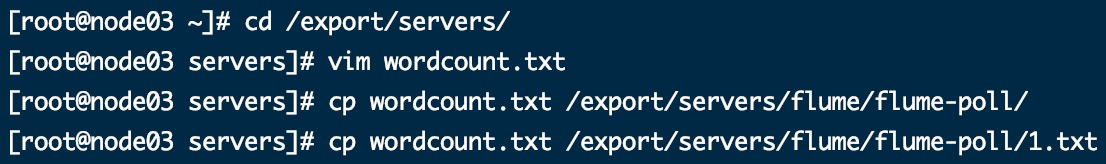
控制台结果

-------------------------------------------

Time: 1586877095000 ms

-------------------------------------------

-------------------------------------------

Time: 1586877100000 ms

-------------------------------------------

20/04/14 23:11:44 WARN RandomBlockReplicationPolicy: Expecting 1 replicas with only 0 peer/s.

20/04/14 23:11:44 WARN BlockManager: Block input-0-1586877094060 replicated to only 0 peer(s) instead of 1 peers

-------------------------------------------

Time: 1586877105000 ms

-------------------------------------------

(world,1)

(hive,2)

(hello,2)

(sqoop,1)

(test,1)

(abb,1)

-------------------------------------------

Time: 1586877110000 ms

-------------------------------------------

(world,1)

(hive,2)

(hello,2)

(sqoop,1)

(test,1)

(abb,1)

-------------------------------------------

Time: 1586877115000 ms

-------------------------------------------

(world,1)

(hive,2)

(hello,2)

(sqoop,1)

(test,1)

(abb,1)

20/04/14 23:11:57 WARN RandomBlockReplicationPolicy: Expecting 1 replicas with only 0 peer/s.

20/04/14 23:11:57 WARN BlockManager: Block input-0-1586877094061 replicated to only 0 peer(s) instead of 1 peers

-------------------------------------------

Time: 1586877120000 ms

-------------------------------------------

(world,2)

(hive,4)

(hello,4)

(sqoop,2)

(test,2)

(abb,2)

-------------------------------------------

Time: 1586877125000 ms

-------------------------------------------

(world,2)

(hive,4)

(hello,4)

(sqoop,2)

(test,2)

(abb,2)
flume将数据push给SparkStreaming
步骤
一、开发flume配置文件
mkdir -p /export/servers/flume/flume-push/

cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin/conf

vim flume-push.conf
#push mode

a1.sources = r1

a1.sinks = k1

a1.channels = c1

#source

a1.sources.r1.channels = c1

a1.sources.r1.type = spooldir

a1.sources.r1.spoolDir = /export/servers/flume/flume-push

a1.sources.r1.fileHeader = true

#channel

a1.channels.c1.type =memory

a1.channels.c1.capacity = 20000

a1.channels.c1.transactionCapacity=5000

#sinks

a1.sinks.k1.channel = c1

a1.sinks.k1.type = avro

#注意这里的ip需要指定的是我们spark程序所运行的服务器的ip,也就是我们的localhost

a1.sinks.k1.hostname=192.168.0.105

a1.sinks.k1.port = 8888

a1.sinks.k1.batchSize= 2000
二、启动flume
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin/

bin/flume-ng agent -c conf -f conf/flume-push.conf -n a1 -Dflume.root.logger=DEBUG,CONSOLE
三、开发代码
package cn.itcast.sparkstreaming.demo4

import org.apache.spark.streaming.dstream.{DStream, ReceiverInputDStream}

import org.apache.spark.streaming.flume.{FlumeUtils, SparkFlumeEvent}

import org.apache.spark.streaming.{Seconds, StreamingContext}

import org.apache.spark.{SparkConf, SparkContext}

object SparkFlumePush {

  def main(args: Array[String]): Unit = {

    //获取SparkConf

    val sparkConf: SparkConf = new SparkConf().setAppName("SparkFlume-Push").setMaster("local[6]").set("spark.driver.host", "localhost")

    //获取SparkContext

    val sparkContext = new SparkContext(sparkConf)

    sparkContext.setLogLevel("WARN")

    //获取StreamingContext

    val streamingContext = new StreamingContext(sparkContext, Seconds(5))

    val stream: ReceiverInputDStream[SparkFlumeEvent] = FlumeUtils.createStream(streamingContext, "192.168.0.105", 8888)

    val value: DStream[String] = stream.map(x => {

      val array: Array[Byte] = x.event.getBody.array()

      val str = new String(array)

      str

    })

    value.print()

    streamingContext.start()

    streamingContext.awaitTermination()

  }

}
四、向监控目录中导入文本文件

控制台结果

-------------------------------------------

Time: 1586882385000 ms

-------------------------------------------

20/04/15 00:39:45 WARN RandomBlockReplicationPolicy: Expecting 1 replicas with only 0 peer/s.

20/04/15 00:39:45 WARN BlockManager: Block input-0-1586882384800 replicated to only 0 peer(s) instead of 1 peers

-------------------------------------------

Time: 1586882390000 ms

-------------------------------------------

hello world

sqoop hive

abb test

hello hive

-------------------------------------------

Time: 1586882395000 ms

-------------------------------------------
【Spark】SparkStreaming与flume进行整合的更多相关文章
- 【Spark】SparkStreaming和Kafka的整合
文章目录 Streaming和Kafka整合 概述 使用0.8版本下Receiver DStream接收数据进行消费 步骤 一.启动Kafka集群 二.创建maven工程,导入jar包 三.创建一个k ...
- Spark Streaming从Flume Poll数据案例实战和内幕源码解密
本节课分成二部分讲解: 一.Spark Streaming on Polling from Flume实战 二.Spark Streaming on Polling from Flume源码 第一部分 ...
- 图解SparkStreaming与Kafka的整合,这些细节大家要注意!
前言 老刘是一名即将找工作的研二学生,写博客一方面是复习总结大数据开发的知识点,一方面是希望帮助更多自学的小伙伴.由于老刘是自学大数据开发,肯定会存在一些不足,还希望大家能够批评指正,让我们一起进步! ...
- Spark Streaming处理Flume数据练习
把Flume Source(netcat类型),从终端上不断给Flume Source发送消息,Flume把消息汇集到Sink(avro类型),由Sink把消息推送给Spark Streaming并处 ...
- cdh环境下,spark streaming与flume的集成问题总结
文章发自:http://www.cnblogs.com/hark0623/p/4170156.html 转发请注明 如何做集成,其实特别简单,网上其实就是教程. http://blog.csdn.n ...
- spark streaming集成flume
1. 安装flume flume安装,解压后修改flume_env.sh配置文件,指定java_home即可. cp hdfs jar包到flume lib目录下(否则无法抽取数据到hdfs上): $ ...
- Flume+Kafka整合
脚本生产数据---->flume采集数据----->kafka消费数据------->storm集群处理数据 日志文件使用log4j生成,滚动生成! 当前正在写入的文件在满足一定的数 ...
- demo2 Kafka+Spark Streaming+Redis实时计算整合实践 foreachRDD输出到redis
基于Spark通用计算平台,可以很好地扩展各种计算类型的应用,尤其是Spark提供了内建的计算库支持,像Spark Streaming.Spark SQL.MLlib.GraphX,这些内建库都提供了 ...
- hadoop 之 kafka 安装与 flume -> kafka 整合
62-kafka 安装 : flume 整合 kafka 一.kafka 安装 1.下载 http://kafka.apache.org/downloads.html 2. 解压 tar -zxvf ...
随机推荐
- 【论文研读】强化学习入门之DQN
最近在学习斯坦福2017年秋季学期的<强化学习>课程,感兴趣的同学可以follow一下,Sergey大神的,有英文字幕,语速有点快,适合有一些基础的入门生. 今天主要总结上午看的有关DQN ...
- Cucumber(1) —— 环境配置
目录 学习资料 cucumber简介 cucumber环境配置 学习资料 1.cucumber官方学习网站 cucumber简介 1.cucumber是一种支持BBD(behavior-driven ...
- 小知识点:session的存放位置
在php.ini里的配置session.save_path是注释掉的,那么Seesion保存的路径在不同类型操作系统保存在什么位置? Linux: /tmp 或 /var/lib/php/sessio ...
- async 和 await 例子
/// <summary> /// C# 5.0 /// .net framework4.5 /// CLR4.0 /// 引入了async 和 await.这两个关键字可以让你更方便的写 ...
- 44道JavaScript送命题
很久以前看过一个老外写的帖子,JavaScript Puzzlers!,直译就是JavaScript难题,里面列举了100道JavaScript选择题,大部分都是让人摸不着头脑的题目,需要仔细琢磨一番 ...
- python数据结构之栈的构建
class Stack(object): def __init__(self): self.stack=[] def pop(self): return self.stack.pop() def pu ...
- Kettle7.1创建资源库,资源库颜色灰色,没有Connect按钮解决办法
我们在官网下载的Ketlle7.1工具,在本地运行时会发现标题中提到的问题:工具-资源库里面的按钮都是灰色的,无法点击.查找Connect整个页面找了个遍,也没有找到. 于是乎开始百度.谷歌的搜索啊. ...
- Python之小型信息管理系统
#Author:msq #Time:2019/11/16 import re import os filename = "person.txt" def menu(): #输出菜单 ...
- php phpStudy session存放位置
如果你仅仅是想知道session保存的文件在哪里,你可以在你的PHP文件当中运行函数:session_save_path之后查看运行结果即可知道session文件的存放目录. 或者: 在php-ini ...
- failed to open stream :HTTP request failed 解决方法
用curl抓取,不要用file_get_contents(); 前者比后者效率高一点