
Hadoop 系列(五)—— Hadoop 集群环境搭建
一、集群规划
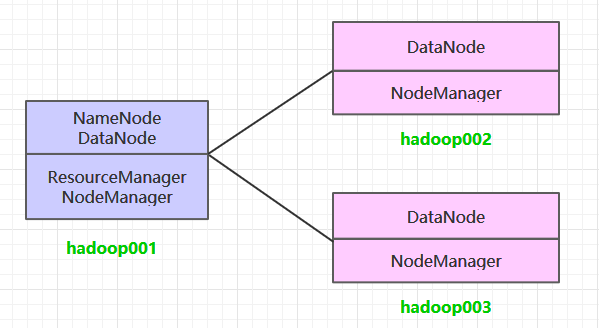
这里搭建一个 3 节点的 Hadoop 集群,其中三台主机均部署 DataNode 和 NodeManager 服务,但只有 hadoop001 上部署 NameNode 和 ResourceManager 服务。
二、前置条件
Hadoop 的运行依赖 JDK,需要预先安装。其安装步骤单独整理至:
三、配置免密登录
3.1 生成密匙
在每台主机上使用 ssh-keygen 命令生成公钥私钥对:
ssh-keygen3.2 免密登录
将 hadoop001 的公钥写到本机和远程机器的 ~/ .ssh/authorized_key 文件中:
ssh-copy-id -i ~/.ssh/id_rsa.pub hadoop001
ssh-copy-id -i ~/.ssh/id_rsa.pub hadoop002
ssh-copy-id -i ~/.ssh/id_rsa.pub hadoop003
3.3 验证免密登录
ssh hadoop002
ssh hadoop003
四、集群搭建
3.1 下载并解压
下载 Hadoop。这里我下载的是 CDH 版本 Hadoop,下载地址为:http://archive.cloudera.com/cdh5/cdh/5/
# tar -zvxf hadoop-2.6.0-cdh5.15.2.tar.gz 3.2 配置环境变量
编辑 profile 文件:
# vim /etc/profile增加如下配置:
export HADOOP_HOME=/usr/app/hadoop-2.6.0-cdh5.15.2
export  PATH=${HADOOP_HOME}/bin:$PATH
执行 source 命令,使得配置立即生效:
# source /etc/profile3.3 修改配置
进入 ${HADOOP_HOME}/etc/hadoop 目录下,修改配置文件。各个配置文件内容如下:
1. hadoop-env.sh
# 指定JDK的安装位置
export JAVA_HOME=/usr/java/jdk1.8.0_201/
2. core-site.xml
<configuration>
    <property>
        <!--指定 namenode 的 hdfs 协议文件系统的通信地址-->
        <name>fs.defaultFS</name>
        <value>hdfs://hadoop001:8020</value>
    </property>
    <property>
        <!--指定 hadoop 集群存储临时文件的目录-->
        <name>hadoop.tmp.dir</name>
        <value>/home/hadoop/tmp</value>
    </property>
</configuration>
3. hdfs-site.xml
<property>
      <!--namenode 节点数据(即元数据)的存放位置,可以指定多个目录实现容错,多个目录用逗号分隔-->
    <name>dfs.namenode.name.dir</name>
    <value>/home/hadoop/namenode/data</value>
</property>
<property>
      <!--datanode 节点数据(即数据块)的存放位置-->
    <name>dfs.datanode.data.dir</name>
    <value>/home/hadoop/datanode/data</value>
</property>
4. yarn-site.xml
<configuration>
    <property>
        <!--配置 NodeManager 上运行的附属服务。需要配置成 mapreduce_shuffle 后才可以在 Yarn 上运行 MapReduce 程序。-->
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>
    <property>
        <!--resourcemanager 的主机名-->
        <name>yarn.resourcemanager.hostname</name>
        <value>hadoop001</value>
    </property>
</configuration>
5. mapred-site.xml
<configuration>
    <property>
        <!--指定 mapreduce 作业运行在 yarn 上-->
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
</configuration>
5. slaves
配置所有从属节点的主机名或 IP 地址,每行一个。所有从属节点上的 DataNode 服务和 NodeManager 服务都会被启动。
hadoop001
hadoop002
hadoop003
3.4 分发程序
将 Hadoop 安装包分发到其他两台服务器,分发后建议在这两台服务器上也配置一下 Hadoop 的环境变量。
# 将安装包分发到hadoop002
scp -r /usr/app/hadoop-2.6.0-cdh5.15.2/  hadoop002:/usr/app/
# 将安装包分发到hadoop003
scp -r /usr/app/hadoop-2.6.0-cdh5.15.2/  hadoop003:/usr/app/
3.5 初始化
在 Hadoop001 上执行 namenode 初始化命令:
hdfs namenode -format3.6 启动集群
进入到 Hadoop001 的 ${HADOOP_HOME}/sbin 目录下,启动 Hadoop。此时 hadoop002 和 hadoop003 上的相关服务也会被启动:
# 启动dfs服务
start-dfs.sh
# 启动yarn服务
start-yarn.sh
3.7 查看集群
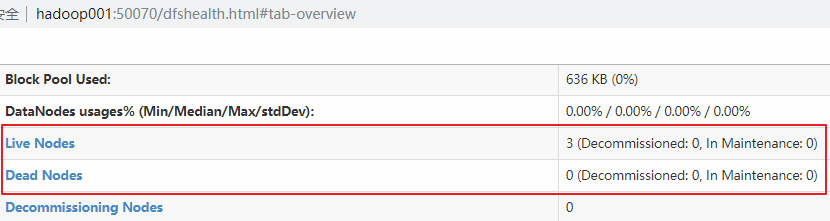
在每台服务器上使用 jps 命令查看服务进程,或直接进入 Web-UI 界面进行查看,端口为 50070。可以看到此时有三个可用的 Datanode:
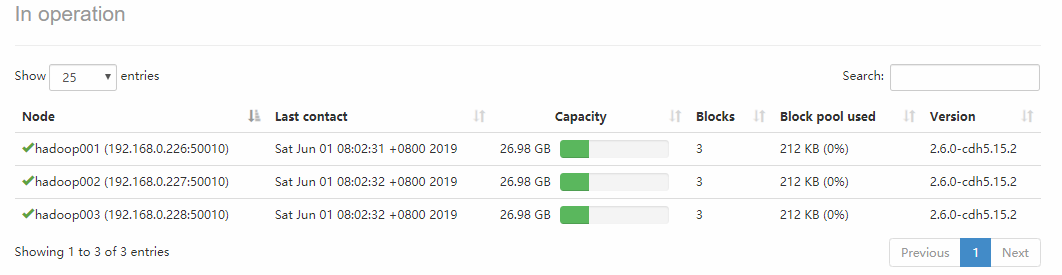
点击 Live Nodes 进入,可以看到每个 DataNode 的详细情况:
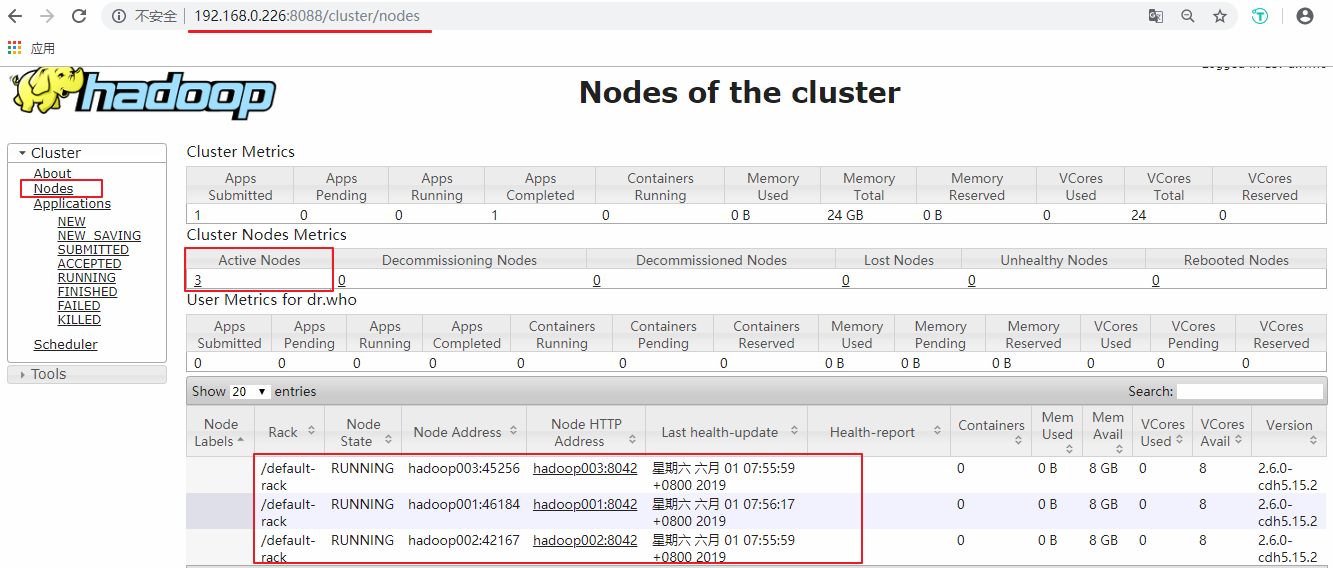
接着可以查看 Yarn 的情况,端口号为 8088 :
五、提交服务到集群
提交作业到集群的方式和单机环境完全一致,这里以提交 Hadoop 内置的计算 Pi 的示例程序为例,在任何一个节点上执行都可以,命令如下:
hadoop jar /usr/app/hadoop-2.6.0-cdh5.15.2/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.6.0-cdh5.15.2.jar pi 3 3更多大数据系列文章可以参见 GitHub 开源项目: 大数据入门指南
Hadoop 系列(五)—— Hadoop 集群环境搭建的更多相关文章
- Hadoop+HBase+ZooKeeper分布式集群环境搭建
一.环境说明 集群环境至少需要3个节点(也就是3台服务器设备):1个Master,2个Slave,节点之间局域网连接,可以相互ping通,下面举例说明,配置节点IP分配如下: Hostname IP ...
- 大数据hadoop入门学习之集群环境搭建集合
目录: 1.基本工作准备 1.虚拟机准备 2.java 虚拟机-jdk环境配置 3.ssh无密码登录 2.hadoop的安装与配置 3.hbase安装与配置(集成安装zookeeper) 4.zook ...
- 大数据 -- Hadoop集群环境搭建
首先我们来认识一下HDFS, HDFS(Hadoop Distributed File System )Hadoop分布式文件系统.它其实是将一个大文件分成若干块保存在不同服务器的多个节点中.通过联网 ...
- Hadoop+Spark:集群环境搭建
环境准备: 在虚拟机下,大家三台Linux ubuntu 14.04 server x64 系统(下载地址:http://releases.ubuntu.com/14.04.2/ubuntu-14.0 ...
- hadoop集群环境搭建之zookeeper集群的安装部署
关于hadoop集群搭建有一些准备工作要做,具体请参照hadoop集群环境搭建准备工作 (我成功的按照这个步骤部署成功了,经实际验证,该方法可行) 一.安装zookeeper 1 将zookeeper ...
- hadoop集群环境搭建之安装配置hadoop集群
在安装hadoop集群之前,需要先进行zookeeper的安装,请参照hadoop集群环境搭建之zookeeper集群的安装部署 1 将hadoop安装包解压到 /itcast/ (如果没有这个目录 ...
- hadoop集群环境搭建准备工作
一定要注意hadoop和linux系统的位数一定要相同,就是说如果hadoop是32位的,linux系统也一定要安装32位的. 准备工作: 1 首先在VMware中建立6台虚拟机(配置默认即可).这是 ...
- Hadoop集群环境搭建步骤说明
Hadoop集群环境搭建是很多学习hadoop学习者或者是使用者都必然要面对的一个问题,网上关于hadoop集群环境搭建的博文教程也蛮多的.对于玩hadoop的高手来说肯定没有什么问题,甚至可以说事“ ...
- Hadoop完全分布式集群环境搭建
1. 在Apache官网下载Hadoop 下载地址:http://hadoop.apache.org/releases.html 选择对应版本的二进制文件进行下载 2.解压配置 以hadoop-2.6 ...
- Spark集群环境搭建——Hadoop集群环境搭建
Spark其实是Hadoop生态圈的一部分,需要用到Hadoop的HDFS.YARN等组件. 为了方便我们的使用,Spark官方已经为我们将Hadoop与scala组件集成到spark里的安装包,解压 ...
随机推荐
- GoCN每日新闻(2019-10-16)
GoCN每日新闻(2019-10-16) GoCN每日新闻(2019-10-16) 1. 持续的性能分析与优化 https://medium.com/@tvii/continuous-profilin ...
- Server concepts 详解
server status 是由 vm_state和task_state 计算出来的,vm_state是虚机当前的稳定状态(例如Active, Error),task_state是虚机当前的瞬间状态( ...
- php 把数字转化为大写中文—升级版
继上篇之后,发现某同事悄悄改了新版本,于是被我偷偷保存起来了,功能一样,不过他的比较短小,emmm.放了快一年了,悄悄放到博客里面. 功能需求在另一篇博客里 <?php function cny ...
- 实验与作业(Python)-02 Python函数入门与温度转换程序(函数、input、eval、int、float、列表)
截止日期 实验目标 学会定义函数,使用函数.学会导入在某个文件中定义的函数. input获得值,然后通过eval或者int.float将其转换为相应的类型. 学会使用列表:访问列表.append.遍历 ...
- spring @Transactional 事务注解的坑
1. 在需要事务管理的地方加@Transactional 注解.@Transactional 注解可以被应用于接口定义和接口方法.类定义和类的 public 方法上. 2. @Transactiona ...
- activiti 术语 国际化文件
activiti-explorer editor-app 国际化文件 - 大强的博客 - CSDN博客https://blog.csdn.net/daqiang012/article/details/ ...
- Python3基础 tuple(list) 改变list元素的内容时,元组的id值不变
Python : 3.7.3 OS : Ubuntu 18.04.2 LTS IDE : pycharm-community-2019.1.3 ...
- pytorch visdom可视化工具学习—3-命令行操作使用经验
在使用过程中一直以为要在哪个指定的environment下(即参数env)绘制内容,就必须在使用时声明 比如如果不声明,默认的就是在'main'环境下,端口为8097: viz = visdom.Vi ...
- SQLite添加新的字段
通过alter添加新的字段SQL语句 "ALTER TABLE 'DiHKChatMessage' ADD 'phoneNum' varchar"; 但是如果这个字段已经存在的话, ...
- c#中Split 分离字符以及空格消除方法
1 split几种分离方法 1)用字符串分隔: using System.Text.RegularExpressions; string str="aaajsbbbjsccc& ...