
python爬虫4猫眼电影的Top100
1 查看网页结构
(1)确定需要抓取的字段
电影名称
电影主演
电影上映时间
电影评分
(2) 分析页面结构
按住f12------->点击右上角(如下图2)---->鼠标点击需要观察的字段
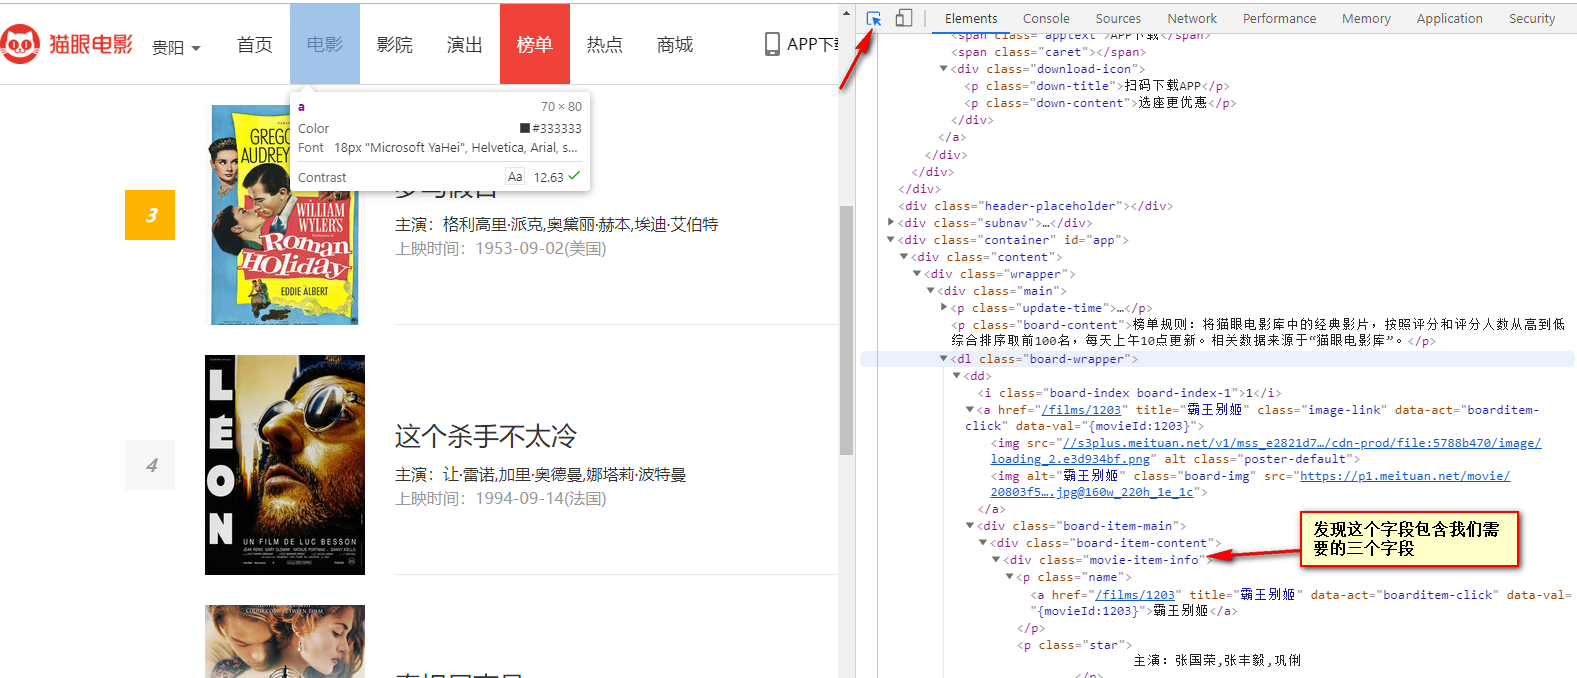
(3)BeautifulSoup解析源代码并设置过滤属性
 soup = BeautifulSoup(htmll, 'lxml')

 Movie_name = soup.find_all('div',class_='movie-item-info')

 Movie_Score1=soup.find_all('p',class_='score')
(4)调试查看过滤属性是否正确
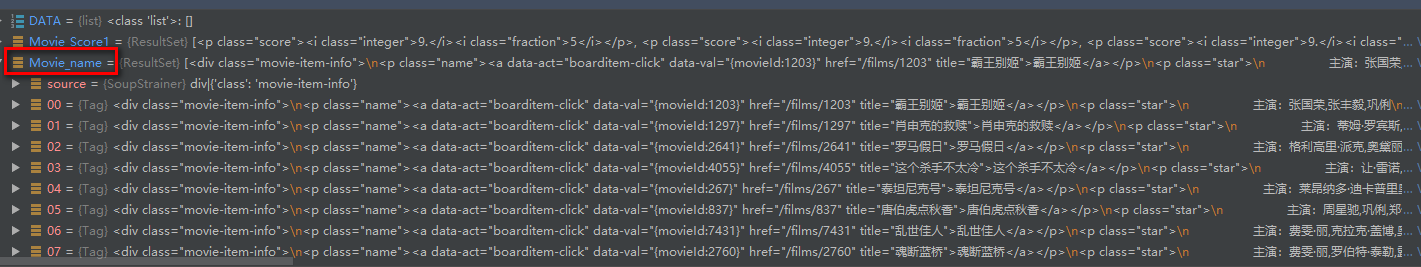
(5)提取对应字段
  for cate,score in zip(Movie_name,Movie_Score1):

         data={}

         movie_name1 = cate.find('a').text.strip('\n')

         data['title']=movie_name1

         movie_actor = cate.find_all("p")[1].text.replace("\n"," ").strip()

         data['actors']=movie_actor

         movie_time=cate.find_all("p")[2].text.strip('\n').strip()

         data['data']=movie_time

         movie_score1=score.find_all("i")[0].string

         movie_score2=score.find_all("i")[1].string

         movie_score=movie_score1+movie_score2

         data['score'] = movie_score

         name = movie_name1 + "\t"+movie_actor+"\t" + movie_time+"\t"+movie_score

         DATA.append(name)

         with open('Movie1.txt', 'a+') as f:

             f.write("\n{}".format(name))
(6)翻页爬取
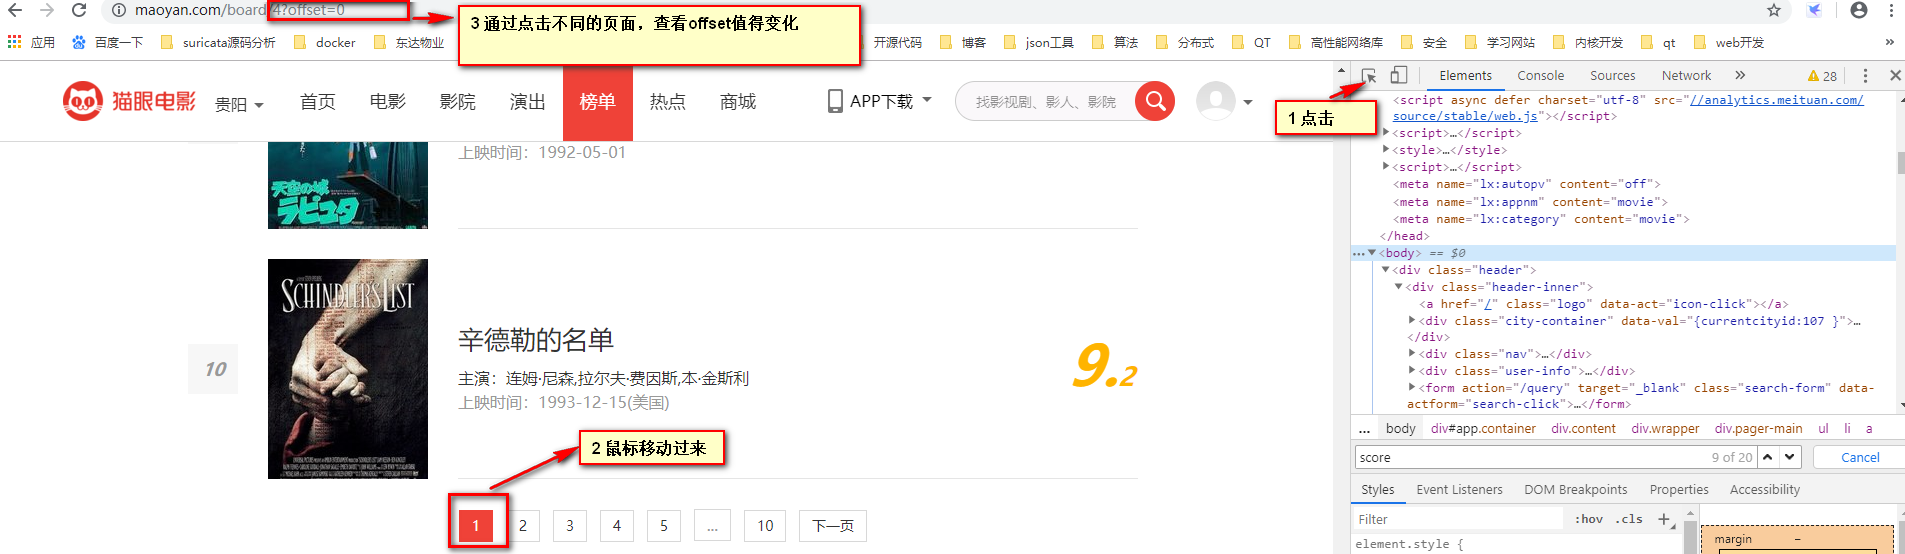
如下图,按照1 2 3步骤,发现页数是有这样子的规律。比如offset=0 offset=10......

2 存储excel
   for datas in DATA:

         datas=datas.split('\t')#因为我之前解析字段拼接的时候就是采用\t分割

         print(len(datas))

         print(datas)

         for j in range(len(datas)):#列表中的每一项都包含按照\t分割的字段

             print(j)

             sheet1.write(i, j, datas[j])

         i = i + 1

     f.save("d.xls")  # 保存文件
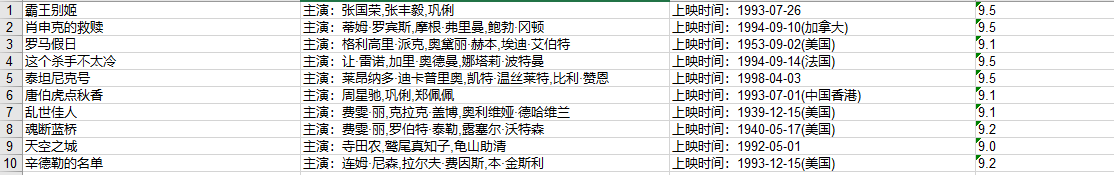
3 结果
python爬虫4猫眼电影的Top100的更多相关文章
- python爬取猫眼电影top100
最近想研究下python爬虫,于是就找了些练习项目试试手,熟悉一下,猫眼电影可能就是那种最简单的了. 1 看下猫眼电影的top100页面 分了10页,url为:https://maoyan.com/b ...
- 爬虫系列(1)-----python爬取猫眼电影top100榜
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天在整理代码时,整理了一下之前自己学习爬虫的一些代码,今天先上一个简单的例子,手把手教你入门Python爬虫,爬取 ...
- python 爬取猫眼电影top100数据
最近有爬虫相关的需求,所以上B站找了个视频(链接在文末)看了一下,做了一个小程序出来,大体上没有修改,只是在最后的存储上,由txt换成了excel. 简要需求:爬虫爬取 猫眼电影TOP100榜单 数据 ...
- Python正则表达式匹配猫眼电影HTML信息
爬虫项目爬取猫眼电影TOP100电影信息 项目内容来自:https://github.com/Germey/MaoYan/blob/master/spider.py 由于其中需要爬取的包含电影名字.电 ...
- Python 爬取猫眼电影最受期待榜
主要爬取猫眼电影最受期待榜的电影排名.图片链接.名称.主演.上映时间. 思路:1.定义一个获取网页源代码的函数: 2.定义一个解析网页源代码的函数: 3.定义一个将解析的数据保存为本地文件的函数: ...
- 【Python3爬虫】猫眼电影爬虫(破解字符集反爬)
一.页面分析 首先打开猫眼电影,然后点击一个正在热播的电影(比如:毒液).打开开发者工具,点击左上角的箭头,然后用鼠标点击网页上的票价,可以看到源码中显示的不是数字,而是某些根本看不懂的字符,这是因为 ...
- Python爬取猫眼电影100榜并保存到excel表格
首先我们前期要导入的第三方类库有; 通过猫眼电影100榜的源码可以看到很有规律 如: 亦或者是: 根据规律我们可以得到非贪婪的正则表达式 """<div class ...
- 用Python爬取猫眼上的top100评分电影
代码如下: # 注意encoding = 'utf-8'和ensure_ascii = False,不写的话不能输出汉字 import requests from requests.exception ...
- 爬虫_猫眼电影top100(正则表达式)
代码查看码云
随机推荐
- jQ native 构造函数
- danci
plain 英 [pleɪn] 美 [plen] adj. 平的:简单的:朴素的:清晰的 n. 平原:无格式:朴实无华的东西 adv. 清楚地:平易地 n. (Plain)人名:(英)普莱恩:(法)普 ...
- VMware共享本地文件
最后可以在这里找到
- oracle连接出现的坑
一.错误代码提示 请输入用户名: SYS 输入口令: ERROR: ORA-28009: connection as SYS should be as SYSDBA or SYSOPER 二.解决方 ...
- Dubbo源码分析:Server
Server接口是开启一个socket服务.服务实现有netty,mina,grizzly的. 抽象时序图 获取NettyServer时序图 Transporter类图 Server 类图
- [ARIA] Create an Accessible Tooltip on a Text Input
Here we use HTML and CSS to create a stylish yet semantic tooltip on a form input. I am using aria-d ...
- 持续集成学习11 jenkins和gitlab集成自动触发
一.配置gitlab上提交代码后在jenkins上自动构建 1.在jenkins上配置gitlab 系统管理--->系统设置--->gitlab配置 2.在gitlab上配置token 3 ...
- TODO list(咕咕咕。。。
1. Segment Tree Beats 2. ZR集训补题(还剩10题) 3. 尽可能将各种数据结构写得熟练...(某神仙:要把平衡树写得跟线段树一样熟练) 4. 树相关数据结构和算法(dsu o ...
- 开机启动类似于Tencent Upd的弹窗解决方法
1.开机启动的程序,后台启动自动升级的exe,每次开机都弹出弹窗,一不小心就点错了,神烦. 解决方式:直接在windows系统 [ 本地安全策略>软件限制策略>其他规则 ] 里面把弹出的 ...
- 【洛谷】P5024 保卫王国 (倍增)
前言 传送门 很多人写了题解了,我就懒得写了,推荐一篇博客 那就分享一下我的理解吧(说得好像有人看一样 对于每个点都只有选与不选两种情况,所以直接用倍增预处理出来两种情况的子树之内,子树之外的最值,最 ...