
Python+Requests+Re(正则)爬取某糗事百科图片(数据分析一)
1、博客目前在学习爬虫课程,使用正则表达式来爬取网页的图片信息
2、下面我们一起来回归下Python中的正则使用方式/方法
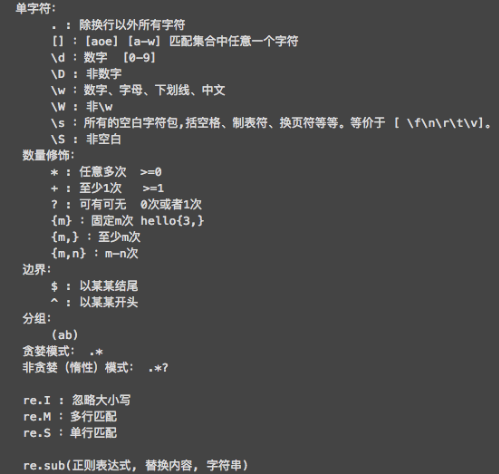
3、糗事百科图片爬取源码如下:
import requests
import re
import os

if __name__ == '__main__':
    # headers请求头信息
    headers = {
        'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/86.0.4240.111 Safari/537.36'
    }
    # 新建文件夹用来存储糗事图片
    if not os.path.exists('./qiushiLibs'):
        os.makedirs('./qiushiLibs')

    # Url进行封装循环分页爬取
    url = 'https://www.qiushibaike.com/imgrank/page/%d/'
    for page in range(1,2):
        new_url = format(url%page)
        # 调用get请求获取text字符串
        page_source = requests.get(url=new_url,headers=headers).text
        # 正则表达式:使用到非贪婪模式
        ER = r'<div class="thumb">.*?<img src="(.*?)" alt.*?</div>'
        # 返回list数组
        img_src_list = re.findall(ER,page_source,re.S)
        for src in img_src_list:
            # 遍历拼接图片URL
            src = 'https:'+src
            # 下载图片新建请求
            # 以二进制流的方式存储
            img_content = requests.get(url=src,headers=headers).content
            # print(img_content)
            # 生成图片的名称
            imgName = src.split('/')[-1]
            # 图片路径
            imgPath = './qiushiLibs/'+imgName
            # 持久化存储
            with open(imgPath,'wb') as fp:
                fp.write(img_content)
                print(imgName,'下载成功!!!')
Python+Requests+Re(正则)爬取某糗事百科图片(数据分析一)的更多相关文章
- 初识python 之 爬虫:爬取某网站的壁纸图片
用到的主要知识点:requests.get 获取网页HTMLetree.HTML 使用lxml解析器解析网页xpath 使用xpath获取网页标签信息.图片地址request.urlretrieve ...
- [Python]网络爬虫(八):糗事百科的网络爬虫(v0.2)源码及解析
转自:http://blog.csdn.net/pleasecallmewhy/article/details/8932310 项目内容: 用Python写的糗事百科的网络爬虫. 使用方法: 新建一个 ...
- python+正则+多进程爬取糗事百科图片
话不多说,直接上代码: # 需要的库 import requests import re import os from multiprocessing import Pool # 请求头 header ...
- python requests库网页爬取小实例:百度/360搜索关键词提交
百度/360搜索关键词提交全代码: #百度/360搜索关键词提交import requestskeyword='Python'try: #百度关键字 # kv={'wd':keyword} #360关 ...
- Python Requests库网络爬取全代码
#爬取京东商品全代码 import requestsurl = "http://item.jd.com/2967929.html"try: r = requests.get(url ...
- python requests库网页爬取小实例:亚马逊商品页面的爬取
由于直接通过requests.get()方法去爬取网页,它的头部信息的user-agent显示的是python-requests/2.21.0,所以亚马逊网站可能会拒绝访问.所以我们要更改访问的头部信 ...
- python Requests库网络爬取IP地址归属地的自动查询
#IP地址查询全代码import requestsurl = "http://m.ip138.com/ip.asp?ip="try: r = requests.get(url + ...
- python+BeautifulSoup+多进程爬取糗事百科图片
用到的库: import requests import os from bs4 import BeautifulSoup import time from multiprocessing impor ...
- 【Python】python3 正则爬取网页输出中文乱码解决
爬取网页时候print输出的时候有中文输出乱码 例如: \\xe4\\xb8\\xad\\xe5\\x8d\\x8e\\xe4\\xb9\\xa6\\xe5\\xb1\\x80 #爬取https:// ...
随机推荐
- MindSpore应用目标
MindSpore应用目标 以下将展示MindSpore近一年的高阶计划,会根据用户的反馈诉求,持续调整计划的优先级. 总体而言,会努力在以下几个方面不断改进. 1. 提供更多的预置模型支持. 2. ...
- 72 个网络应用安全实操要点,全方位保护 Web 应用的安全
原文地址:Web Application Security Checklist 原文作者:Teo Selenius(已授权) 译者 & 校正:HelloGitHub-小熊熊 & 卤蛋 ...
- ApplicationListener接口,在spring容器初始化后执行的方法
一.如果我们希望在Spring容器将所有的Bean都初始化完成之后,做一些操作,那么就可以使用ApplicationListener接口,实现ApplicationListener接口中的onAppl ...
- Java IO学习笔记四:Socket基础
作者:Grey 原文地址:Java IO学习笔记四:Socket基础 准备两个Linux实例(安装好jdk1.8),我准备的两个实例的ip地址分别为: io1实例:192.168.205.138 io ...
- CSS3-过渡、动画、2D与3D
过渡 过渡属性transition,可适用于大部分属性间变化的过渡,例如长度的.宽度和透明度等等. 语法: transition: property duration timing-function ...
- 【creo】CREO5.0+VS2019配置(还没写完)
欢迎大家一起学习使用c++对CREO5.0二次开发. 第1步,建立开发目录:在E盘(或者其他盘)新建creo_cpp文件夹,文件夹中新建ABC_TOOLS用来存放我们开发的工具,CODE文件夹存放开发 ...
- centos 7 能ping通但是telnet 22 不通解决方法
试过关闭Linux防火墙,打开sshd服务,修改ens33为enth0.发现不好使. 经过不断的努力我发现,windows系统里面的VMware Network Adapter VMnet8设置的ip ...
- 使用mockjs模拟分页请求
首先安装mockjs npm install mockjs --save-dev 创建mock.js //mock.js const Mock = require("mockjs" ...
- Java @SuppressWarnings:抑制编译器警告-4
Java 中的 @SuppressWarnings 注解指示被该注解修饰的程序元素(以及该程序元素中的所有子元素)取消显示指定的编译器警告,且会一直作用于该程序元素的所有子元素.例如,使用 @Supp ...
- 从ReentrantLock看AQS (AbstractQueuedSynchronizer) 运行流程
从ReentrantLock看AQS (AbstractQueuedSynchronizer) 运行流程 概述 本文将以ReentrantLock为例来讲解AbstractQueuedSynchron ...