
spark集群
https://blog.csdn.net/boling_cavalry/article/details/86747258
https://www.cnblogs.com/xuliangxing/p/7234014.html
第二个链接较为详细,但版本较旧

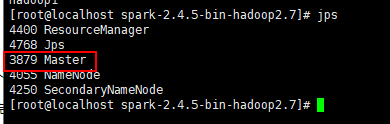
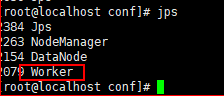
注意spark 7077端口URL,如果hostname没配置正确,spark-submit会报错
jps看了两个slaves是有worker进程的。
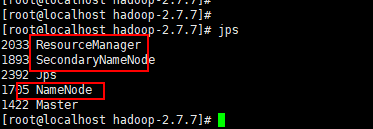
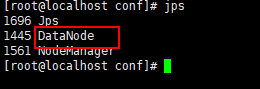
spark安装完毕,启动hadoop集群:./sbin/./start-all.sh
jps可查看
spark提交任务的三种的方法
https://www.cnblogs.com/itboys/p/9998666.html
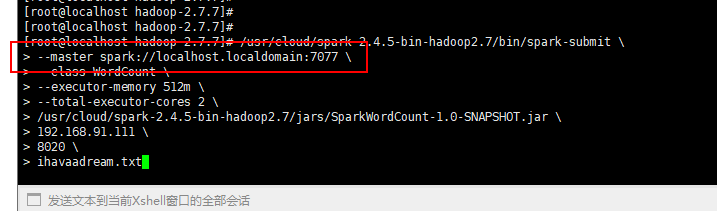

虚拟机分配内存不足,解决方案参考:https://blog.csdn.net/u012848709/article/details/85425249

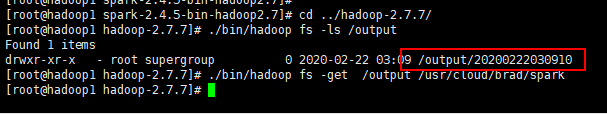
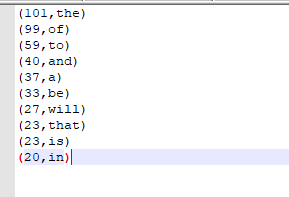
最后终于跑完了,把输出结果get下来
在master输入以下命令,最后三项为入参,9000为hadoop端口:
/usr/cloud/spark-2.4.5-bin-hadoop2.7/bin/spark-submit \
--master spark://192.168.91.111:7077 \
--class WordCount \
--executor-memory 512m \
--total-executor-cores 2 \
/usr/cloud/spark-2.4.5-bin-hadoop2.7/jars/SparkWordCount-1.0-SNAPSHOT.jar \
192.168.91.111 \
9000 \
ihavaadream.txt
=====================WordCount代码如下:======================
import org.apache.commons.lang3.StringUtils;
import org.apache.spark.SparkConf;
import org.apache.spark.api.java.JavaPairRDD;
import org.apache.spark.api.java.JavaRDD;
import org.apache.spark.api.java.JavaSparkContext;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import scala.Tuple2;

import java.text.SimpleDateFormat;
import java.util.Arrays;
import java.util.Date;
import java.util.List;

public class WordCount {

    private static final Logger logger = LoggerFactory.getLogger(WordCount.class);

    public static void main(String[] args) {
        if(null==args
                || args.length<3
                || StringUtils.isEmpty(args[0])
                || StringUtils.isEmpty(args[1])
                || StringUtils.isEmpty(args[2])) {
            logger.error("invalid params!");
        }

        String hdfsHost = args[0];
        String hdfsPort = args[1];
        String textFileName = args[2];

        SparkConf sparkConf = new SparkConf().setAppName("Spark WordCount Application (java)");

        JavaSparkContext javaSparkContext = new JavaSparkContext(sparkConf);

        String hdfsBasePath = "hdfs://" + hdfsHost + ":" + hdfsPort;
        //文本文件的hdfs路径
        String inputPath = hdfsBasePath + "/input/" + textFileName;

        //输出结果文件的hdfs路径
        String outputPath = hdfsBasePath + "/output/"
                + new SimpleDateFormat("yyyyMMddHHmmss").format(new Date());

        logger.info("input path : {}", inputPath);
        logger.info("output path : {}", outputPath);

        logger.info("import text");
        //导入文件
        JavaRDD<String> textFile = javaSparkContext.textFile(inputPath);

        logger.info("do map operation");
        JavaPairRDD<String, Integer> counts = textFile
                //每一行都分割成单词,返回后组成一个大集合
                .flatMap(s -> Arrays.asList(s.split(" ")).iterator())
                //key是单词,value是1
                .mapToPair(word -> new Tuple2<>(word, 1))
                //基于key进行reduce,逻辑是将value累加
                .reduceByKey((a, b) -> a + b);

        logger.info("do convert");
        //先将key和value倒过来,再按照key排序
        JavaPairRDD<Integer, String> sorts = counts
                //key和value颠倒,生成新的map
                .mapToPair(tuple2 -> new Tuple2<>(tuple2._2(), tuple2._1()))
                //按照key倒排序
                .sortByKey(false);

//        logger.info("take top 10");
        //取前10个
        List<Tuple2<Integer, String>> top10 = sorts.collect();
//        List<Tuple2<Integer, String>> top10 = sorts.take(10);

        StringBuilder sbud = new StringBuilder("top 10 word :\n");

        //打印出来
        for(Tuple2<Integer, String> tuple2 : top10){
            sbud.append(tuple2._2())
                    .append("\t")
                    .append(tuple2._1())
                    .append("\n");
        }

        logger.info(sbud.toString());

        logger.info("merge and save as file");
        //分区合并成一个,再导出为一个txt保存在hdfs
        javaSparkContext.parallelize(top10).coalesce(1).saveAsTextFile(outputPath);

        logger.info("close context");
        //关闭context
        javaSparkContext.close();
    }
}
done!
spark集群的更多相关文章
- (四)Spark集群搭建-Java&Python版Spark
Spark集群搭建 视频教程 1.优酷 2.YouTube 安装scala环境 下载地址http://www.scala-lang.org/download/ 上传scala-2.10.5.tgz到m ...
- [bigdata] spark集群安装及测试
在spark安装之前,应该已经安装了hadoop原生版或者cdh,因为spark基本要基于hdfs来进行计算. 1. 下载 spark: http://mirrors.cnnic.cn/apache ...
- Spark集群部署
Spark是通用的基于内存计算的大数据框架,可以和hadoop生态系统很好的兼容,以下来部署Spark集群 集群环境:3节点 Master:bigdata1 Slaves:bigdata2,bigda ...
- Spark集群 + Akka + Kafka + Scala 开发(3) : 开发一个Akka + Spark的应用
前言 在Spark集群 + Akka + Kafka + Scala 开发(1) : 配置开发环境中,我们已经部署好了一个Spark的开发环境. 在Spark集群 + Akka + Kafka + S ...
- Spark集群 + Akka + Kafka + Scala 开发(2) : 开发一个Spark应用
前言 在Spark集群 + Akka + Kafka + Scala 开发(1) : 配置开发环境,我们已经部署好了一个Spark的开发环境. 本文的目标是写一个Spark应用,并可以在集群中测试. ...
- Spark集群 + Akka + Kafka + Scala 开发(1) : 配置开发环境
目标 配置一个spark standalone集群 + akka + kafka + scala的开发环境. 创建一个基于spark的scala工程,并在spark standalone的集群环境中运 ...
- Hadoop+Spark:集群环境搭建
环境准备: 在虚拟机下,大家三台Linux ubuntu 14.04 server x64 系统(下载地址:http://releases.ubuntu.com/14.04.2/ubuntu-14.0 ...
- Spark 个人实战系列(1)--Spark 集群安装
前言: CDH4不带yarn和spark, 因此需要自己搭建spark集群. 这边简单描述spark集群的安装过程, 并讲述spark的standalone模式, 以及对相关的脚本进行简单的分析. s ...
- Spark集群 + Akka + Kafka + Scala 开发(4) : 开发一个Kafka + Spark的应用
前言 在Spark集群 + Akka + Kafka + Scala 开发(1) : 配置开发环境中,我们已经部署好了一个Spark的开发环境. 在Spark集群 + Akka + Kafka + S ...
- 实验室中搭建Spark集群和PyCUDA开发环境
1.安装CUDA 1.1安装前工作 1.1.1选取实验器材 实验中的每台计算机均装有双系统.选择其中一台计算机作为master节点,配置有GeForce GTX 650显卡,拥有384个CUDA核心. ...
随机推荐
- 画布 canvas 的相关内容
1.什么是canvas canvas也被叫做画布,是在JavaScript中完成网页图像制作的一个重要的途径,画布是一个矩形区域,在这个矩形区域中你可以利用好这里的每一个像素.同样在canvas中也有 ...
- 2020年薪30W的Java程序员都要求熟悉JVM与性能调优!
前言 作为Java程序员,你有没有被JVM伤害过?面试的时候是否碰到过对JVM的灵魂拷问? 一.JVM 内存区域划分 1.程序计数器(线程私有) 程序计数器(Program Counter Reg ...
- POI导入导出excel(附工具类)
关于POI导出excel的功能我在前面的文章已经写过了,POI导出excel的三种方式 , 导出表格数据到excel并下载(HSSFWorkbook版) ,本篇文章主要是将导入导出功能进一步地封装,在 ...
- 文件系统(01):基于SpringBoot框架,管理Excel和PDF文件类型
本文源码:GitHub·点这里 || GitEE·点这里 一.文档类型简介 1.Excel文档 Excel一款电子表格软件.直观的界面.出色的计算功能和图表工具,在系统开发中,经常用来把数据转存到Ex ...
- 《快乐编程大本营》java语言训练班 3课:java的运算符
第1节. 算术运算符 第2节. 递增和递减运算符 第3节. 比较运算符 第4节. 逻辑运算符 第5节. 运算符优先级 第6节. 字符串运算 http://code6g.com/pxphp/px/ban ...
- printf的用法进阶
今天来好好总结一下C语言中关于printf的常用用法 基础部分 printf("%d\n", numInt); printf("%f\n", numFloat) ...
- python dict 中的中文处理
dict1 = {'中':'国 '} print dict1 ##{'\xc3\xa4\xc2\xb8\xc2\xad': '\xc3\xa5\xc2\x9b\xc2\xbd'} import jso ...
- POJ_3663_贪心
题目描述: 给你一堆数和一个限定的空间大小,要求求出两个数的和小于等于空间大小的对数. 思路: 贪心,先给一堆数从大到小排序. 第一个数取数组第一个,第二个数从第二个开始依次往后取,只要某个第二个数满 ...
- 永久解决AndroidStudio Aapt2的问题
https://blog.csdn.net/qq_37280248/article/details/80142260 修改电脑c://user/王明 中文名去掉 https://www.jb51.ne ...
- Go语言实现:【剑指offer】链表中环的入口结点
该题目来源于牛客网<剑指offer>专题. 给一个链表,若其中包含环,请找出该链表的环的入口结点,否则,输出null. Go语言实现: /** * Definition for sing ...