
2017数据科学报告:机器学习工程师年薪最高,Python最常用
2017数据科学报告:机器学习工程师年薪最高,Python最常用
数据平台 Kaggle 近日发布了2017 机器学习及数据科学调查报告,针对最受欢迎的编程语言、不同国家数据科学家的平均年龄、不同国家的平均年薪等进行深度调查。此次调查共收到16000余份回复。
以下「AI脑力波」小编对该报告数据进行了梳理编译,供大家参考。
年龄
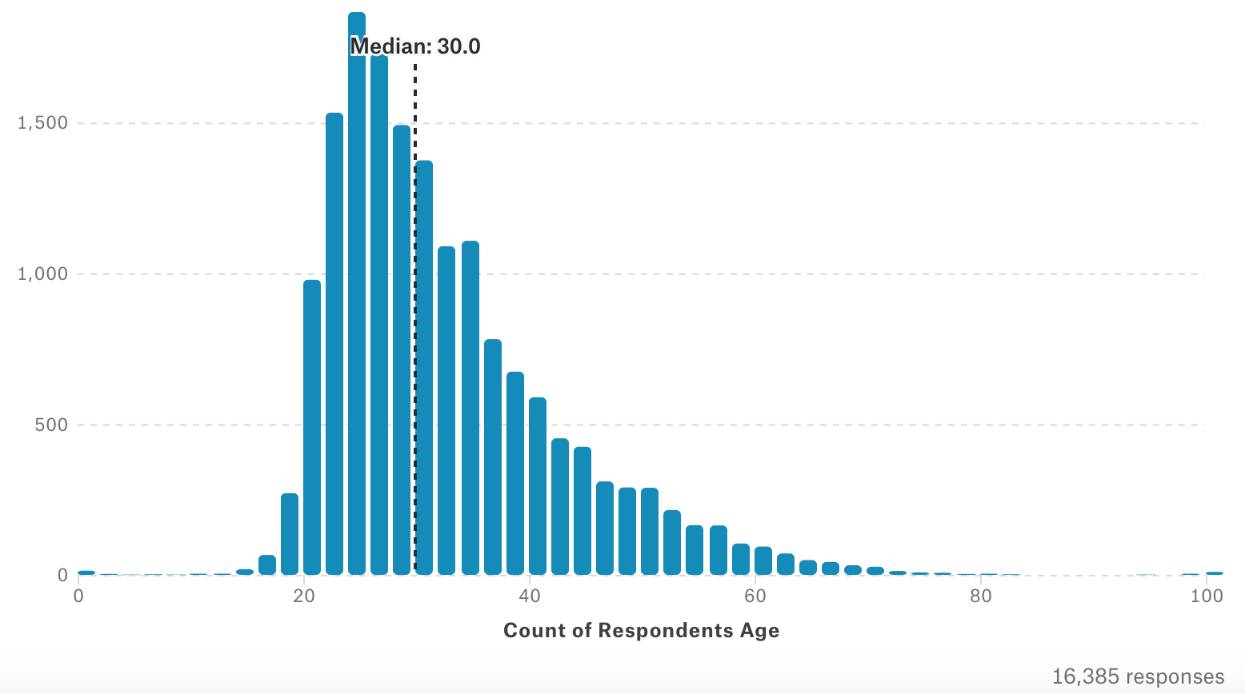
从全球范围来看,本次调查对象的平均年龄在30岁左右。在不同的国家,数值会有所差异,加拿大接受问卷调查的平均年龄为34岁,而中国的机器学习从业者年龄的中位数是25岁。
工作状态
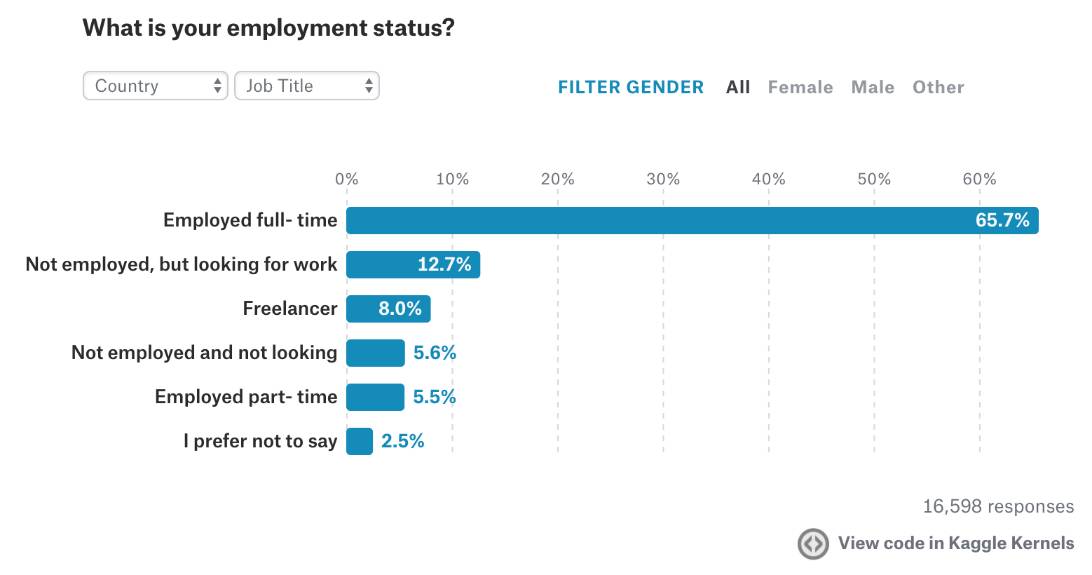
全球全职工作者为 65.7% ,其中中国为 53.% ,美国占比较高,达70.9%。
职位
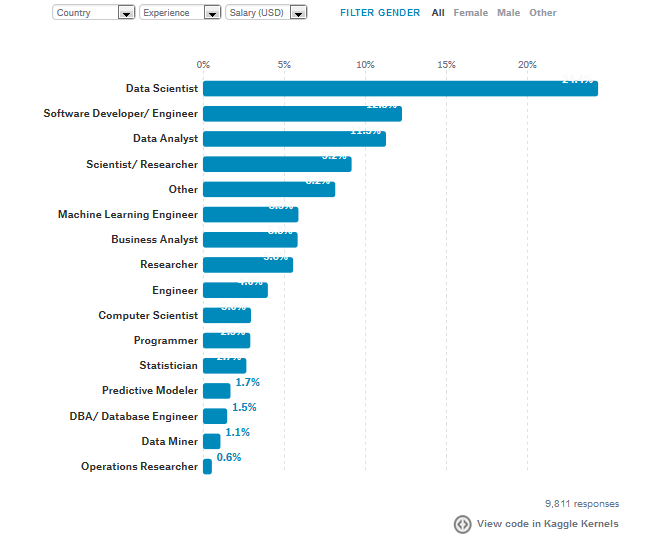
数据科学领域可涵盖的工作非常多,包括机器学习工程师、数据分析师、数据科学家、软件开发人员、数据挖掘人员等。其中,数据科学家人数占比最高,达24.4%。软件开发人员/工程师位居第二,但人数仅占12.3%,数据分析师紧跟其后,以11.3%位列第三。
年薪
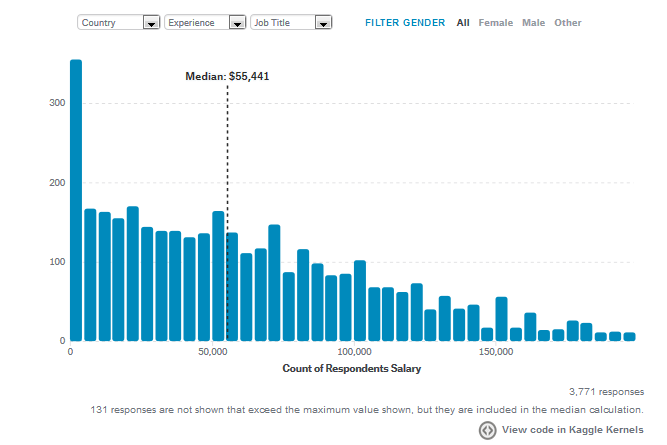
从全球来看,人们普遍认为“职业进修机会”比“薪酬福利”要更重要一些。数据科学人员的年薪中位数为$55,441。在中国,数据科学家的年薪中位数为$29,835。美国则高达$110,000。
最高学历
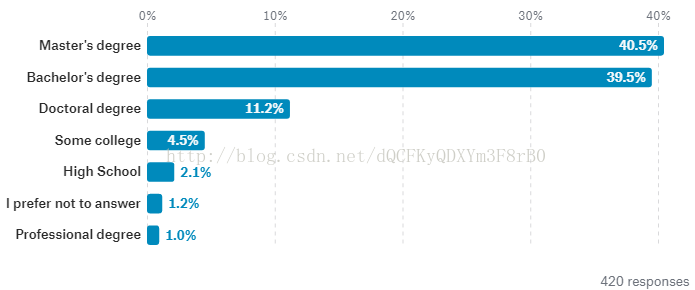
通常来讲,数据科学从业者中最普遍的学历是硕士,但一般来讲,博士学位能拿到($150K - $200K 和 $200k+)高薪。
就中国而言,硕士学位在总体占比为40.5%,博士仅11.2%,本科学位从业人数则高达39.5%,与硕士从业人数持平。
而美国,硕士学位只有44.5%,博士学位高达20.7%,本科从业者占比也高达26.5%。
数据科学研究方法
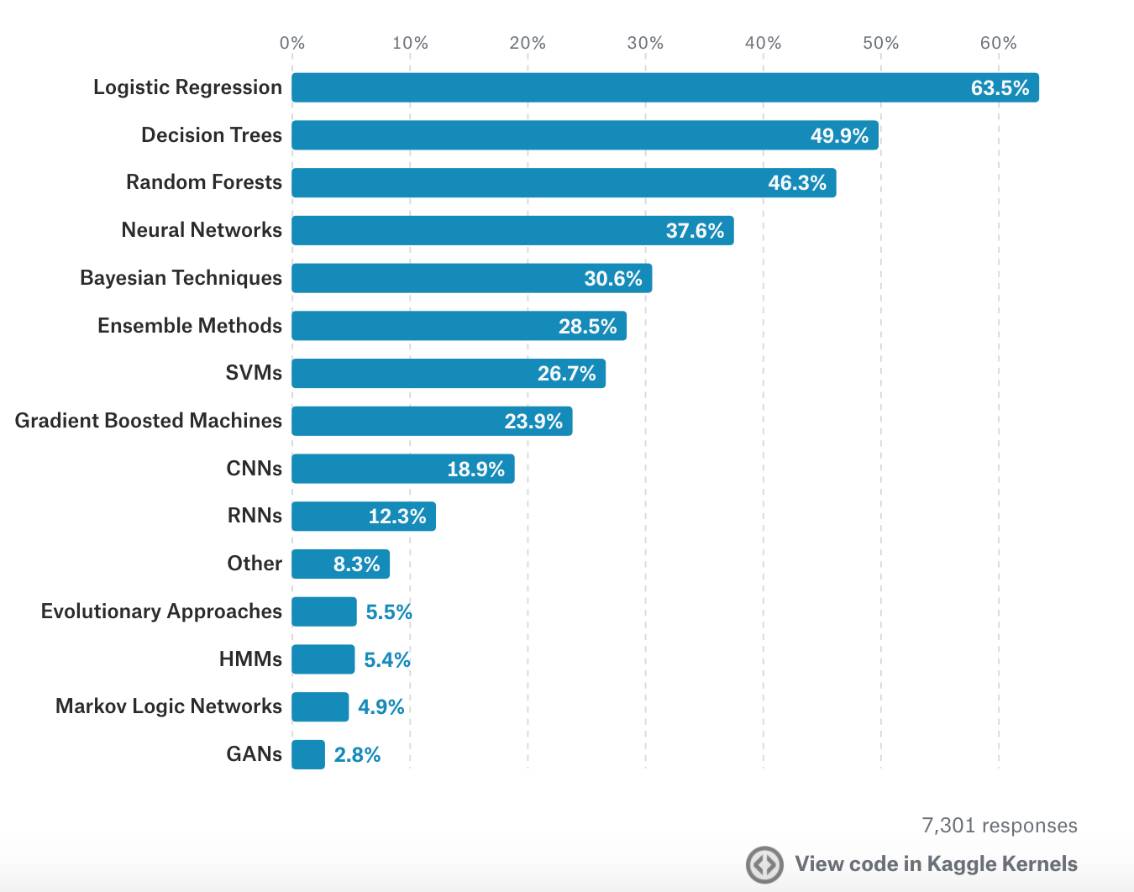
在军事和国安领域外,Logistic回归是最常用的数据科学研究方法。在军事和国防安全领域,神经网络被使用更多。
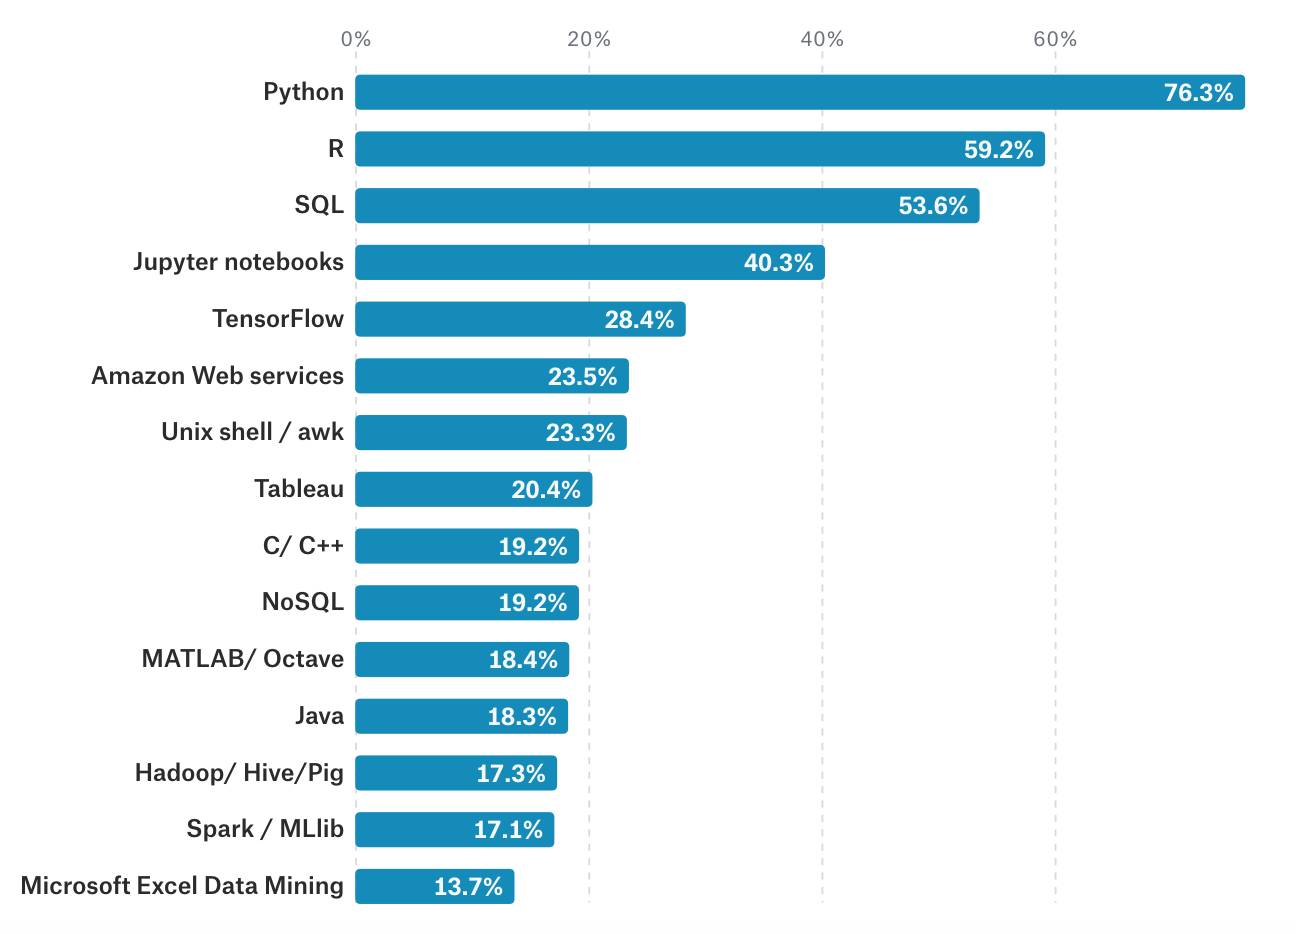
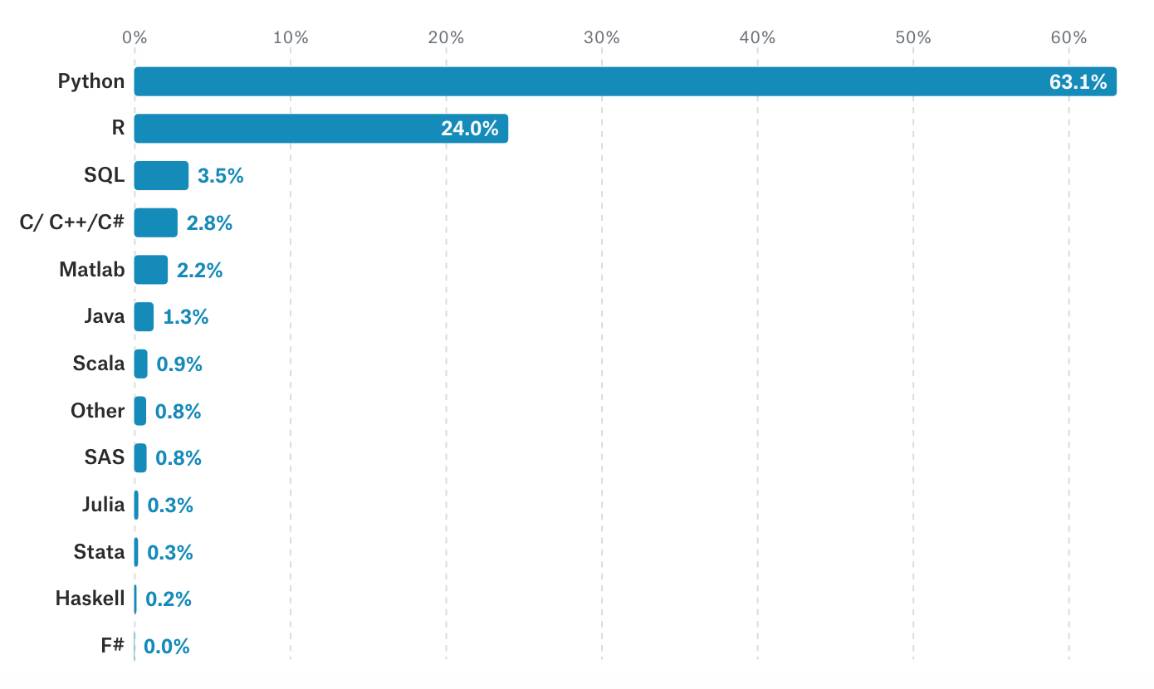
在工具语言使用方面,Python是数据科学家使用最多的语言。同时,统计学家对 R 语言的忠诚度很高。
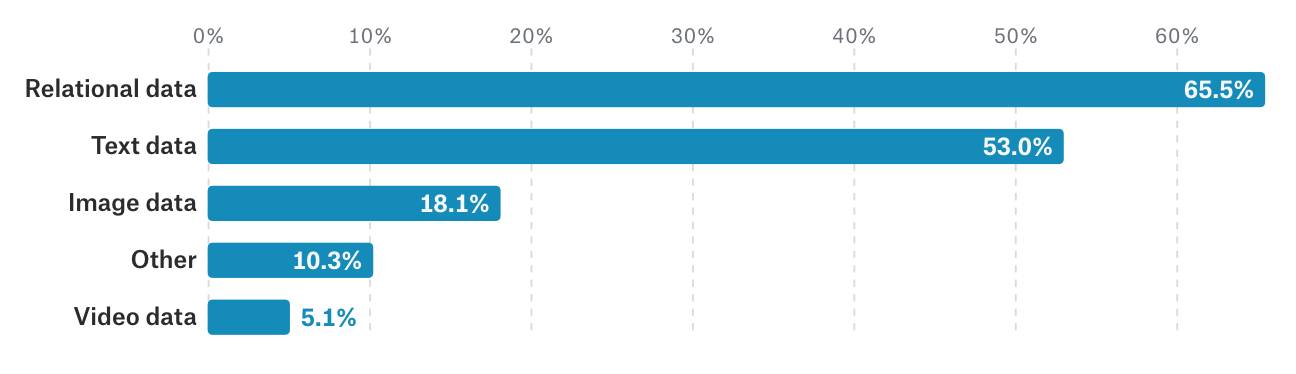
关系型数据是最常用的数据类型,学术研究者和国防安全领域则更亲睐文本和图像。
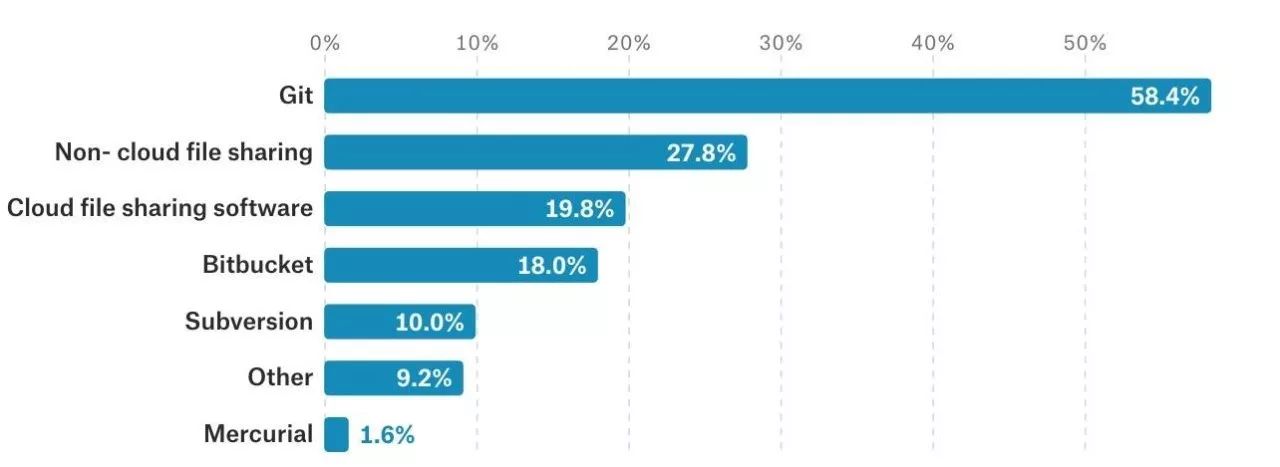
Git 是他们最常用的代码共享和托管方式。
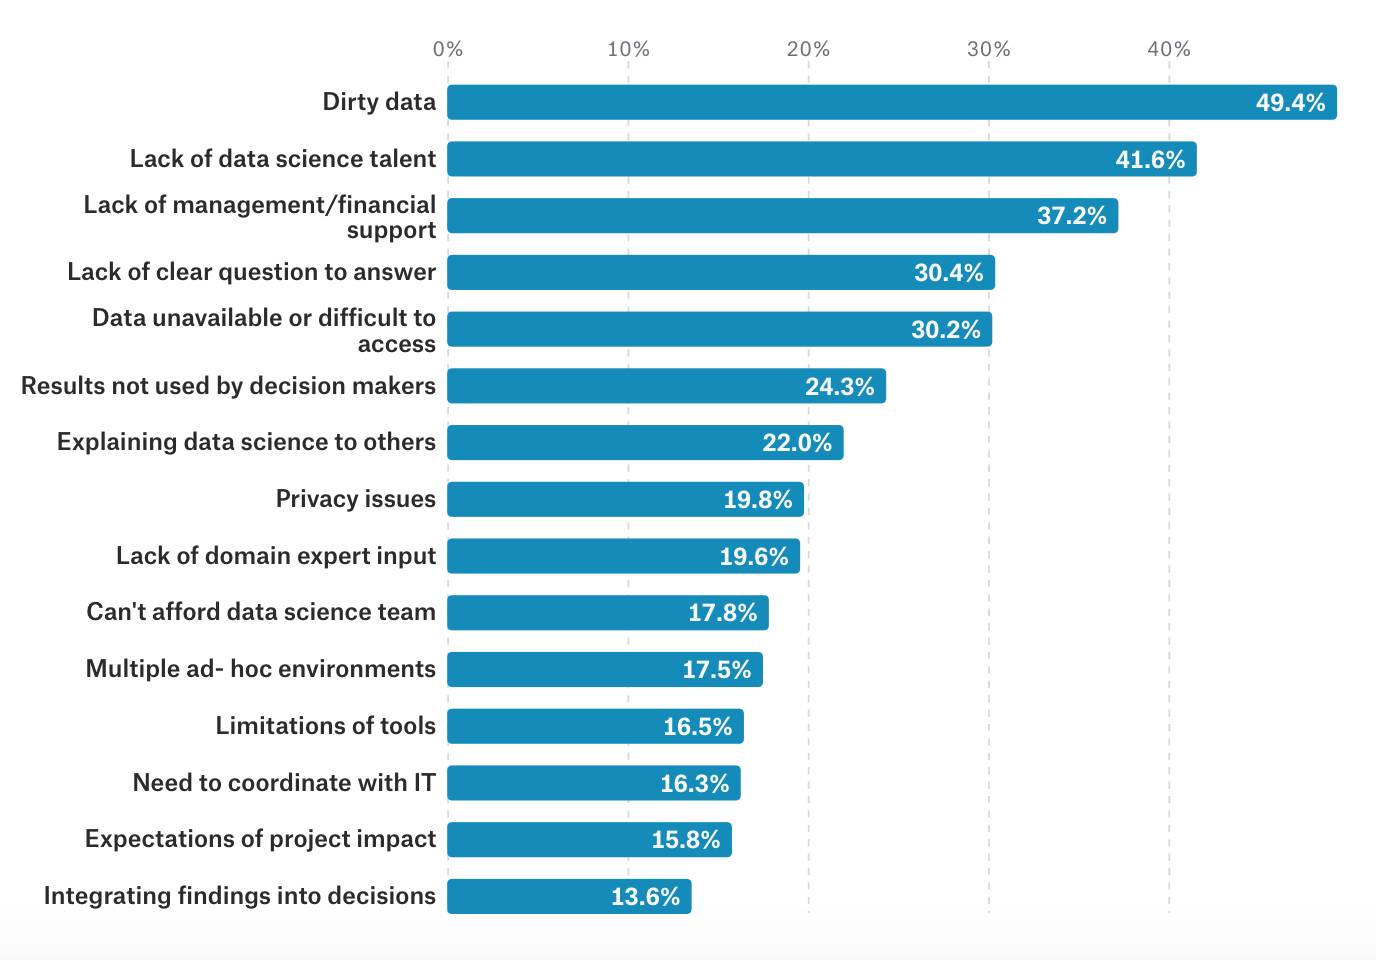
Dirty Data (脏数据)是从业者遇到的最大障碍。此外,理解不同算法的能力不够也是困扰数据工作者的一大障碍。缺乏有效管理和资金支持,是面临的两大外在困境。
有趣的是,只使用 Python 或只使用 R 的都觉得他们做出了正确的选择。 但是,如果你去询问那些既使用 Python 也使用 R 的人,推荐使用 Python 的可能会是 R 的两倍。
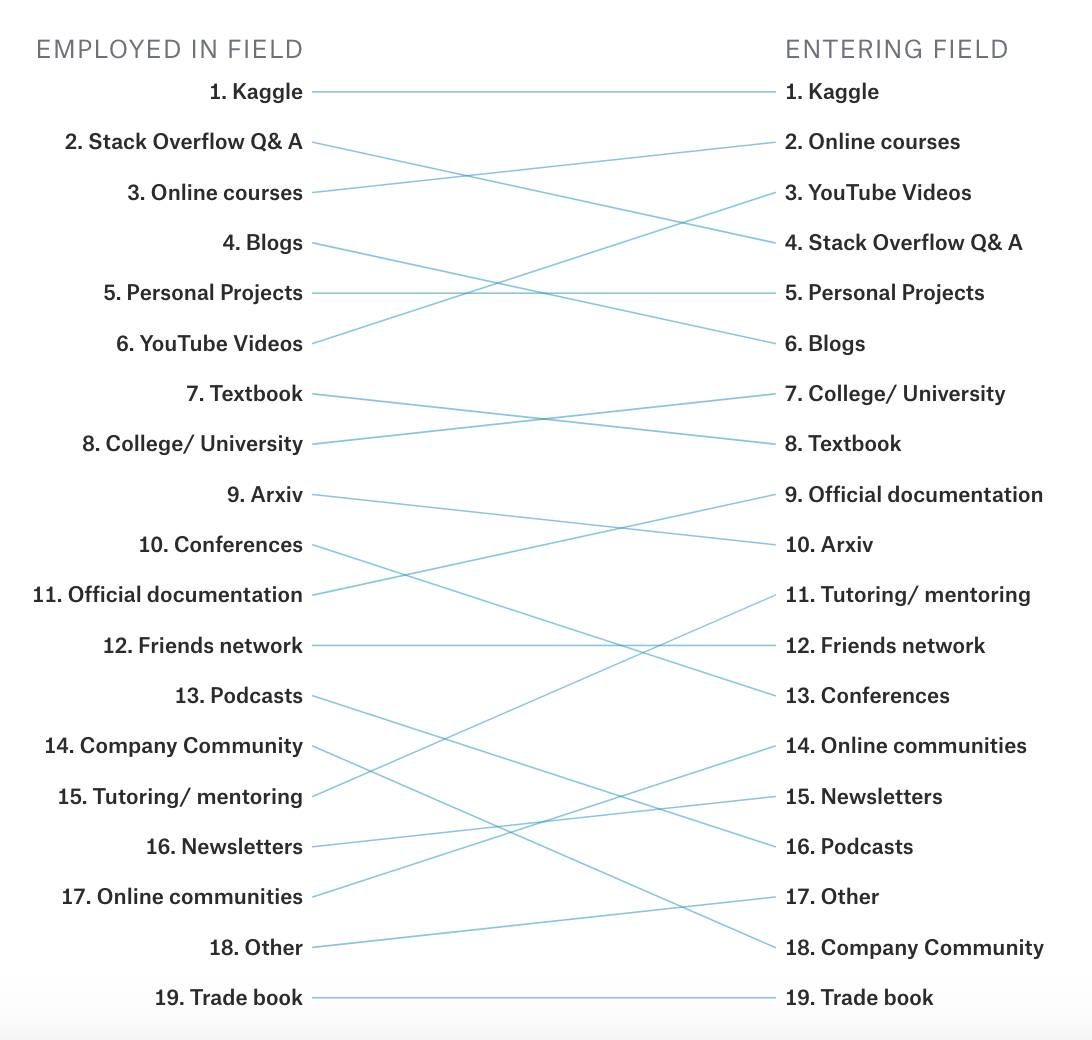
数据科学是个变化极快的领域,业内人员需要不断更新知识体系,才可以在业内保持一定地位,不被时代淘汰。Stack Overflow Q&A、Conferences 和 Podcasts 是已从业者经常使用的学习平台。
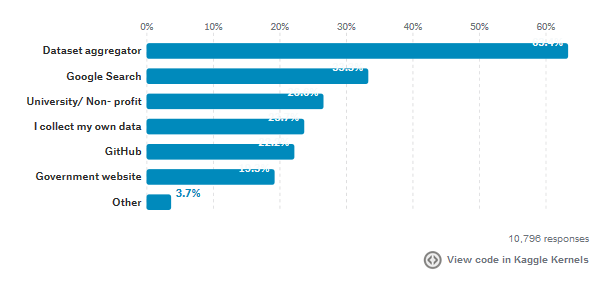
开放型数据源
没有数据就没有数据科学。因此,数据科学家了解如何才能找到干净的开放型数据,用于实践和项目十分重要。据调查显示,数据聚合平台是人们最常用获取数据的途径,其次是谷歌。
(以上图片全部来自:https://www.kaggle.com/surveys/2017)
2017数据科学报告:机器学习工程师年薪最高,Python最常用的更多相关文章
- (数据科学学习手札50)基于Python的网络数据采集-selenium篇(上)
一.简介 接着几个月之前的(数据科学学习手札31)基于Python的网络数据采集(初级篇),在那篇文章中,我们介绍了关于网络爬虫的基础知识(基本的请求库,基本的解析库,CSS,正则表达式等),在那篇文 ...
- (数据科学学习手札47)基于Python的网络数据采集实战(2)
一.简介 马上大四了,最近在暑期实习,在数据挖掘的主业之外,也帮助同事做了很多网络数据采集的内容,接下来的数篇文章就将一一罗列出来,来续写几个月前开的这个网络数据采集实战的坑. 二.马蜂窝评论数据采集 ...
- (数据科学学习手札80)用Python编写小工具下载OSM路网数据
本文对应脚本已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 我们平时在数据可视化或空间数据分析的过程中经常会 ...
- 数据科学VS机器学习
数据科学是一个范围很广的学科.机器学习和统计学都是数据科学的一部分.机器学习中的学习一词表示算法依赖于一些数据(被用作训练集)来调整模型或算法的参数.这包含了许多的技术,比如回归.朴素贝叶斯或监督聚类 ...
- Python数据科学手册-机器学习:朴素贝叶斯分类
朴素贝叶斯模型 朴素贝叶斯模型是一组非常简单快速的分类方法,通常适用于维度非常高的数据集.因为运行速度快,可调参数少.是一个快速粗糙的分类基本方案. naive Bayes classifiers 贝 ...
- Python数据科学手册-机器学习: 决策树与随机森林
无参数 算法 随机森林 随机森林是一种集成方法,集成多个比较简单的评估器形成累计效果. 导入标准程序库 随机森林的诱因: 决策树 随机森林是建立在决策树 基础上 的集成学习器 建一颗决策树 二叉决策树 ...
- Python数据科学手册-机器学习介绍
机器学习分为俩类: 有监督学习 supervised learning 和 无监督学习 unsupervised learning 有监督学习: 对数据的若干特征与若干标签之间 的关联性 进行建模的过 ...
- Python数据科学手册-机器学习: k-means聚类/高斯混合模型
前面学习的无监督学习模型:降维 另一种无监督学习模型:聚类算法. 聚类算法直接冲数据的内在性质中学习最优的划分结果或者确定离散标签类型. 最简单最容易理解的聚类算法可能是 k-means聚类算法了. ...
- Python数据科学手册-机器学习: 流形学习
PCA对非线性的数据集处理效果不太好. 另一种方法 流形学习 manifold learning 是一种无监督评估器,试图将一个低维度流形嵌入到一个高纬度 空间来描述数据集 . 类似 一张纸 (二维) ...
随机推荐
- 【EWM系列】SAP 关于EWM的WT增强简介
公众号:SAP Technical 本文作者:matinal 原文出处:http://www.cnblogs.com/SAPmatinal/ 原文链接:[MM系列]SAP 关于EWM的WT增强简介 ...
- python学习第四十五天__name__用法和作用
在python导入模块导入另外一个模块的时候,有时候只是想用其一个方法,会出现其他的方法也运行了,python用到__name__==‘__main__’ 解决问题,那么__name__用法和作用 1 ...
- Hdu 4578 Transformation (线段树 分类分析)
Transformation Time Limit: 15000/8000 MS (Java/Others) Memory Limit: 65535/65536 K (Java/Others)T ...
- Java并发知识总结
jixu 8. 并发 启动线程的几种方式 Thread t7 = new Thread(timer); t7.start(); Thread.sleep(100) //暂停当前线程 class MT ...
- spark复习笔记(7):sparkSQL
一.saprkSQL模块,使用类sql的方式访问Hadoop,实现mr计算,底层使用的是rdd 1.hive //hadoop mr sql 2.phenoix //hbase上构建sql的交互过 ...
- 帝国CMS链接域名重写、伪静态处理
需求:将 www.abc.com/e/tags?tagsid=1 改写成 www.abc.com/softlink/1.html形式: 环境:Windows服务器: 路径:D:/web/www.ab ...
- 前端开发HTML&css入门——盒子模型以及部分CSS样式
CSS处理网页时,它认为每个元素都包含在一个不可见的盒子里.• 为什么要想象成盒子呢?因为如果把所有的元素都想象成盒子,那么我们对网页的布局就相当于是摆放盒子.• 我们只需要将相应的盒子摆放到网页中相 ...
- JavaScript深入之从原型到原型链(转载)
构造函数创建对象 我们先使用构造函数创建一个对象: function Person() { } var person = new Person(); person.name = 'Kevin'; co ...
- 6个优秀的微信小程序ui组件库
开发微信小程序的过程中,选择一款好用的组件库,可以达到事半功倍的效果.自从微信小程序面世以来,不断有一些开源组件库出来,下面6款就是排名比较靠前,用户使用量与关注度比较高的小程序UI组件库.还没用到它 ...
- [好好学习]在VMware中安装Oracle Enterprise Linux (v5.7) - (5/5)