
Python数据科学手册-机器学习介绍
机器学习分为俩类: 有监督学习 supervised learning 和 无监督学习 unsupervised learning
有监督学习: 对数据的若干特征与若干标签之间 的关联性 进行建模的过程。 只要模型被确定,就可以应用到新的未知的数据上。
进一步可以分为 分类 classification 任务 和 回归 regression 任务。
分类任务: 标签是离散值。
回归任务: 标签是连续值。无监督学习: 指对不带任何标签的数据特征进行建模。 让数据自己介绍自己。 包括 聚类 clustering 任务 和 降维 dimensionality reduction 任务。
聚类算法: 将数据分成不同组。
降维算法:追求用更简洁的方式表现数据。半监督 学习 semi-supervised learning 。介于有监督学习和无监督学习之间, 在数据标签不完整时使用。
Scikit-Learn 简介
Scikit-Learn 的 数据表示 data representation
机器学习是从数据创建模型的学问。 因此你首先需要了解咋样表示数据才能让计算机理解。 Scikit-Learn认为 是数据表。
数据表
鸢尾花 数据集
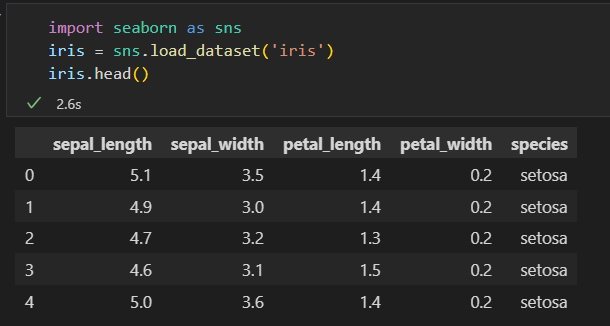
矩阵的行 称为 样本 samples. 行数记为 n_samples
每列数据表示每个样本 某个特征的量化值 。 矩阵的列 称为 特征 features 列数记为 n_features
特征矩阵。 features matrix
通过二维数据或举证的形式将信息清晰地表达出来。
间记为:X ,维度为 【n_samples, n_features】的 二维矩阵。一般用NumPy数组或Pandas 的DataFrame来表示。目标数据
需要一个标签 或 目标数组,通常 简记为 y
目标数组 一般是 一维数组。 长度就是样本总数 n_samples.
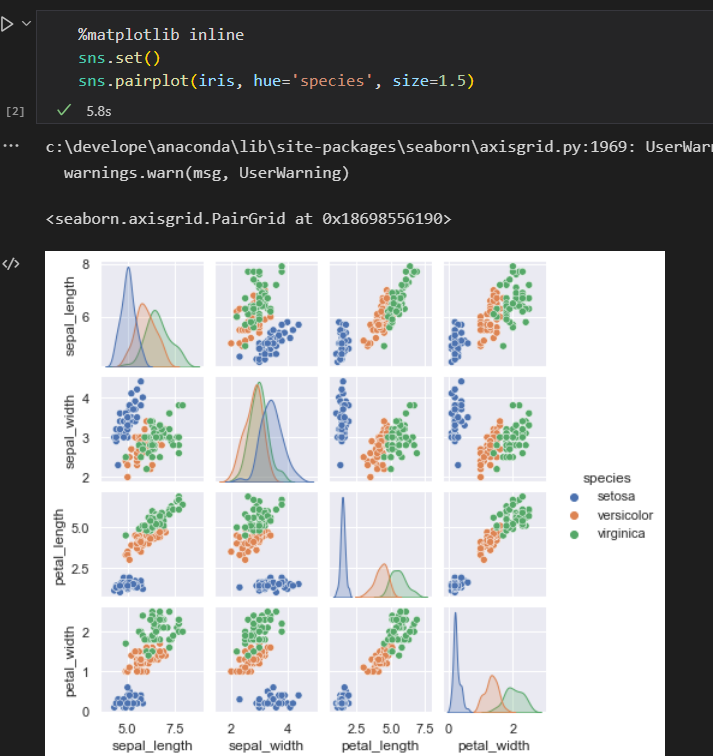
对数据进行可视化
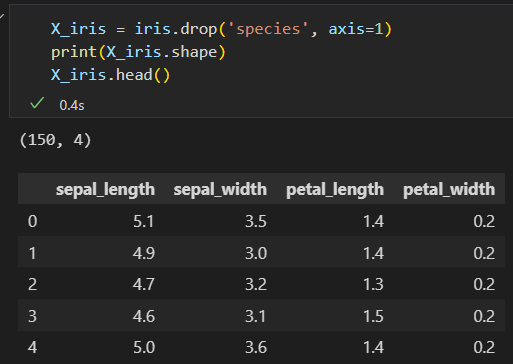
- 抽取特征矩阵 和目标数组
特征矩阵如下
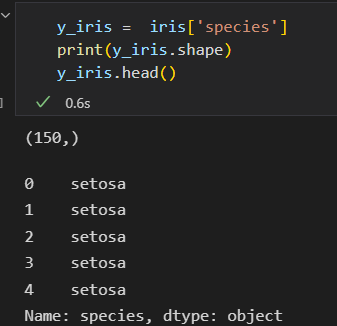
目标数组如下
Scikit-Learn 的评估器API
设计原则:
- 统一性
所有对象使用共同接口连接一组方法和统一文档 - 内省
所有参数值都是公共属性 - 限制对象层级
只有算法可以用python类表示。数据集都用标准数据类型 Numpy数组 DataFrame Scipy稀疏矩阵表示。 参数名称 用标准的Python字符串。 - 函数组合
- 明智的默认值
API基础知识
常用步骤如下
1)从Scikit-Learn 导入适当的评估器类, 选择模型类。
2)用合适 的数值对模型类 进行实例化,配置模型超参数 hyperparameter
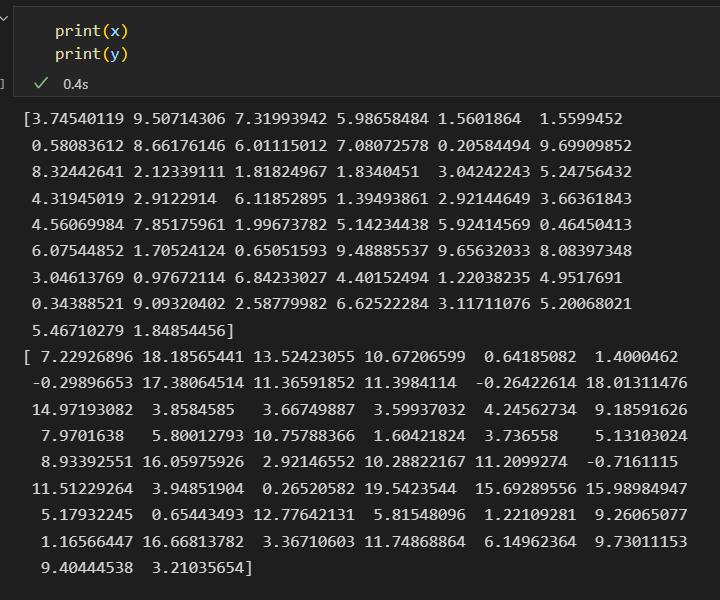
3) 整理数据,获取 特征矩阵和 目标数组。
4) 调用模型实例 的fit()方法对数据进行 拟合
5)对新数据应用模型。
- 有监督学习模型中: 通常使用predict()方法预测新数据的标签
- 无监督学习模型中: 通常使用transform() 或 predict() 方法转换 或 推断数据的性质
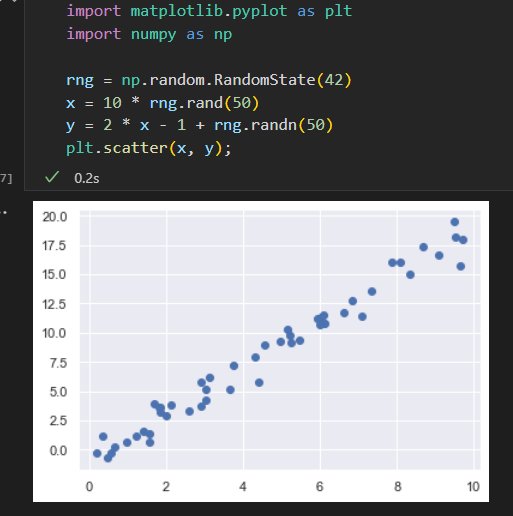
有监督学习实例:简单线性回归。
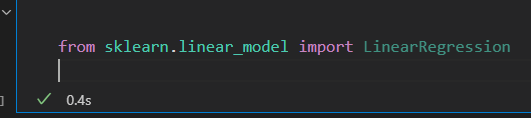
1)选择模型类
每个模型类都是一个Python类。 简单的线性回归模型。 直接导入 线性回归模型类
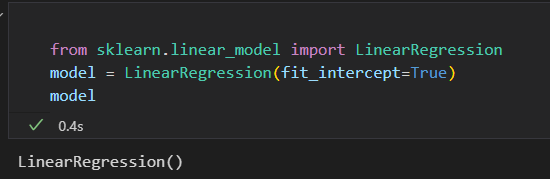
2)选择模型超参数
选择了模型之后,需要配置参数。
3)将数据整理成特征矩阵 和 目标数组
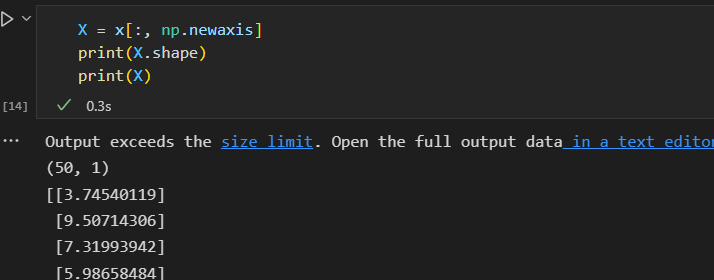
4)用模型拟合数据
fit()方法获取的 模型参数都带一条下划线。
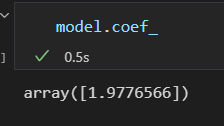
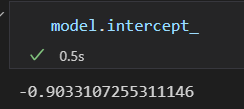
这俩个参数分别表示 对 样本数据 拟合直线的 斜率 和 截距 。
5)预测新数据的标签
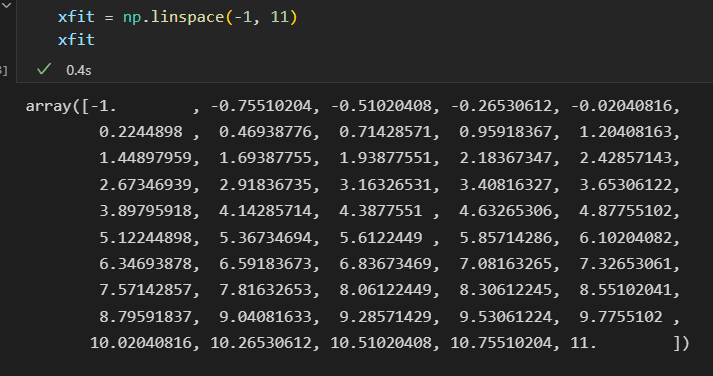
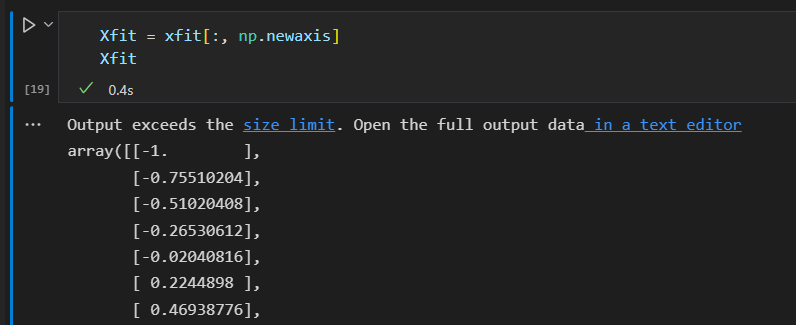
预测
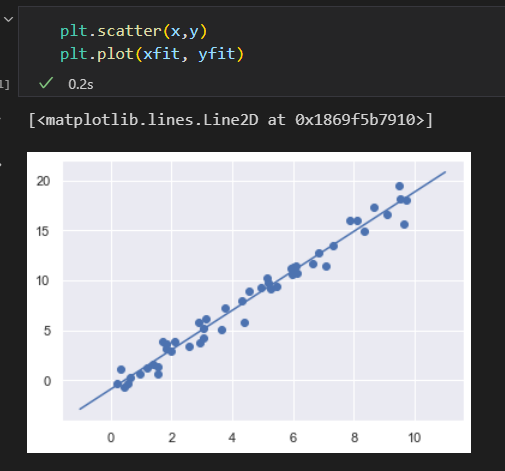
原始数据 和 拟合记过可视化
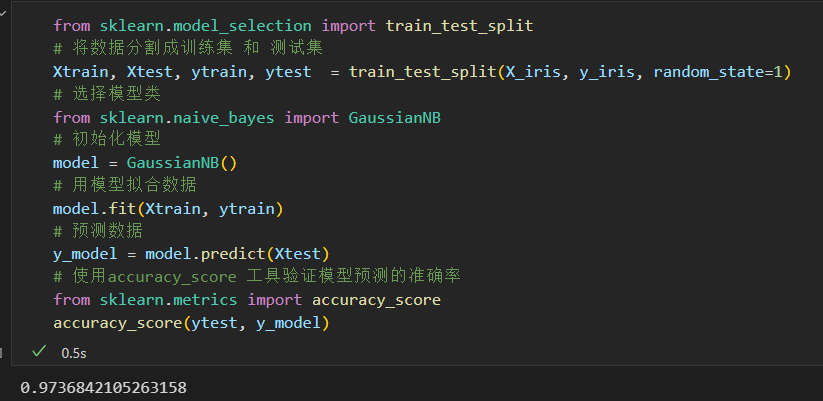
有监督学习示例:鸢尾花数据分类
无监督学习示例:鸢尾花数据降维
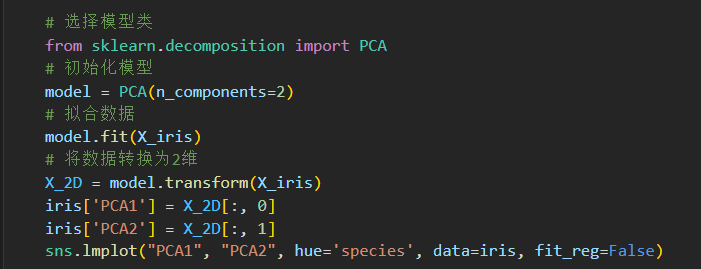
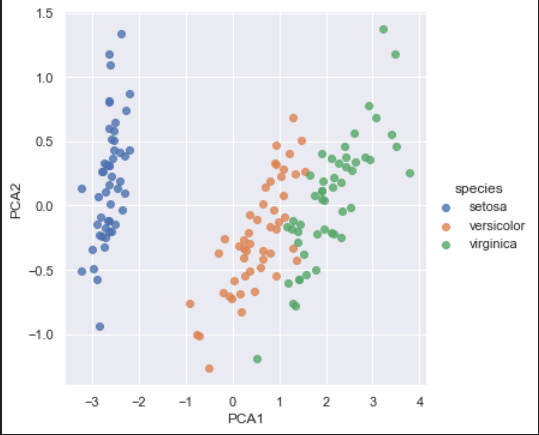
对鸢尾花数据进行降维,以便更方便的对数据进行可视化,
降维的任务是要找到一个可以保留数据本质特征的 低维 矩阵来表示高维 数据。
使用 主成分 分析方法 PCA principal component analysis . 是一个快速线性降维技术。
用模型返回俩个主成分。 用二维数据表示 鸢尾花的思维数据。
无监督学习示例: 鸢尾花数据聚类
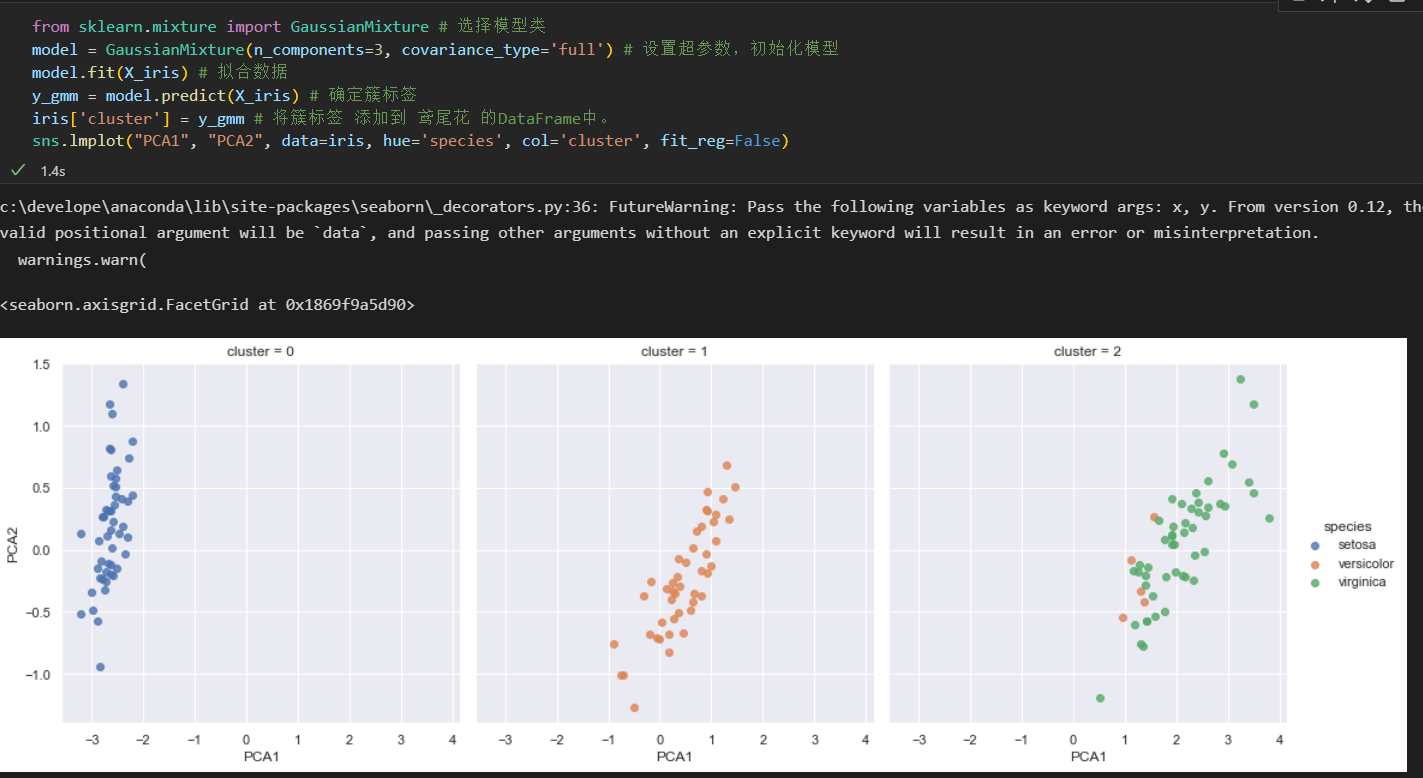
聚类算法是要对没有任何标签的数据集 进行分组。
使用一个强大的聚类方法-高斯混合模型 Gaussian mixture model GMM
GMM 模型 试图将数据构造成若干服从高斯分布的概率密度函数簇。
手写数字探索。
加载并可视化手写数字
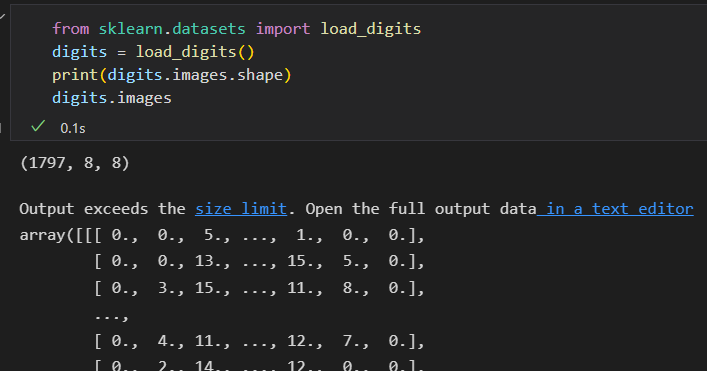
每张图像是 8 * 8 像素
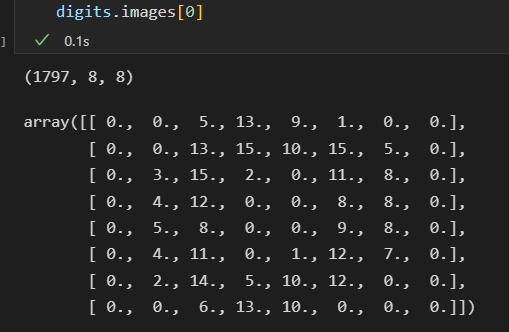
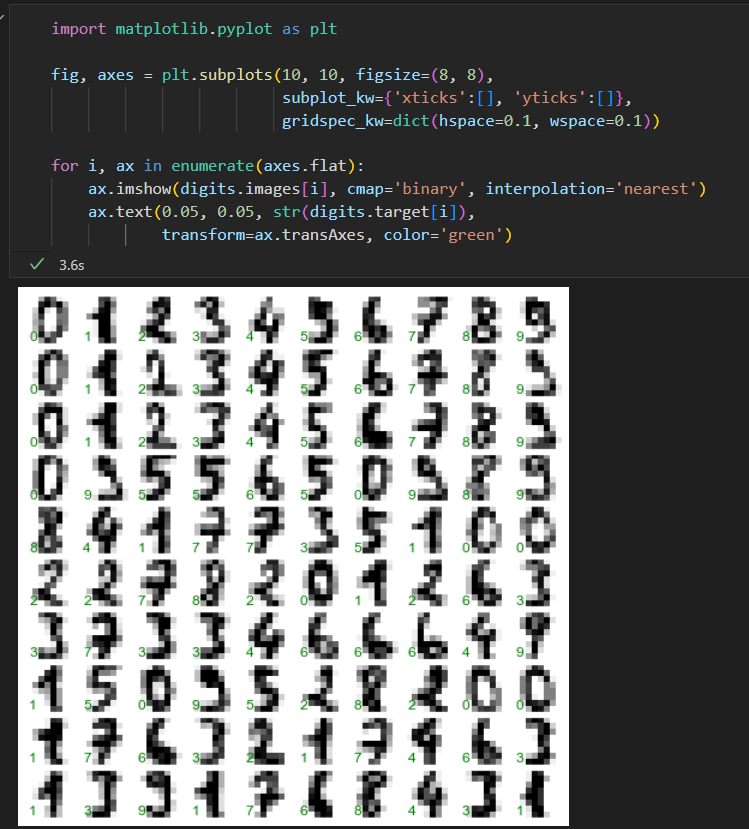
前一百张图可视化
为了在Scikit-Learn中使用数据,需要一个维度为【n_samples, n_features】的二维特征居住证。 可以将每个样本独享的所有像素作为特征。 8*8 = 64 个特征。 平铺成长度为64 的 一维数组。
目标数组:表示每个数字的真实值。

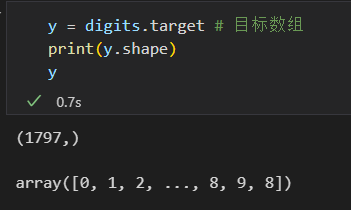
无监督学习:降维
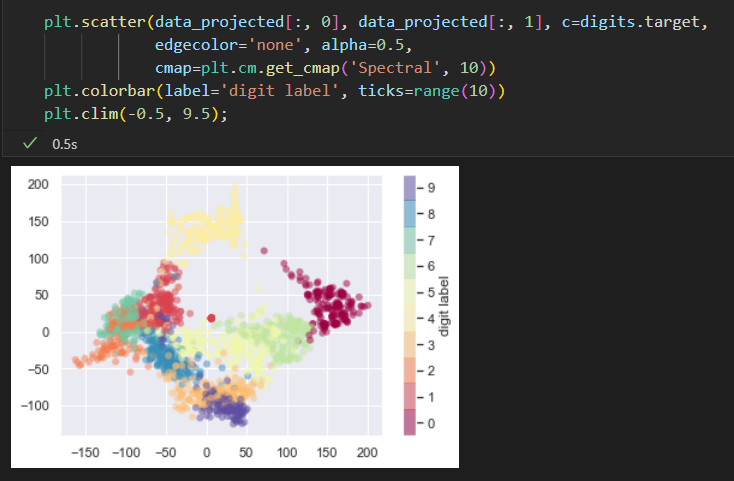
对64维参数进行可视化十分困难。 需要建筑 无监督学习方法将维度 降到 二维。
使用流形学习算法中的 lsomap 对数据进行降维
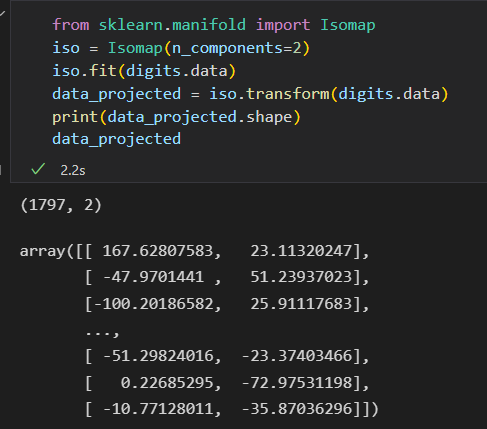
可视化
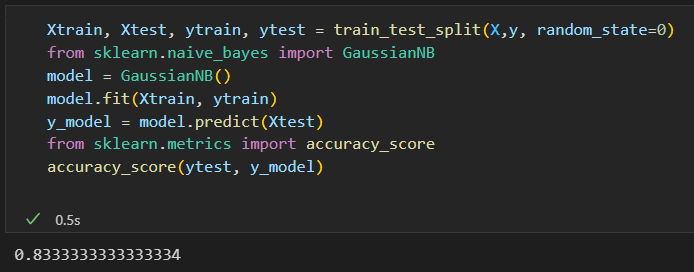
数字分类
找到一个分类算法,对手写数字进行分类。
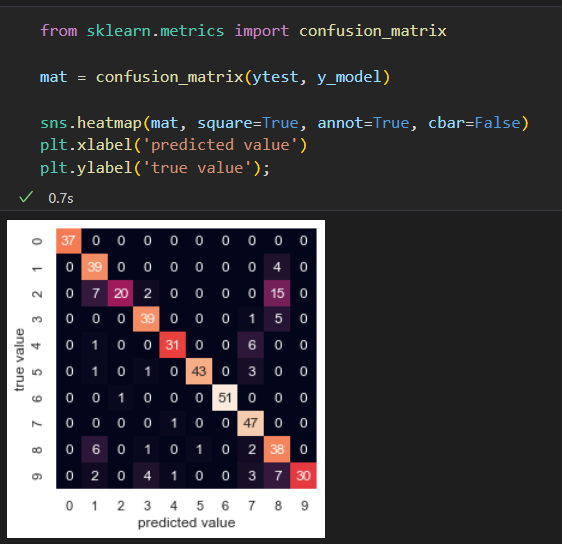
使用混淆矩阵 看哪里做的不好
Python数据科学手册-机器学习介绍的更多相关文章
- Python数据科学手册-机器学习:朴素贝叶斯分类
朴素贝叶斯模型 朴素贝叶斯模型是一组非常简单快速的分类方法,通常适用于维度非常高的数据集.因为运行速度快,可调参数少.是一个快速粗糙的分类基本方案. naive Bayes classifiers 贝 ...
- Python数据科学手册-机器学习之特征工程
特征工程常见示例: 分类数据.文本.图像. 还有提高模型复杂度的 衍生特征 和 处理 缺失数据的填充 方法.这个过程被叫做向量化.把任意格式的数据 转换成具有良好特性的向量形式. 分类特征 比如房屋数 ...
- Python数据科学手册-机器学习: k-means聚类/高斯混合模型
前面学习的无监督学习模型:降维 另一种无监督学习模型:聚类算法. 聚类算法直接冲数据的内在性质中学习最优的划分结果或者确定离散标签类型. 最简单最容易理解的聚类算法可能是 k-means聚类算法了. ...
- Python数据科学手册-机器学习: 流形学习
PCA对非线性的数据集处理效果不太好. 另一种方法 流形学习 manifold learning 是一种无监督评估器,试图将一个低维度流形嵌入到一个高纬度 空间来描述数据集 . 类似 一张纸 (二维) ...
- Python数据科学手册-机器学习: 主成分分析
PCA principal component analysis 主成分分析是一个快速灵活的数据降维无监督方法, 可视化一个包含200个数据点的二维数据集 x 和 y有线性关系,无监督学习希望探索x值 ...
- Python数据科学手册-机器学习: 决策树与随机森林
无参数 算法 随机森林 随机森林是一种集成方法,集成多个比较简单的评估器形成累计效果. 导入标准程序库 随机森林的诱因: 决策树 随机森林是建立在决策树 基础上 的集成学习器 建一颗决策树 二叉决策树 ...
- Python数据科学手册-机器学习: 支持向量机
support vector machine SVM 是非常强大. 灵活的有监督学习算法, 可以用于分类和回归. 贝叶斯分类器,对每个类进行了随机分布的假设,用生成的模型估计 新数据点 的标签.是属于 ...
- Python数据科学手册-机器学习:线性回归
朴素贝叶斯是解决分类任务的好起点,线性回归是解决回归任务的好起点. 简单线性回归 将数据拟合成一条直线. y = ax + b , a 是斜率, b是直线截距 原始数据如下: 使用LinearRegr ...
- Python数据科学手册-机器学习之模型验证
模型验证 model validation 就是在选择 模型 和 超参数 之后.通过对训练数据进行学习.对比模型对 已知 数据的预测值和实际值 的差异. 错误的模型验证方法. 用同一套数据训练 和 评 ...
随机推荐
- NC25136 [USACO 2006 Ope B]Cows on a Leash
NC25136 [USACO 2006 Ope B]Cows on a Leash 题目 题目描述 给定如图所示的若干个长条.你可以在某一行的任意两个数之间作一条竖线,从而把这个长条切开,并可能切开其 ...
- Android Studio的初次认识
Android的初试 一.认识Android Studio 在我们新建项目的时候,会遇到这样的一个窗口,首先我们认识一下这些都是什么,这样我们才能够更好的进行下一步的学习! 这里的 Phone and ...
- JetBrains系列软件激活
1.将以下记录加入hosts文件 0.0.0.0 account.jetbrains.com0.0.0.0 www.jetbrains.com 2.激活方式选择licence server,填写以下激 ...
- APISpace 让你快速获取笑话大全
最近公司项目有一个随机展示各类笑话的小需求,想着如果用现成的API就可以大大提高开发效率,在网上的API商店搜索了一番,发现了 APISpace,它里面的 笑话大全API 非常符合我的开发需求. ...
- (一)java基础篇---第一个程序
先认识java的基础知识 1.变量命名规则 :1)变量名由数字字母下划线组成,2)不能使用java的关键字,比如public这种,3)遵循小驼峰命名法 2.数据类型 2.1基本数据类型有8种 其中分为 ...
- hive常用函数 wordCount--Hive窗口函数1.1.1 聚合开窗函数聚合开窗函数实战
第三天笔记 第三天笔记 SQL练习Hive 常用函数关系运算数值计算条件函数日期函数重点!!!字符串函数Hive 中的wordCount1.1 Hive窗口函数1.1.1 聚合开窗函数聚合开窗函数实战 ...
- 小C的记事本_via牛客网
题目 链接:https://ac.nowcoder.com/acm/contest/28537/G 来源:牛客网 时间限制:C/C++ 2秒,其他语言4秒 空间限制:C/C++ 131072K,其他语 ...
- 方法引用_通过this引用本类的成员方法和方法引用_类的构造器(构造方法)引用和数组的构造器引用
package com.yang.Test.ThisMethodReference; /** * 通过this引用本类的成员方法 */ public class Husband { //定义一个买房子 ...
- Kubernetes的整体架构
K8s将集群中的机器划分为一个主节点和一群工作节点,在主节点上运行着集群管理相关的一组进程kube-apiserver.kube-controller-manager 和 kube-scheduler ...
- 【原创】Python 极验滑块验证
本文仅供学习交流使用,如侵立删! 记一次 极验滑块验证分析并通过 操作环境 win10 . mac Python3.9 selenium.seleniumwire 分析 最近在做的一个项目登录时会触发 ...