
大数据笔记(十八)——Pig的自定义函数
Pig的自定义函数有三种:

1、自定义过滤函数:相当于where条件

2、自定义运算函数:

3、自定义加载函数:使用load语句加载数据,生成一个bag

                                          默认:一行解析成一个Tuple

                                         需要MR的jar包
一.自定义过滤函数
package demo.pig;

import java.io.IOException;

import org.apache.pig.FilterFunc;

import org.apache.pig.data.Tuple;

//实现自定义的过滤函数,实现:查询过滤薪水大于2000的员工

public class IsSalaryTooHigh extends FilterFunc{

    @Override

    public Boolean exec(Tuple tuple) throws IOException {

        /*参数tuple:调用的时候 传递的参数

         *

         * 在PigLatin调用

         * myresult1 = filter emp by demo.pig.IsSalaryTooHigh(sal)

         */

        //取出薪水

        int sal = (int) tuple.get(0);

        return sal>2000?true:false;

    }

}
二.自定义运算函数
package demo.pig;

import java.io.IOException;

import org.apache.pig.EvalFunc;

import org.apache.pig.data.Tuple;

//根据员工的薪水判断级别

public class CheckSalaryGrade extends EvalFunc<String>{

    @Override

    public String exec(Tuple tuple) throws IOException {

        // myresult2 = foreach emp generate ename,sal,demo.pig.CheckSalaryGrade(sal);

        int sal = (int)tuple.get(0);

        if(sal<1000) return "Grade A";

        else if(sal>=1000 && sal<3000) return "Grade B";

        else return "Grade C";

    }

}
三.自定义加载函数

package demo.pig;

import java.io.IOException;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.mapreduce.InputFormat;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.RecordReader;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

import org.apache.pig.LoadFunc;

import org.apache.pig.backend.hadoop.executionengine.mapReduceLayer.PigSplit;

import org.apache.pig.data.BagFactory;

import org.apache.pig.data.DataBag;

import org.apache.pig.data.Tuple;

import org.apache.pig.data.TupleFactory;

public class MyLoadFunc extends LoadFunc{

    //定义一个变量保存输入流

    private RecordReader reader ;

    @Override

    public InputFormat getInputFormat() throws IOException {

        // 输入数据的格式:字符串

        return new TextInputFormat();

    }

    @Override

    public Tuple getNext() throws IOException {

        // 从输入流读取一行,如何解析生成返回的tuple

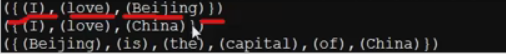
        //数据:I love Beijing

        Tuple result = null;

        try{

            //判断是否读入了数据

            if(!this.reader.nextKeyValue()){

                //没有数据

                return result; //----> 是nullֵ

            }

            //数据:I love Beijing

            String data = this.reader.getCurrentValue().toString();

            //生成返回的结果:Tuple

            result = TupleFactory.getInstance().newTuple();

            //分词

            String[] words = data.split(" ");

            //每一个单词单独生成一个tuple,再把tuple放入bag中

            //再把这个bag放入result中

            //创建一个表

            DataBag bag = BagFactory.getInstance().newDefaultBag();

            for(String w:words){

                //为每个单词生成一个tuple

                Tuple aTuple = TupleFactory.getInstance().newTuple();

                aTuple.append(w); //将单词放到tuple中

                //把这些tuple放入一个bag中

                bag.add(aTuple);

            }

            //把bag放入result

            result.append(bag);

        }catch(Exception ex){

            ex.printStackTrace();

        }

        return result;

    }

    @Override

    public void prepareToRead(RecordReader reader, PigSplit arg1) throws IOException {

        // RecordReader reader:代表HDFS输入流

        this.reader = reader;

    }

    @Override

    public void setLocation(String path, Job job) throws IOException {

        // 从HDFS输入的路径

        FileInputFormat.setInputPaths(job, new Path(path));

    }

}
注册jar包: register define
register /root/temp/p1.jar
myresult3 = load '/input/data.txt' using demo.pig.MyLoadFunc();
定义别名:define myload demo.pig.MyLoadFunc;
大数据笔记(十八)——Pig的自定义函数的更多相关文章
- 大数据笔记(八)——Mapreduce的高级特性(A)
一.序列化 类似于Java的序列化:将对象——>文件 如果一个类实现了Serializable接口,这个类的对象就可以输出为文件 同理,如果一个类实现了的Hadoop的序列化机制(接口:Writ ...
- Opencv笔记(十八)——轮廓的更多函数及其层次结构
凸缺陷 前面我们已经学习了轮廓的凸包,对象上的任何凹陷都被成为凸缺陷.OpenCV 中有一个函数 cv.convexityDefect() 可以帮助我们找到凸缺陷.函数调用如下: hull = cv2 ...
- 大数据笔记(十七)——Pig的安装及环境配置、数据模型
一.Pig简介和Pig的安装配置 1.最早是由Yahoo开发,后来给了Apache 2.支持语言:PigLatin 类似SQL 3.翻译器 PigLatin ---> MapReduce(Spa ...
- 玩转大数据系列之Apache Pig高级技能之函数编程(六)
原创不易,转载请务必注明,原创地址,谢谢配合! http://qindongliang.iteye.com/ Pig系列的学习文档,希望对大家有用,感谢关注散仙! Apache Pig的前世今生 Ap ...
- 跟上节奏 大数据时代十大必备IT技能
跟上节奏 大数据时代十大必备IT技能 新的想法诞生新的技术,从而造出许多新词,云计算.大数据.BYOD.社交媒体……在互联网时代,各种新词层出不穷,让人应接不暇.这些新的技术,这些新兴应用和对应的IT ...
- python3.4学习笔记(十八) pycharm 安装使用、注册码、显示行号和字体大小等常用设置
python3.4学习笔记(十八) pycharm 安装使用.注册码.显示行号和字体大小等常用设置Download JetBrains Python IDE :: PyCharmhttp://www. ...
- 大数据笔记(十六)——Hive的客户端及自定义函数
一.Hive的Java客户端 JDBC工具类:JDBCUtils.java package demo.jdbc; import java.sql.DriverManager; import java. ...
- 跟上节奏 大数据时代十大必备IT技能(转)
新的想法诞生新的技术,从而造出许多新词,云计算.大数据.BYOD.社交媒体……在互联网时代,各种新词层出不穷,让人应接不暇.这些新的技术,这些新兴应用和对应的IT发展趋势,使得IT人必须了解甚至掌握最 ...
- (C/C++学习笔记) 十八. 继承和多态
十八. 继承和多态 ● 继承的概念 继承(inheritance): 以旧类为基础创建新类, 新类包含了旧类的数据成员和成员函数(除了构造函数和析构函数), 并且可以派生类中定义新成员. 形式: cl ...
随机推荐
- keystone验证安装
以管理员的身份来请求鉴权的标识 keystone --os-tenant-name admin --os-username admin --os-password 123456 --os-auth- ...
- 7.golang的字符串 string
golang 字符串为不可变的量 ,字符串定义要使用双引号 package main import "fmt" func main() { var xx string = 'xxx ...
- 画一个心送给心爱的小姐姐,Python绘图库Turtle
Python绘图库Turtle Turtle介绍 Turtle是Python内嵌的绘制线.圆以及其他形状(包括文本)的图形模块. 一个Turtle实际上是一个对象,在导入Turtle模块时,就创建了对 ...
- Scrapy 教程(三)-网站解析
有经验的人都知道,解析网站需要尝试,看看得到的数据是不是想要的,那么在scrapy中怎么尝试呢? 调试工具-shell 主要用于编写解析器 命令行进入shell scrapy shell url 这个 ...
- 通过编写串口助手工具学习MFC过程——(四)添加ComboBox组合框
通过编写串口助手工具学习MFC过程 因为以前也做过几次MFC的编程,每次都是项目完成时,MFC基本操作清楚了,但是过好长时间不再接触MFC的项目,再次做MFC的项目时,又要从头开始熟悉.这次通过做一个 ...
- ModelForm操作
ModelForm a. class Meta: model, # 对应Model的 fields=None, # 字段 exclude=None, # 排除字段 labels=None, # 提示信 ...
- nodeJS打包安装和问题处理
一,执行步骤,打包报错 1,查看npm版本npm -v 2,查看gulp版本(报错怎么证明没安装)gulp --version 3,安装gulpnpm install --global gulp-cl ...
- 仿scikit-learn模式写的kNN算法
一.什么是kNN算法 k邻近是指每个样本都可以用它最接近的k个邻居来代表. 核心思想:如果一个样本在特征空间中的k个最相邻的样本中大多数属于一个某类别,则该样本也属于这个类别. 二.将kNN封装成kN ...
- ffmpeg使用分析视频
https://www.cnblogs.com/Finley/p/8646711.html 先存下
- ascii 八进制
int main() 4 { 5 char buf[20] = {'\101','\102','\103',0}; 6 printf("%s",buf); 7 return 0; ...