
科普Spark,Spark核心是什么,如何使用Spark(1)
科普Spark,Spark是什么,如何使用Spark(1)转自:http://www.aboutyun.com/thread-6849-1-1.html
阅读本文章可以带着下面问题:
1.Spark基于什么算法的分布式计算(很简单)
2.Spark与MapReduce不同在什么地方
3.Spark为什么比Hadoop灵活
4.Spark局限是什么
5.什么情况下适合使用Spark
科普Spark,Spark核心是什么,如何使用Spark(2)转自:http://www.aboutyun.com/thread-6850-1-1.html
本篇文章很重要,也是spark为什么是Spark原因:
1.Spark的核心是什么?
2.RDD在内存不足时,是怎么处理的?
3.如何创建RDD,有几种方式
4.Spark编程支持几种语言
5.是否能够写出一个Driver程序
什么是Spark
Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出和结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的map reduce的算法。其架构如下图所示:
<ignore_js_op>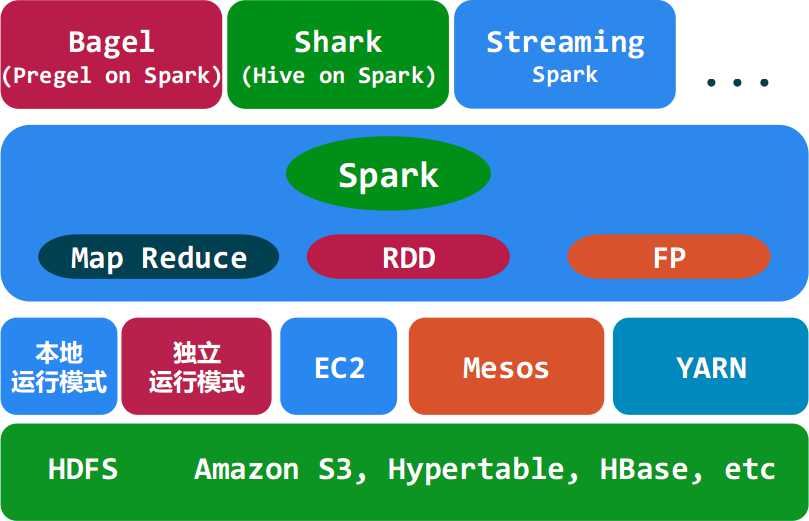
Spark与Hadoop的对比
- Spark的中间数据放到内存中,对于迭代运算效率更高。
Spark更适合于迭代运算比较多的ML和DM运算。因为在Spark里面,有RDD的抽象概念。
- Spark比Hadoop更通用
Spark提供的数据集操作类型有很多种,不像Hadoop只提供了Map和Reduce两种操作。比如map, filter, flatMap, sample, groupByKey, reduceByKey, union, join, cogroup, mapValues, sort,partionBy等多种操作类型,Spark把这些操作称为Transformations。同时还提供Count, collect, reduce, lookup, save等多种actions操作。
这些多种多样的数据集操作类型,给给开发上层应用的用户提供了方便。各个处理节点之间的通信模型不再像Hadoop那样就是唯一的Data Shuffle一种模式。用户可以命名,物化,控制中间结果的存储、分区等。可以说编程模型比Hadoop更灵活。
不过由于RDD的特性,Spark不适用那种异步细粒度更新状态的应用,例如web服务的存储或者是增量的web爬虫和索引。就是对于那种增量修改的应用模型不适合。
- 容错性。
在分布式数据集计算时通过checkpoint来实现容错,而checkpoint有两种方式,一个是checkpoint data,一个是logging the updates。用户可以控制采用哪种方式来实现容错。
- 可用性。
Spark通过提供丰富的Scala, Java,Python API及交互式Shell来提高可用性。
Spark与Hadoop的结合
Spark可以直接对HDFS进行数据的读写,同样支持Spark on YARN。Spark可以与MapReduce运行于同集群中,共享存储资源与计算,数据仓库Shark实现上借用Hive,几乎与Hive完全兼容。
Spark的适用场景
Spark是基于内存的迭代计算框架,适用于需要多次操作特定数据集的应用场合。需要反复操作的次数越多,所需读取的数据量越大,受益越大,数据量小但是计算密集度较大的场合,受益就相对较小(大数据库架构中这是是否考虑使用Spark的重要因素)
由于RDD的特性,Spark不适用那种异步细粒度更新状态的应用,例如web服务的存储或者是增量的web爬虫和索引。就是对于那种增量修改的应用模型不适合。
总的来说Spark的适用面比较广泛且比较通用。
运行模式
本地模式
Standalone模式
Mesoes模式
yarn模式
Spark生态系统
Shark ( Hive on Spark): Shark基本上就是在Spark的框架基础上提供和Hive一样的H iveQL命令接口,为了最大程度的保持和Hive的兼容性,Shark使用了Hive的API来实现query Parsing和 Logic Plan generation,最后的PhysicalPlan execution阶段用Spark代替Hadoop MapReduce。通过配置Shark参数,Shark可以自动在内存中缓存特定的RDD,实现数据重用,进而加快特定数据集的检索。同时,Shark通过UDF用户自定义函数实现特定的数据分析学习算法,使得SQL数据查询和运算分析能结合在一起,最大化RDD的重复使用。
Spark streaming: 构建在Spark上处理Stream数据的框架,基本的原理是将Stream数据分成小的时间片断(几秒),以类似batch批量处理的方式来处理这小部分数据。Spark Streaming构建在Spark上,一方面是因为Spark的低延迟执行引擎(100ms+)可以用于实时计算,另一方面相比基于Record的其它处理框架(如Storm),RDD数据集更容易做高效的容错处理。此外小批量处理的方式使得它可以同时兼容批量和实时数据处理的逻辑和算法。方便了一些需要历史数据和实时数据联合分析的特定应用场合。
Bagel: Pregel on Spark,可以用Spark进行图计算,这是个非常有用的小项目。Bagel自带了一个例子,实现了Google的PageRank算法。
下一篇:问题:
1.Spark的核心是什么?
2.RDD在内存不足时,是怎么处理的?
3.如何创建RDD,有几种方式
4.Spark编程支持几种语言
5.是否能够写出一个Driver程序
科普Spark,Spark核心是什么,如何使用Spark(2)
科普Spark,Spark核心是什么,如何使用Spark(1)的更多相关文章
- Spark的核心RDD(Resilient Distributed Datasets弹性分布式数据集)
Spark的核心RDD (Resilient Distributed Datasets弹性分布式数据集) 原文链接:http://www.cnblogs.com/yjd_hycf_space/p/7 ...
- spark 源码分析之十八 -- Spark存储体系剖析
本篇文章主要剖析BlockManager相关的类以及总结Spark底层存储体系. 总述 先看 BlockManager相关类之间的关系如下: 我们从NettyRpcEnv 开始,做一下简单说明. Ne ...
- 《深入理解Spark:核心思想与源码分析》——SparkContext的初始化(叔篇)——TaskScheduler的启动
<深入理解Spark:核心思想与源码分析>一书前言的内容请看链接<深入理解SPARK:核心思想与源码分析>一书正式出版上市 <深入理解Spark:核心思想与源码分析> ...
- 《深入理解Spark:核心思想与源码分析》(前言及第1章)
自己牺牲了7个月的周末和下班空闲时间,通过研究Spark源码和原理,总结整理的<深入理解Spark:核心思想与源码分析>一书现在已经正式出版上市,目前亚马逊.京东.当当.天猫等网站均有销售 ...
- 《深入理解Spark:核心思想与源码分析》(第2章)
<深入理解Spark:核心思想与源码分析>一书前言的内容请看链接<深入理解SPARK:核心思想与源码分析>一书正式出版上市 <深入理解Spark:核心思想与源码分析> ...
- 《深入理解Spark:核心思想与源码分析》一书正式出版上市
自己牺牲了7个月的周末和下班空闲时间,通过研究Spark源码和原理,总结整理的<深入理解Spark:核心思想与源码分析>一书现在已经正式出版上市,目前亚马逊.京东.当当.天猫等网站均有销售 ...
- 《深入理解Spark:核心思想与源码分析》正式出版上市
自己牺牲了7个月的周末和下班空闲时间,通过研究Spark源码和原理,总结整理的<深入理解Spark:核心思想与源码分析>一书现在已经正式出版上市,目前亚马逊.京东.当当.天猫等网站均有销售 ...
- Spark 以及 spark streaming 核心原理及实践
收录待用,修改转载已取得腾讯云授权 作者 | 蒋专 蒋专,现CDG事业群社交与效果广告部微信广告中心业务逻辑组员工,负责广告系统后台开发,2012年上海同济大学软件学院本科毕业,曾在百度凤巢工作三年, ...
- Spark系列-核心概念
Spark系列-初体验(数据准备篇) Spark系列-核心概念 一. Spark核心概念 Master,也就是架构图中的Cluster Manager.Spark的Master和Workder节点分别 ...
- Spark Streaming核心概念与编程
Spark Streaming核心概念与编程 1. 核心概念 StreamingContext Create StreamingContext import org.apache.spark._ im ...
随机推荐
- OAF_OAF OAWebBean和OAPageContext的分析(概念)
2015-04-03 Created By BaoXinjian
- 五种I/O模型和select函数简介
一.五种I/O模型 1.阻塞I/O 我们在前面所说的I/O模型都是阻塞I/O,即调用recv系统调用,如果没有数据则阻塞等待,当数据到来则将数据从内核空间(套接口缓冲区)拷贝到用户空间(recv函数提 ...
- add printer driver error 1802修复说明
1.重启电脑后 ,将服务"Print Spooler"服务重新启动2.srclient.dll文件拷贝到c盘 windows/system32目录下3.连接好打印机USB接口,重装 ...
- python标准库介绍——28 sha 模块详解
==sha 模块== ``sha`` 模块提供了计算信息摘要(密文)的另种方法, 如 [Example 2-39 #eg-2-39] 所示. 它与 ``md5`` 模块类似, 但生成的是 160 位签 ...
- DOA——ESPRIT算法
相位phei = 2*pi*f*d*sind(theta),因此理论上来讲测向的算法都可以用来测频. ESPRIT:Estimating signal parameters viarotational ...
- unity, 延迟执行代码
使用协程实现比较方便,可以带参数. void Start(){ StartCoroutine(delayLaunchRocket(rocket,2.0f)); } IEnumerator delayL ...
- NGUI ScrollView出屏幕再回来坐标混乱解决
主要是子节点没更新.乍一看调用UIPanel的Refresh()会管用,其实不然. 解决方法调用UIPanel的Invalidate让他所有子节点更新. panel.Invalidate(true);
- 【Android】20.3 拍照和视频录制
分类:C#.Android.VS2015: 创建日期:2016-03-13 一.简介 Android提供的Camera有两个典型的版本,一个是在Android 5.0以前提供的,称为Camera:另一 ...
- C++ 容器类 vector使用
vector(向量): C++中的一种数据结构,确切的说是一个类.它相当于一个动态的数组,当程序员无法知道自己需要的数组的规模多大时,用其来解决问题可以达到最大节约空间的目的. 用法: 1.文件包含: ...
- 关于Solr6.0中solrj使用简单例子
solr6.0的solrJ接口有部分变化,下面列出了简单的使用实例,有需要的朋友可以参考下. package com.ailk.solr6; import java.io.IOException; i ...