
Python爬虫教程-02-使用urlopen
Spider-02-使用urlopen
做一个最简单的python爬虫,使用爬虫爬取:智联招聘某招聘信息的DOM
urllib
- 包含模块
- urllib.request:打开和读取urls
- urllib.error:包含urllib.request产生的常见错误,使用try捕捉
- urllib.parse:包含解析url的方法
- urllib.robotparse:解析robots.txt文件
robots:机器人协议,放在网站的开头,供给爬虫读取,当爬虫读到robots之后,就知道那些是允许爬取的数据,哪些是禁止爬取的数据
(爬虫道德问题:1.不许过频繁爬取 2.不许爬取禁止内容) - 案例v1 (使用PyCharm开发工具,配置python解释器,创建python文件)
- 我把代码放在github了,可以直接下载,地址:
- py01v1.py文件:https://xpwi.github.io/py/py爬虫/py01v1.py
- request.py文档文件:https://xpwi.github.io/py/py爬虫/request.py
   # py01v1.py

   from urllib import request

   # 使用urllib.request请求一个网页的内容,并把内容打印出来

   if __name__ == '__main__':

       # 定义需要爬的页面

       url = "https://jobs.zhaopin.com/CC375882789J00033399409.htm"

       # 打开相应url并把页面作为返回

       rsp = request.urlopen(url)

       # 按住Ctrl键不送,同时点击urlopen,可以查看文档,有函数的具体参数和使用方法

       # 把返回结果读取出来

       html = rsp.read()

       print(html)
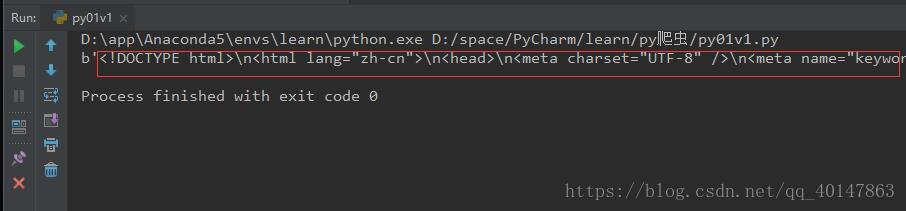
上面简单几行代码就可以爬取页面的HTML代码了
右键运行,截图如下
但是,我们爬取到的代码是不能自行显示中文的,需要解码处理
py02v1.py文件:https://xpwi.github.io/py/py爬虫/py02v1.py
   # py02v1.py

   from urllib import request

   if __name__ == '__main__':

       url = "https://jobs.zhaopin.com/CC375882789J00033399409.htm"

       rsp = request.urlopen(url)

       # 按住Ctrl键不送,同时点击urlopen,可以查看文档,有函数的具体参数和使用方法

       html = rsp.read()

       # 解码

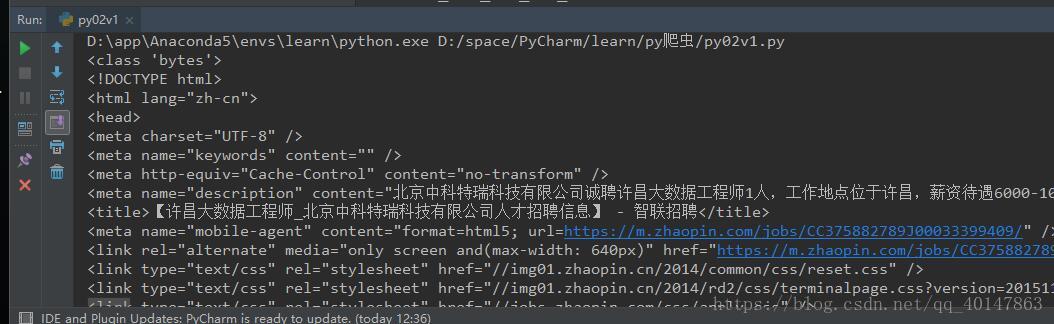
       html = html.decode()

       print(html)
解码后效果:
恭喜你,最简单的爬虫就已经学会啦!
如果运行失败,可能是
1.【爬取的连接失效】,更换最新的地址就可以了
2.【Python环境问题】,这里不做仔细介绍,请自行【百度】解决,也可联系博主
QQ:1370911284
微信:18322295195
更多文章链接:Python 爬虫随笔
- 本笔记学习于图灵学院python全栈课程
- 本笔记不允许任何个人和组织转载
Python爬虫教程-02-使用urlopen的更多相关文章
- Python爬虫教程-01-爬虫介绍
Spider-01-爬虫介绍 Python 爬虫的知识量不是特别大,但是需要不停和网页打交道,每个网页情况都有所差异,所以对应变能力有些要求 爬虫准备工作 参考资料 精通Python爬虫框架Scrap ...
- Python爬虫教程-00-写在前面
鉴于好多人想学Python爬虫,缺没有简单易学的教程,我将在CSDN和大家分享Python爬虫的学习笔记,不定期更新 基础要求 Python 基础知识 Python 的基础知识,大家可以去菜鸟教程进行 ...
- Python爬虫教程-11-proxy代理IP,隐藏地址(猫眼电影)
Python爬虫教程-11-proxy代理IP,隐藏地址(猫眼电影) ProxyHandler处理(代理服务器),使用代理IP,是爬虫的常用手段,通常使用UserAgent 伪装浏览器爬取仍然可能被网 ...
- Python爬虫教程-10-UserAgent和常见浏览器UA值
Python爬虫教程-10-UserAgent和常见浏览器UA值 有时候使用爬虫会被网站封了IP,所以需要去模拟浏览器,隐藏用户身份, UserAgent 包含浏览器信息,用户身份,设备系统信息 Us ...
- Python爬虫教程-09-error 模块
Python爬虫教程-09-error模块 今天的主角是error,爬取的时候,很容易出现错,所以我们要在代码里做一些,常见错误的处,关于urllib.error URLError URLError ...
- Python爬虫教程-08-post介绍(百度翻译)(下)
Python爬虫教程-08-post介绍(下) 为了更多的设置请求信息,单纯的通过urlopen已经不太能满足需求,此时需要使用request.Request类 构造Request 实例 req = ...
- Python爬虫教程-07-post介绍(百度翻译)(上)
Python爬虫教程-07-post介绍(百度翻译)(上) 访问网络两种方法 get: 利用参数给服务器传递信息 参数为dict,使用parse编码 post :(今天给大家介绍的post) 一般向服 ...
- Python爬虫教程-25-数据提取-BeautifulSoup4(三)
Python爬虫教程-25-数据提取-BeautifulSoup4(三) 本篇介绍 BeautifulSoup 中的 css 选择器 css 选择器 使用 soup.select 返回一个列表 通过标 ...
- Python爬虫教程-24-数据提取-BeautifulSoup4(二)
Python爬虫教程-24-数据提取-BeautifulSoup4(二) 本篇介绍 bs 如何遍历一个文档对象 遍历文档对象 contents:tag 的子节点以列表的方式输出 children:子节 ...
随机推荐
- Maven自动FTP远程部署
参照官网文档: https://maven.apache.org/plugins/maven-deploy-plugin/examples/deploy-ftp.html 1.在pom.xml中加入: ...
- BZOJ - 2500 树形DP乱搞
题意:给出一棵树,两个给给的人在第\(i\)天会从节点\(i\)沿着最长路径走,求最长的连续天数\([L,R]\)使得\([L,R]\)为起点的最长路径极差不超过m 求\(1\)到\(n\)的最长路经 ...
- C# 字符串类型介绍与操作
一.关于字符串操作的方法 System.String类提供了很多工具方法,包括返回字符数据长度,查找当前字符串中的子字符串和转换大小写等方法. 在String类中常用的比较字符串的方法主要有Compa ...
- Fiddler配置
用fiddler来抓取手机app测试包的数据很方面,配置时需要注意一下几点: 1.保证电脑的防火墙是关闭的,不然是会抓不到包的: 2.查看下fiddler的默认端口8888是否被占用,如果被占用了,那 ...
- Linux下Tomcat8.0.44配置使用Apr
听说Apr可以提高tomcat很多的性能,配置具体如下 1.安装apr 1.5.2 [root@ecs-3c46 ]# cd /usr/local/src [root@ecs-3c46 src]# w ...
- Java接口的简单理解和总结
1.抽象层次:普通类 -> 抽象类 -> 接口 普通类:就是我们常用的类: 抽象类:专门用来被子类继承的,主要是为了符合现实世界的规律 如: Animal类:(每个现实的对象都有类与它相对 ...
- 64位使用windbg获取Shadow SSDT
首先选择一个带界面的程序explorer.exe进行附加 kd> !process explorer.exe PROCESS ffff86893dd075c0 SessionId: Cid: 0 ...
- free 和 delete 把指针怎么了
使用free或delete之后,只是把指针所指的内容给释放掉,但是指针并没有被干掉,还是指向原来位置(并不是执行NULL),此时指针指向的内容为垃圾,被称为“野指针”. 举例说明几个重要容易迷糊的特征 ...
- vue 实战问题-watch 数组或者对象
1.普通的watch data() { return { frontPoints: 0 } }, watch: { frontPoints(newValue, oldValue) { console. ...
- 使用 Python 编写脚本并发布
使用 Python 编写脚本并发布 P1: 脚本 通常在 Linux 服务器上会遇到在命令行中输入命令的操作,而有些操作包含的命令数目较多或者其中的命令包含的参数较多,如果一个一个的敲命令的话就太麻烦 ...