
Kafka学习(一)
链接:https://www.zhihu.com/question/53331259/answer/1321992772
来源:知乎
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
Kafka是最初由Linkedin公司开发,是一个分布式、支持分区的、多副本的,基于zookeeper协调的分布式消息系统。
它最大的特性就是可以实时处理大量数据以满足各种需求场景:比如基于hadoop的批处理系统、低延迟的实时系统、storm/Spark流式处理引擎,web/nginx日志、访问日志、消息服务等等。
Linkedin于2010年贡献给了Apache基金会并成为顶级开源项目。
01 kafka的定义和特征
Kafka是一个分布式的基于发布/订阅模式的消息队列,主要用来解决应用解耦、异步消息、流量削峰等问题。
3个特点:
- 类似消息系统,提供事件流的发布和订阅,即具备数据注入功能
- 存储事件流数据的节点具有故障容错的特点,即具备数据存储功能
- 能够对实时的事件流进行流式地处理和分析,即具备流处理功能
02 Kafka的架构
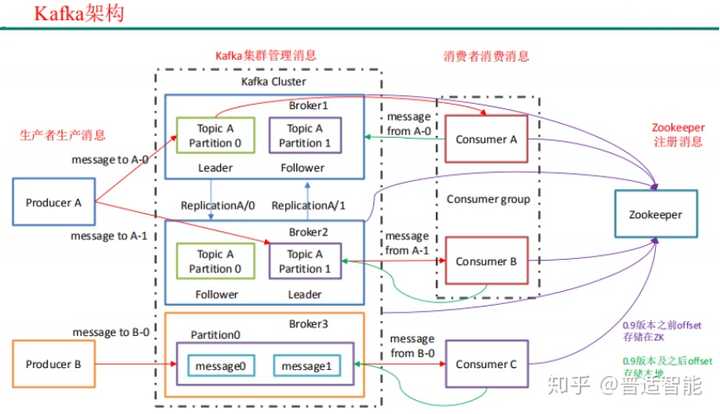
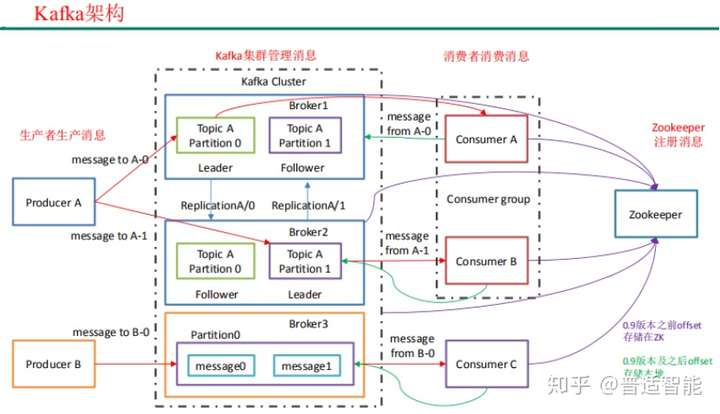
- Producer:消息生产者,就是向 kafka broker 发消息的客户端
- Consumer:消息消费者,就是向 kafka broker 取消息的客户端
- Broker :一台 kafka 服务器就是一个 broker。一个集群由多个 broke 组成。一个 broker 可以容纳多个 topic
- Consumer Group (CG):消费者组,由多个 consumer 组成。消费者组内每个消费者负责消费不同分区的数据,一个分区只能由一个组内消费者消费;消费者组之间互不影响
- Topic :可以理解为一个队列,生产者和消费者面向的都是一个 topic
- Partition:为了实现扩展性,一个非常大的 topic 可以分布到多个 broker(即服务 器)上,一个 topic 可以分为多个 partition,每个 partition 是一个有序的队列
- Replica:副本,为保证集群中的某个节点发生故障时,该节点上的 partition 数据 不丢失,且 kafka 仍然能够继续工作,kafka 提供了副本机制,一个 topic 的每个分区都有若干个副本, 一个 leader 和若干个 follower
- leader:每个分区多个副本的“主”,生产者发送数据的对象,以及消费者消费数 据的对象都是 leader
- follower:每个分区多个副本中的“从”,实时从 leader 中同步数据,保持和 leader数据 的同步。leader 发生故障时,某个 follower 会成为新的 follower
03 生产者
(1) 数据可靠性保证
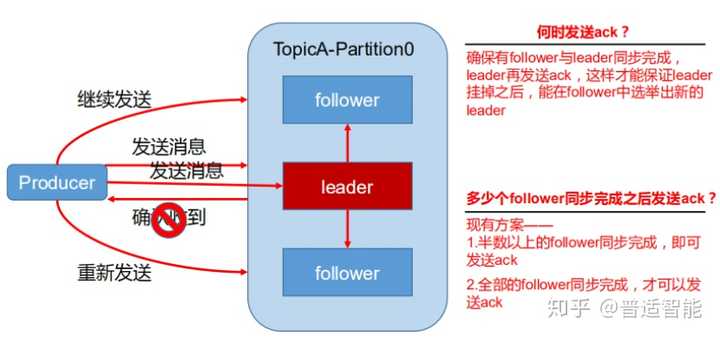
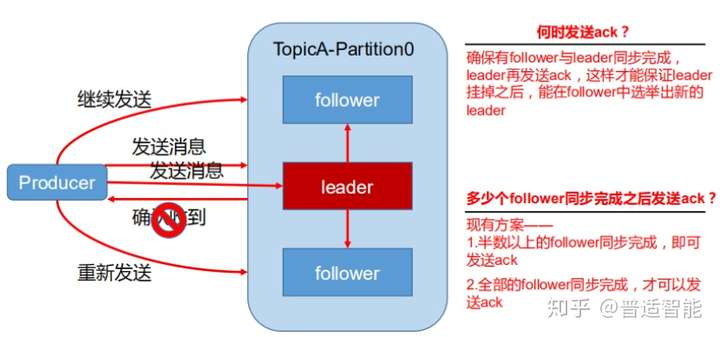
为保证 producer 发送的数据,能可靠的发送到指定的 topic,topic的每个 partition收到 producer发送的数据后,都需要向 producer发送ack(acknowledgement确认收到),如果 producer收到 ack,就会进行下一轮的发送,否则重新发送数据。
(2) Ack应答机制
- Ack=0:producer 不等待 broker 的 ack,这一操作提供了一个最低的延迟,broker 一接收到还没有写入磁盘就已经返回,当 broker 故障时有可能丢失数据
- Ack=1:producer 等待 broker 的 ack,partition 的 leader 落盘成功后返回 ack,如果在 follower 同步成功之前 leader 故障,那么将会丢失数据
- Ack=-1:producer 等待 broker 的 ack,partition 的 leader 和 follower 全部落 盘成功后才 返回 ack。但是如果在 follower 同步完成后,broker 发送 ack 之前,leader 发生故障,那么会造成数据重复
(3) 故障处理
- follower 故障
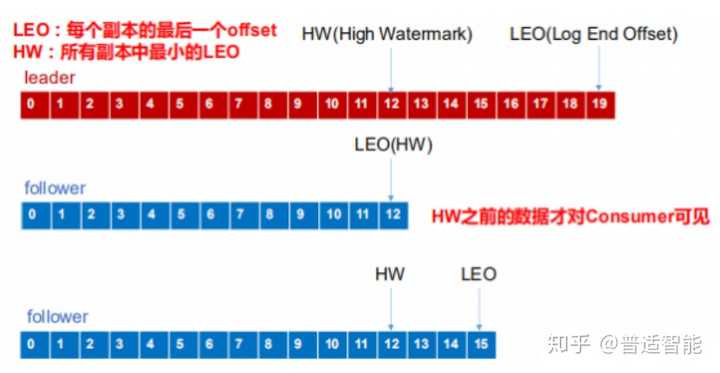
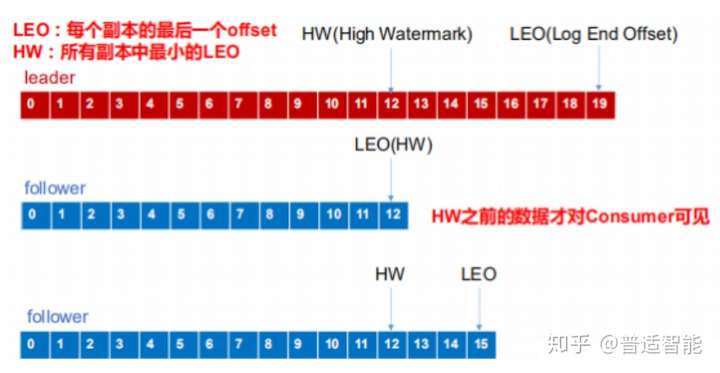
follower发生故障后会被临时踢出ISR,待该follower 恢复后,follower会读取本地磁盘 记录的上次的HW,并将log文件高于HW的部分截取掉,从HW开始向leader进行同步。
等该follower的LEO大于等于该Partition的HW,即 follower 追上 leader 之后,就可以重新加入ISR 了。
- leader 故障
leader发生故障之后,会从ISR中选出一个新的leader,之后,为保证多个副本之间的数据一致性,其余的follower会先将各自的log文件高于HW的部分截掉,然后从新的leader同步数据。
04 消费者
(1) 消费方式
consumer 采用 pull(拉) 模式从 broker 中读取数据。push(推)模式很难适应消费速率不同的消费者,因为消息发送速率是由 broker 决定的。
它的目标是尽可能以最快速度传递消息,但是这样很容易造成 consumer 来不及处理消息,典型的表现就是拒绝服务以及网络拥塞。
而 pull 模式则可以根据 consumer 的消费能力以适当的速率消费消息。pull 模式不足之处是,如果 kafka 没有数据,消费者可能会陷入循环中,一直返回空数据。
针对这一点,Kafka的消费者在消费数据时会传入一个时长参数timeout,如果当前没有数据可供消费,consumer 会等待一段时间之后再返回,这段时长即为 timeout。(2) Offset的维护
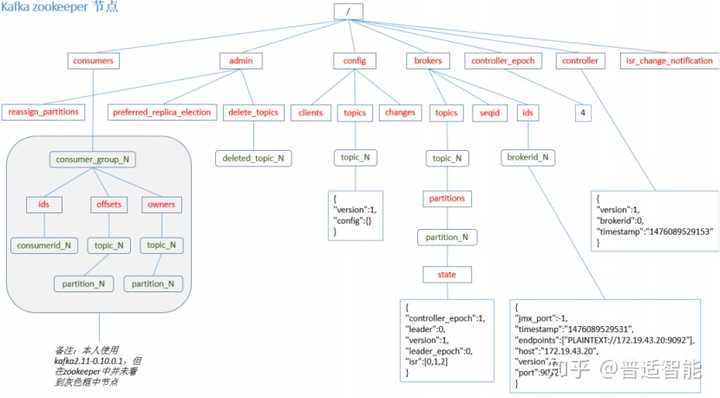
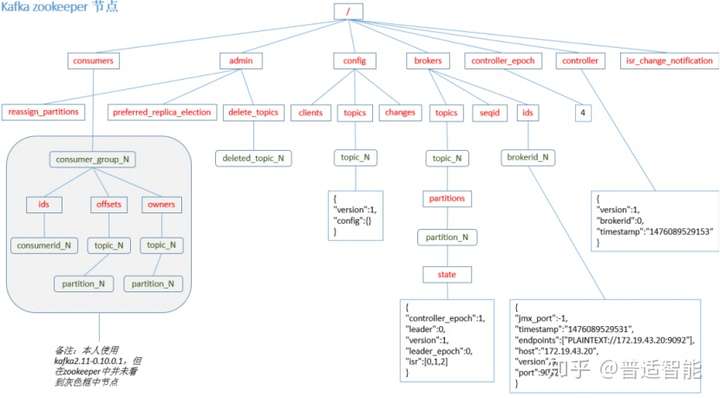
由于consumer在消费过程中可能会出现断电宕机等故障,consumer恢复后,需要从故障前的位置的继续消费,所以consumer需要实时记录自己消费到了哪个offset,以便故障恢复后继续消费。
Kafka 0.9版本之前,consumer默认将offset保存在Zookeeper中,从0.9版本开始,consumer默认将offset保存在Kafka一个内置的topic中,该topic为__consumer_offsets。
总结:
Kafka是一个分布式、支持分区的、多副本的,基于zookeeper协调的分布式消息系统,是当前大数据解决方案的标配,广泛用于大数据框架间的数据发布和订阅,所以深入理解Kafka内部机制就非常必要。 - 完 -
Kafka学习(一)的更多相关文章
- kafka学习笔记:知识点整理
一.为什么需要消息系统 1.解耦: 允许你独立的扩展或修改两边的处理过程,只要确保它们遵守同样的接口约束. 2.冗余: 消息队列把数据进行持久化直到它们已经被完全处理,通过这一方式规避了数据丢失风险. ...
- Kafka学习-简介
Kafka是由LinkedIn开发的一个分布式的消息系统,使用Scala编写,它以可水平扩展和高吞吐率而被广泛使用.目前越来越多的开源分布式处理系统如Cloudera.Apache Storm.S ...
- Kafka学习-入门
在上一篇kafka简介的基础之上,本篇主要介绍如何快速的运行kafka. 在进行如下配置前,首先要启动Zookeeper. 配置单机kafka 1.进入kafka解压目录 2.启动kafka bin\ ...
- Kafka学习之路
一直在思考写一些什么东西作为2017年开篇博客.突然看到一篇<Kafka学习之路>的博文,觉得十分应景,于是决定搬来这“他山之石”.虽然对于Kafka博客我一向坚持原创,不过这篇来自Con ...
- kafka学习2:kafka集群安装与配置
在前一篇:kafka学习1:kafka安装 中,我们安装了单机版的Kafka,而在实际应用中,不可能是单机版的应用,必定是以集群的方式出现.本篇介绍Kafka集群的安装过程: 一.准备工作 1.开通Z ...
- [Big Data - Kafka] kafka学习笔记:知识点整理
一.为什么需要消息系统 1.解耦: 允许你独立的扩展或修改两边的处理过程,只要确保它们遵守同样的接口约束. 2.冗余: 消息队列把数据进行持久化直到它们已经被完全处理,通过这一方式规避了数据丢失风险. ...
- kafka 学习资料
kafka 学习资料 kafka 学习资料 网址 kafka 中文教程 http://orchome.com/kafka/index
- 【译】Kafka学习之路
一直在思考写一些什么东西作为2017年开篇博客.突然看到一篇<Kafka学习之路>的博文,觉得十分应景,于是决定搬来这“他山之石”.虽然对于Kafka博客我一向坚持原创,不过这篇来自Con ...
- Kafka学习之(六)搭建kafka集群
想要搭建kafka集群,必须具备zookeeper集群,关于zookeeper集群的搭建,在Kafka学习之(五)搭建kafka集群之Zookeeper集群搭建博客有说明.需要具备两台以上装有zook ...
- Kafka学习总结
Kafka学习总结 参考资料: 1.http://kafka.apachecn.org/, kafka官方文档 2.https://www.cnblogs.com/likehua/p/3999538. ...
随机推荐
- Spring Boot部署之 web项目war包运行
传统的部署方式:将项目打成war包,放入tomcat 的webapps目录下面,启动tomcat,即可访问. 具体打war包流程: 1.pom.xml配置文件修改: 2.改造启动类,如果是war包发布 ...
- Spring Cloud Alibaba Nacos 的 2 种健康检查机制!
Spring Cloud Alibaba Nacos 作为注册中心不止提供了服务注册和服务发现功能,它还提供了服务可用性监测的机制.有了此机制之后,Nacos 才能感知服务的健康状态,从而为服务调用者 ...
- Elasticsearch 第九篇:集群配置与搭建
h2.post_title { background-color: rgba(43, 102, 149, 1); color: rgba(255, 255, 255, 1); font-size: 1 ...
- 记一次payload绕过电脑管家免杀
一.msf命令提示符下generate命令生成1.首先可以使用show payloads命令查看所有的payload,然后使用use命令选中其中一个. 2.使用generate -h查看命令帮助 ge ...
- 从数据分析系统总架构理解BI工具的价值所在
现如今,应用商业智能BI工具的企业是越来越多了,由此也可见企业对数据分析的重视.因此,掌握一定的数据分析知识对"打工人"来说是非常重要的.现在小编就来跟大家一起来了解一下商业智能 ...
- prometheus k8s服务发现
Prometheus的服务发现在解决什么问题? 被监控的目标(target)是整个监控体系中重要组成部分,传统监控系统zabbix通过 网络发现的机制自动创建主机到zabbix-server,进而快速 ...
- Linux性能优化实战CPU篇之总结(四)
一.分析CPU瓶颈 1,性能指标 a>CPU使用率 CPU使用率描述了非空闲时间占总CPU时间的百分比,根据CPU上运行任务的不同可以分为:用户CPU.系统CPU.等待I/O CPU.软中断和硬 ...
- 企业环境下用脚本设置ubuntu防火墙
ubuntu防火墙设置 初始状态下直接设置即可,尽量不要尝试 重装 iptables 以及ufw,很容易导致 防火墙崩掉,最后可能只能重装系统. 配置脚本 firewall.sh #/bin/bash ...
- starter
传统的 Spring 项目想要运行,不仅需要导入各种依赖,还要对各种 XML 配置文件进行配置,十分繁琐,但 Spring Boot 项目在创建完成后,即使不编写任何代码,不进行任何配置也能够直接运行 ...
- Shell脚本编写登陆小程序.sh
转至:https://www.cnblogs.com/gaohongyu/articles/12072594.html #!/bin/bash #Author:GaoHongYu #QQ:106176 ...