
大数据之路week07--day07 (Sqoop 从mysql增量导入到HDFS)
我们之前导入的都是全量导入,一次性全部导入,但是实际开发并不是这样,例如web端进行用户注册,mysql就增加了一条数据,但是HDFS中的数据并没有进行更新,但是又再全部导入一次又完全没有必要。
所以,sqoop提供了增量导入的方法。
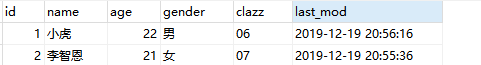
1、数据准备:
2、将其先用全量导入到HDFS中去
3、先在mysql中添加一条数据,在使用命令进行追加
 #指定字段的取值范围,增量到数据(指的是Mysql增加了一条或多条数据,追加到HDFS中去,

 如果想追加到hive本来的数据中去就把路径换成hive的路径)

 # 适用于表不断的有新数据插入

sqoop import \

--connect jdbc:mysql://master:3306/student \

--username root \

--password  \

--table student_zeng \

--target-dir /user/hive/warehouse/sqlhivetest.db/student_zeng/ \

--split-by id \

-m  \

--fields-terminated-by '\t' \

--incremental append \

--check-column id \

--last-value
4、根据时间进行大量追加(不去重)
 追加

 sqoop import \

 --connect jdbc:mysql://master:3306/student \

 --username root \

 --password  \

 --target-dir /user/hive/warehouse/sqlhivetest.db/student_zeng/ \

 --table student_zeng \

 --fields-terminated-by '\t' \

 --check-column last_mod \

 --incremental lastmodified \

 --last-value "2019-12-19 20:57:16" \

 -m  \

 --append
结果:但是我们发现有两个重复的字段
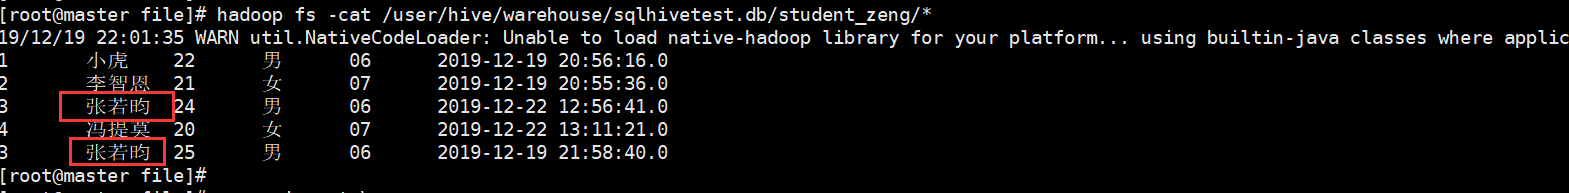
5、往往开发中需要进行去重操作:sqoop提供了一个方法进行去重,内部是先开一个map任务将数据导入进来,然后再开一个map任务根据指定的字段进行合并去重
#根据业务可能需要去重  -merge-key 就是做这个事

sqoop import \

--connect jdbc:mysql://master:3306/student \

--username root \

--password  \

--target-dir /user/hive/warehouse/sqlhivetest.db/student_zeng/ \

--table student_zeng \

--fields-terminated-by '\t' \

--check-column last_mod \

--incremental lastmodified \

--last-value "2019-12-19 22:00:09" \

-m  \

-merge-key id
结果:

之前有重复的也进行合并去重操作,最后生成一个结果。
大数据之路week07--day07 (Sqoop 从mysql增量导入到HDFS)的更多相关文章
- 大数据之路week07--day06 (Sqoop 的使用)
Sqoop的使用一(将数据库中的表数据上传到HDFS) 首先我们先准备数据 1.没有主键的数据(下面介绍有主键和没有主键的使用区别) -- MySQL dump 10.13 Distrib 5.1.7 ...
- 大数据之路week07--day06 (Sqoop 将关系数据库(oracle、mysql、postgresql等)数据与hadoop数据进行转换的工具)
为了方便后面的学习,在学习Hive的过程中先学习一个工具,那就是Sqoop,你会往后机会发现sqoop是我们在学习大数据框架的最简单的框架了. Sqoop是一个用来将Hadoop和关系型数据库中的数据 ...
- 大数据之路week07--day06 (Sqoop 在从HDFS中导出到关系型数据库时的一些问题)
问题一: 在上传过程中遇到这种问题: ERROR tool.ExportTool: Encountered IOException running export job: java.io.IOExce ...
- 大数据之路week07--day06 (Sqoop 的安装及配置)
Sqoop 的安装配置比较简单. 提供安装需要的安装包和连接mysql的驱动的百度云链接: 链接:https://pan.baidu.com/s/1pdFj0u2lZVFasgoSyhz-yQ 提取码 ...
- sqoop操作之Oracle导入到HDFS
导入表的所有字段 sqoop import --connect jdbc:oracle:thin:@192.168.1.100:1521:ORCL \ --username SCOTT --passw ...
- 大数据之路week06--day07(Hadoop生态圈的介绍)
Hadoop 基本概念 一.Hadoop出现的前提环境 随着数据量的增大带来了以下的问题 (1)如何存储大量的数据? (2)怎么处理这些数据? (3)怎样的高效的分析这些数据? (4)在数据增长的情况 ...
- 大数据之路week04--day06(I/O流阶段一 之异常)
从这节开始,进入对I/O流的系统学习,I/O流在往后大数据的学习道路上尤为重要!!!极为重要,必须要提起重视,它与集合,多线程,网络编程,可以说在往后学习或者是工作上,起到一个基石的作用,没了地基,房 ...
- 大数据框架开发基础之Sqoop(1) 入门
Sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql.postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle , ...
- C#码农的大数据之路 - 使用C#编写MR作业
系列目录 写在前面 从Hadoop出现至今,大数据几乎就是Java平台专属一般.虽然Hadoop或Spark也提供了接口可以与其他语言一起使用,但作为基于JVM运行的框架,Java系语言有着天生优势. ...
随机推荐
- eclipse 查看文件在磁盘里的位置
- RDB和AOF持久化
RDB和AOF持久化 https://www.cnblogs.com/Tu9oh0st/p/11229317.html Redis提供了不同的持久化选项: RDB持久化以指定的时间间隔保存那个时间点的 ...
- Linux安装卸载JDK完整步骤
1.检查一下系统中的jdk版本 [root@localhost software]# java -version 显示: openjdk version "1.8.0_102" O ...
- Linux 反弹 Shell
攻击场景 Attacker:192.168.0.106 win10 Victim:192.168.2.140 kali NC 反弹 shell Netcat简介 俗称瑞士军刀或NC,小巧强悍,可以读写 ...
- 【转帖】vim/sed/awk/grep等文件批处理总结
vim/sed/awk/grep等文件批处理总结 https://www.cnblogs.com/cangqiongbingchen/p/9760544.html Vim相关操作 1.基础 * 和 # ...
- Kafka-Docker:使用Docker运行Apache Kafka的步骤
1.目标 在这个Kafka教程中,我们将学习Kafka-Docker的概念.此外,我们将在Kafka中看到Docker的卸载过程.这包括使用Docker 运行Apache Kafka的所有步骤 .除 ...
- makefile从0到1
一.什么是makefile 百度百科:Linux 环境下的程序员如果不会使用GNU make来构建和管理自己的工程,应该不能算是一个合格的专业程序员,至少不能称得上是Unix程序员.在 Linux(u ...
- python三大器之装饰器的练习
装饰器 加载顺序从下至上 执行顺序从上至下 ''' 多层装饰器 ''' def deco1(func): #func=deco2 def wrapper1(*args, **kwargs): '''t ...
- 数据分析-numpy的用法
一.jupyter notebook 两种安装和启动的方式: 第一种方式: 命令行安装:pip install jupyter 启动:cmd 中输入 jupyter notebook 缺点:必须手动去 ...
- DNS欺诈的三种简单方法总结
使用arpspoof.ettercap以及driftnet的简单组合. ①arpsppof+driftnet arpspoof -i eth0 -t 目标ip 目标网关 driftnet -i eth ...