
大数据之路week07--day06 (Sqoop 在从HDFS中导出到关系型数据库时的一些问题)
问题一:
在上传过程中遇到这种问题:
ERROR tool.ExportTool: Encountered IOException running export job: java.io.IOException: No columns to generate for ClassWriter
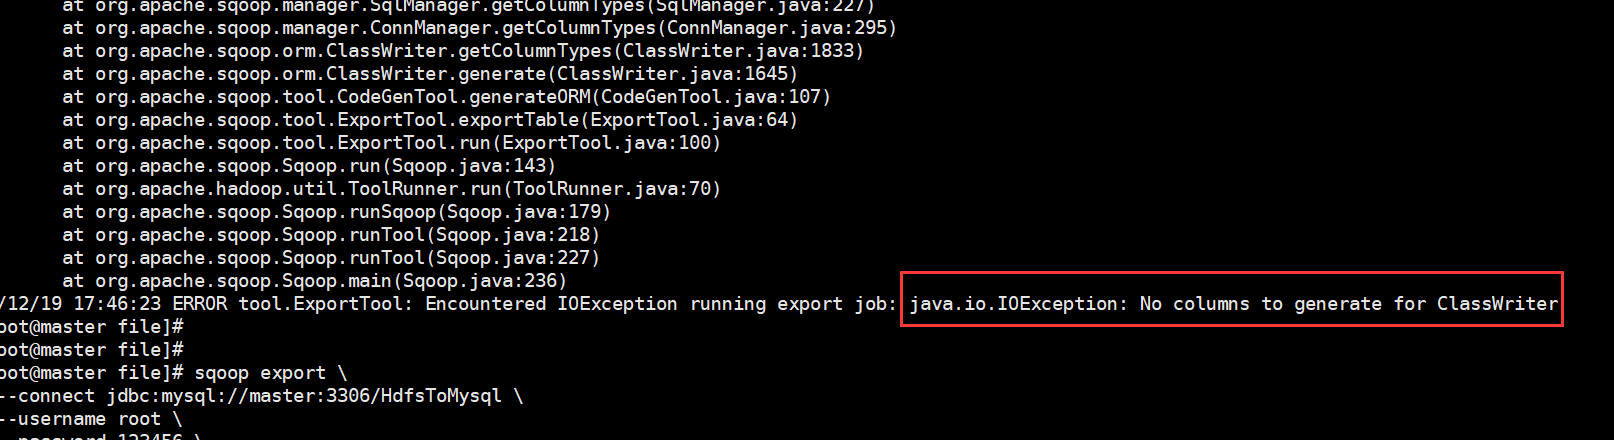
解决方式:
在网上搜索的时候很多博客说时驱动版本的过低导致的,其实在尝试这个方法的时候我们可以先进行这样:加一行命令,--driver com.mysql.jdbc.Driver \ 然后问题解决!!!
如果添加命令之后还没有解决就把jar包换成高点版本的。百度云链接:
链接:https://pan.baidu.com/s/1q-6O0ER-Vtc74ha_9DMbpQ
提取码:174n
问题二:
依旧是导出的时候,会报错,但是我们很神奇的发现,也有部分数据导入了。这也就是下一个问题。
Caused by: java.lang.NumberFormatException: For input string: "null"

解决方式:因为数据有存在null值得导致的
在命令中加入一行(方式一中的修改方式,方式二也就是转换一下格式):--input-null-string '\\N' \ 也有的博主说加两行,但是我加一行也可以,具体原因没有细查。
问腿三:
java.lang.RuntimeException: Can't parse input data: '1998/5/11'
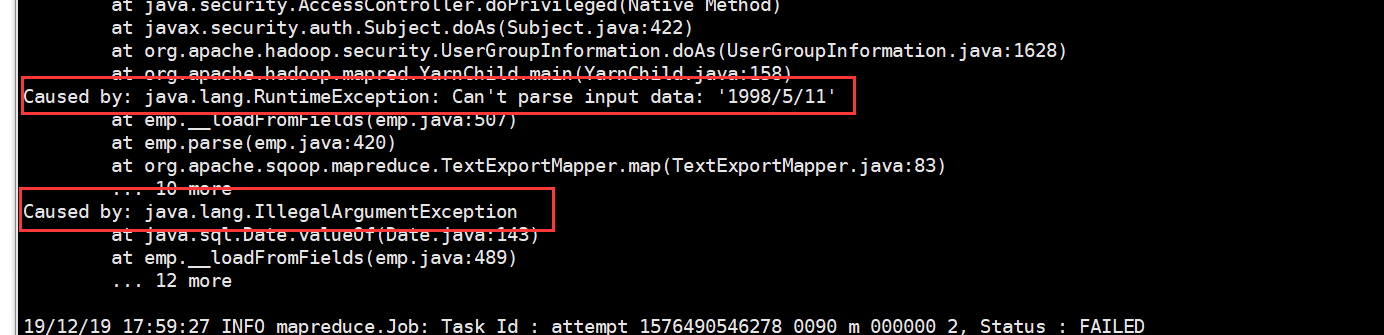
出现像这样的问题,大多是因为HDFS上的数据与关系型数据库创建表的字段类型不匹配导致的。仔细对比修改后,就不会有这个报错啦!!
当然,会发生的问题肯定不会是就这么点,主要靠平时的积累,修改,才能不断地成长。
注意: 千万不要犯像敲错字母,或者命令打错,空格少打这样的低级错误,这样会很耗时,唯一的解决办法,那就是,多加练习,勤敲。!!!
大数据之路week07--day06 (Sqoop 在从HDFS中导出到关系型数据库时的一些问题)的更多相关文章
- 大数据之路week07--day06 (Sqoop 的使用)
Sqoop的使用一(将数据库中的表数据上传到HDFS) 首先我们先准备数据 1.没有主键的数据(下面介绍有主键和没有主键的使用区别) -- MySQL dump 10.13 Distrib 5.1.7 ...
- 大数据之路week07--day06 (Sqoop 将关系数据库(oracle、mysql、postgresql等)数据与hadoop数据进行转换的工具)
为了方便后面的学习,在学习Hive的过程中先学习一个工具,那就是Sqoop,你会往后机会发现sqoop是我们在学习大数据框架的最简单的框架了. Sqoop是一个用来将Hadoop和关系型数据库中的数据 ...
- 大数据之路week07--day07 (Sqoop 从mysql增量导入到HDFS)
我们之前导入的都是全量导入,一次性全部导入,但是实际开发并不是这样,例如web端进行用户注册,mysql就增加了一条数据,但是HDFS中的数据并没有进行更新,但是又再全部导入一次又完全没有必要. 所以 ...
- 大数据之路week07--day06 (Sqoop 的安装及配置)
Sqoop 的安装配置比较简单. 提供安装需要的安装包和连接mysql的驱动的百度云链接: 链接:https://pan.baidu.com/s/1pdFj0u2lZVFasgoSyhz-yQ 提取码 ...
- 大数据框架开发基础之Sqoop(1) 入门
Sqoop是一款开源的工具,主要用于在Hadoop(Hive)与传统的数据库(mysql.postgresql...)间进行数据的传递,可以将一个关系型数据库(例如 : MySQL ,Oracle , ...
- 大数据之路week07--day05 (一个基于Hadoop的数据仓库建模工具之一 HIve)
什么是Hive? 我来一个短而精悍的总结(面试常问) 1:hive是基于hadoop的数据仓库建模工具之一(后面还有TEZ,Spark). 2:hive可以使用类sql方言,对存储在hdfs上的数据进 ...
- 大数据之路week07--day04 (YARN,Hadoop的优化,combline,join思想,)
hadoop 的计算特点:将计算任务向数据靠拢,而不是将数据向计算靠拢. 特点:数据本地化,减少网络io. 首先需要知道,hadoop数据本地化是指的map任务,reduce任务并不具备数据本地化特征 ...
- 大数据之路week06--day07(Hadoop生态圈的介绍)
Hadoop 基本概念 一.Hadoop出现的前提环境 随着数据量的增大带来了以下的问题 (1)如何存储大量的数据? (2)怎么处理这些数据? (3)怎样的高效的分析这些数据? (4)在数据增长的情况 ...
- 大数据之路week04--day06(I/O流阶段一 之异常)
从这节开始,进入对I/O流的系统学习,I/O流在往后大数据的学习道路上尤为重要!!!极为重要,必须要提起重视,它与集合,多线程,网络编程,可以说在往后学习或者是工作上,起到一个基石的作用,没了地基,房 ...
随机推荐
- swool教程链接汇总
参考地址: swoole教程第一节:进程管理模块(Process)-上 swoole教程第二节:基础的通讯实现-server篇-1 W3Cschool的swoole的系统教程 csdn网站swoole ...
- Ansible-Hoc--样例
一.常用场景 1. 列出支持的模块及模块功能说明: 2. sudo用法: 3. 检查服务器存活,复制本地文件到远程: 4. 多线程判断服务器的存活: 5. 显示所有主机的hostname: 6. 列 ...
- odoo 流水码 编码规则
<?xml version="1.0" encoding="utf-8"?> <odoo> <data noupdate=&quo ...
- .Net - 线程本地变量(存储)的使用
关于C#多线程的文章,大部分都在讨论线程的开始与停止或者是多线程同步问题.多线程同步就是在不同线程中访问同一个变量或共享资源,众所周知在不使用线程同步的机制下,由于竞争的存在会使某些线程产生脏读或者是 ...
- git pull时 git cannot lock ref XXXXXX (unable to update local ref)错误解决方案
git pull : git cannot lock ref XXXXXX (unable to update local ref) pull代码的时候出现的错误,导致代码拉不下来. 看了一下 ...
- 谷歌浏览器调试swoole长连接方法
谷歌浏览器调试swoole长连接方法network标签里面的ws 看frames
- mysql慢查询日记
mysql慢查询日记 <pre>#必须写到mysqld 注意给/tmp/showslowmysql.log 775权限 要写入权限[mysqld]#开启慢查询日记slow_query_lo ...
- Java多线程-同步:synchronized 和线程通信:生产者消费者模式
大家伙周末愉快,小乐又来给大家献上技术大餐.上次是说到了Java多线程的创建和状态|乐字节,接下来,我们再来接着说Java多线程-同步:synchronized 和线程通信:生产者消费者模式. 一.同 ...
- mysql 的日期和时间函数
执行函数方式 select 函数 函数名称 函 数 功 能 CURDATE() 获取当前日期 CURTIME() 获取当前时间 NOW() 获取当前的日期和时间 UNIX_TIMESTAMP ...
- 关于su下bash:xxx :command not found
今天在新建组的时候出了问题: $ su Password: # groupadd prj bash: groupadd :command not found 我就纳闷,明明是在su权限下,怎么还不能使 ...