
Ambari集群里操作时典型权限问题put: `/home/bigdata/1.txt': No such file or directory的解决方案(图文详解)
不多说,直接上干货!
问题详情
明明put该有的文件在,可是怎么提示的是文件找不到的错误呢?
我就纳闷了put: `/home/bigdata/1.txt': No such file or directory
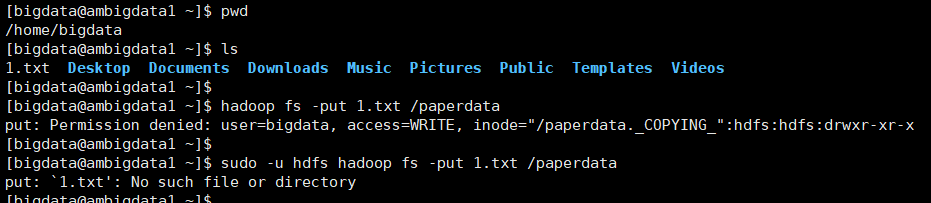
[bigdata@ambigdata1 ~]$ pwd

/home/bigdata

[bigdata@ambigdata1 ~]$ ls

.txt  Desktop  Documents  Downloads  Music  Pictures  Public  Templates  Videos

[bigdata@ambigdata1 ~]$

[bigdata@ambigdata1 ~]$ hadoop fs -put .txt /paperdata

put: Permission denied: user=bigdata, access=WRITE, inode="/paperdata._COPYING_":hdfs:hdfs:drwxr-xr-x

[bigdata@ambigdata1 ~]$

[bigdata@ambigdata1 ~]$ sudo -u hdfs hadoop fs -put .txt /paperdata

put: `.txt': No such file or directory

[bigdata@ambigdata1 ~]$
问题原因
其实是,权限的问题。
刚开始,我也纳闷,报没有文件错误,经过排查是权限问题,同时,在hdfs用户切换过来也得到了验证。
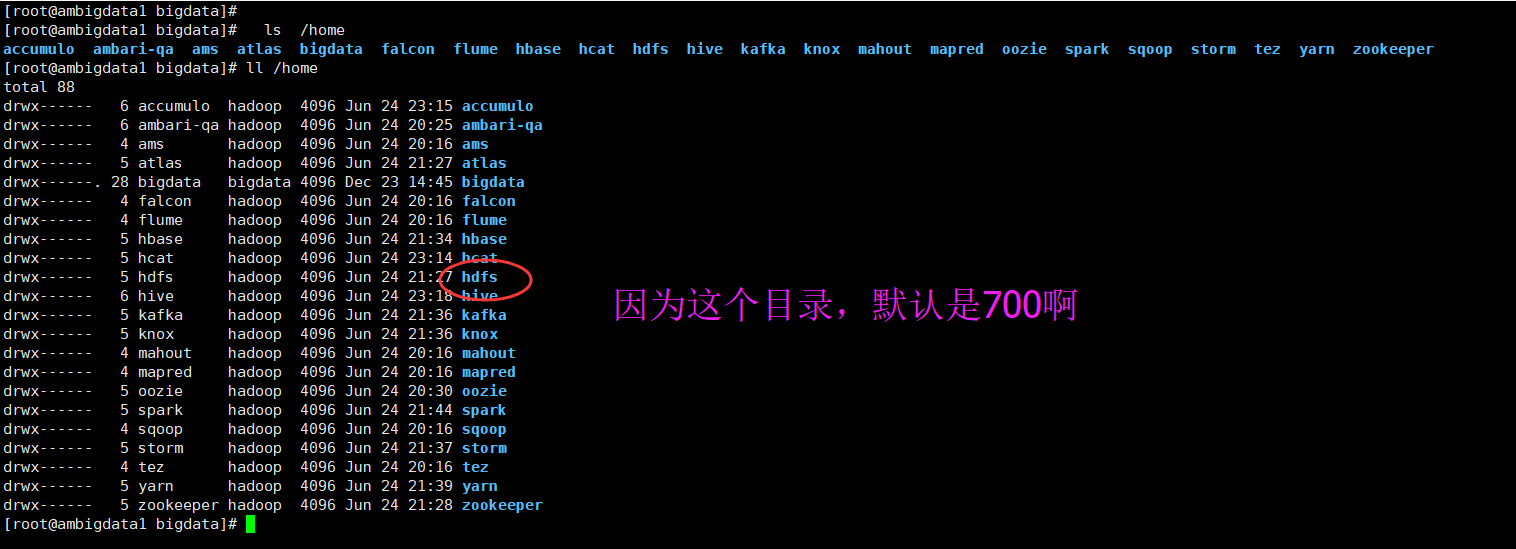
除了自己谁都 操作不了。
bigdata用户是我安装ambari集群时候的用户,是除了自己bigdata这个用户之外,以及root用户,其余全都无法操作。
问题解决办法
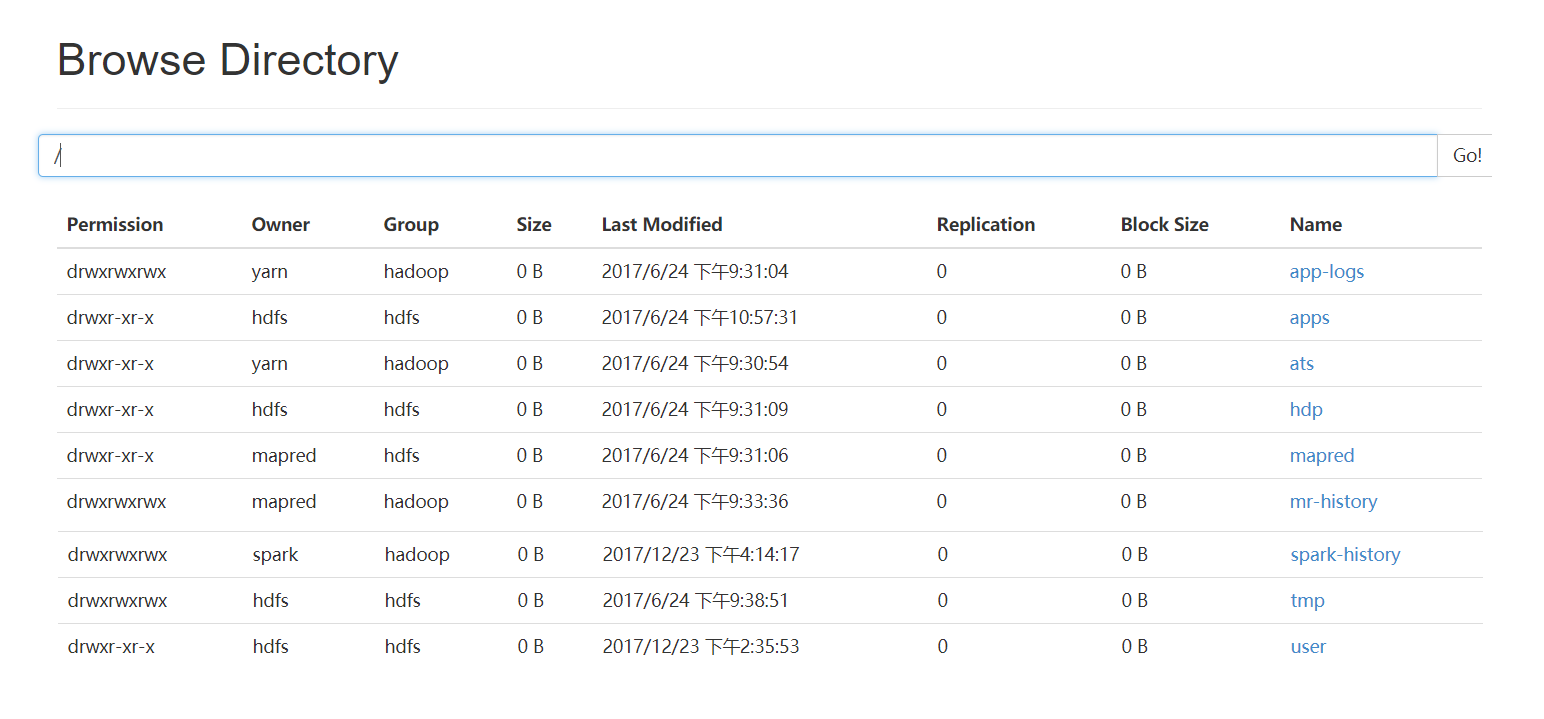
[bigdata@ambigdata1 ~]$ sudo -u hdfs hadoop fs -mkdir /papaerdata
[bigdata@ambigdata1 ~]$ sudo -u hdfs hadoop fs -chmod -R 777 /papaerdata
[root@ambigdata1 ~]# chmod 755 -R /root
[root@ambigdata1 bigdata]# sudo -u hdfs hadoop fs -chmod -R 777 /paperdata
[root@ambigdata1 bigdata]# hadoop fs -put 1.txt /paperdata
成功!
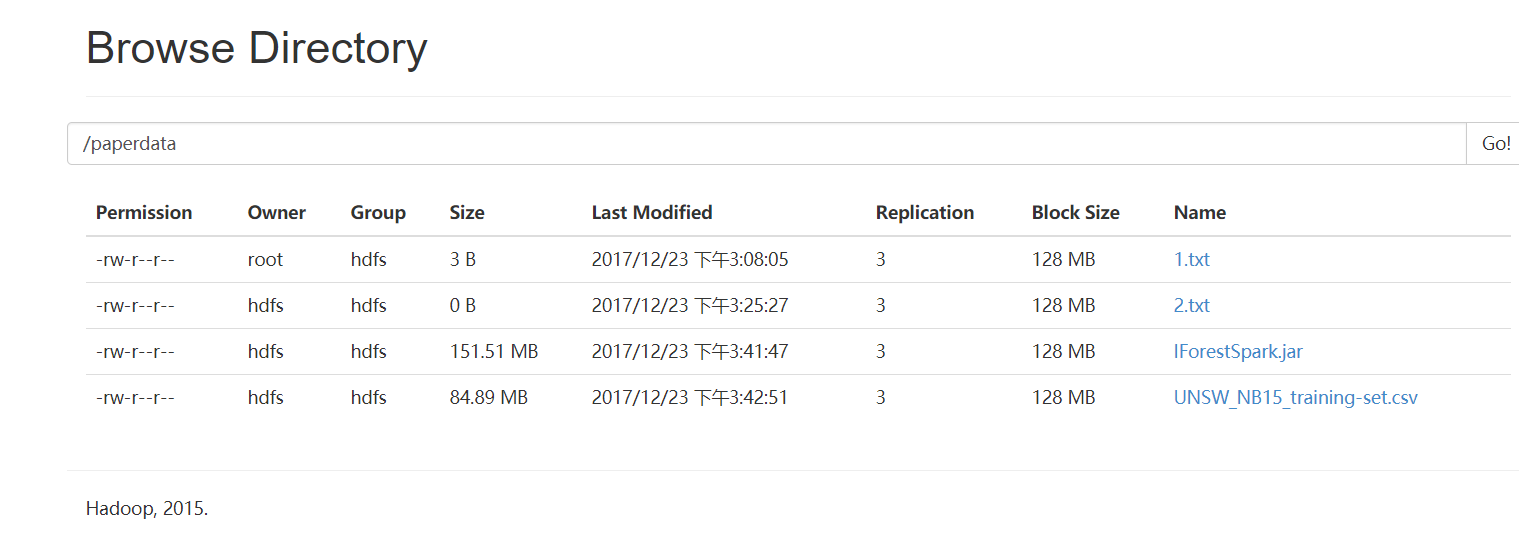
切换到hdfs上验证下(必须得先从)
[bigdata@ambigdata1 ~]$ su root
Password:
[root@ambigdata1 bigdata]# su hdfs
[hdfs@ambigdata1 bigdata]$
[hdfs@ambigdata1 ~]$ touch 2.txt
[hdfs@ambigdata1 ~]$ hadoop fs -put 2.txt /paperdata
[hdfs@ambigdata1 ~]$
如果想删除,则
[root@ambigdata1 bigdata]# sudo -u hdfs hadoop fs -rm -r /paperdata/1.txt
17/12/23 16:50:18 INFO fs.TrashPolicyDefault: Namenode trash configuration: Deletion interval = 360 minutes, Emptier interval = 0 minutes.
Moved: 'hdfs://ambigdata1:8020/paperdata1.txt' to trash at: hdfs://ambigdata1:8020/user/hdfs/.Trash/Current
[root@ambigdata1 bigdata]#
spark-submit --master yarn-cluster --num-executors 4 --driver-memory 4g --executor-memory 4g --executor-cores 4 --class iforest.TestIF hdfs://ambigdata1:9000/paperdata/IForestSpark.jar hdfs://ambigdata1:9000/paperdata/UNSW-NB15_change.csv hdfs://ambigdata1:9000/paperdata/out
同时,大家可以关注我的个人博客:
http://www.cnblogs.com/zlslch/ 和 http://www.cnblogs.com/lchzls/ http://www.cnblogs.com/sunnyDream/
详情请见:http://www.cnblogs.com/zlslch/p/7473861.html
人生苦短,我愿分享。本公众号将秉持活到老学到老学习无休止的交流分享开源精神,汇聚于互联网和个人学习工作的精华干货知识,一切来于互联网,反馈回互联网。
目前研究领域:大数据、机器学习、深度学习、人工智能、数据挖掘、数据分析。 语言涉及:Java、Scala、Python、Shell、Linux等 。同时还涉及平常所使用的手机、电脑和互联网上的使用技巧、问题和实用软件。 只要你一直关注和呆在群里,每天必须有收获
对应本平台的讨论和答疑QQ群:大数据和人工智能躺过的坑(总群)(161156071)
Ambari集群里操作时典型权限问题put: `/home/bigdata/1.txt': No such file or directory的解决方案(图文详解)的更多相关文章
- 给Ambari集群里安装可视化分析利器工具Hue步骤(图文详解)
扩展博客 以下,是我在手动的CDH版本平台下,安装Hue. CDH版本大数据集群下搭建Hue(hadoop-2.6.0-cdh5.5.4.gz + hue-3.9.0-cdh5.5.4.tar.gz) ...
- 给ambari集群里的kafka安装基于web的kafka管理工具Kafka-manager(图文详解)
不多说,直接上干货! 参考博客 基于Web的Kafka管理器工具之Kafka-manager的编译部署详细安装 (支持kafka0.8.0.9和0.10以后版本)(图文详解)(默认端口或任意自定义端口 ...
- 给Ambari集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
不多说,直接上干货! Impala和Hive的关系(详解) 扩展博客 给Clouderamanager集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解) 参考 horton ...
- ambari集群里如何正确删除历史修改记录(图文详解)
不多说,直接上干货! 答:这些你想删除的话得得去数据库里删除,最好别删除 . 现在默认就是使用好的配置 欢迎大家,加入我的微信公众号:大数据躺过的坑 人工智 ...
- CentOS5/6/7系统下搭建安装Amabari大数据集群时出现SSLError: Failed to connect. Please check openssl library versions.错误的解决办法(图文详解)
不多说,直接上干货! ========================== Creating target directory... ========================== Comman ...
- ClouderManger搭建大数据集群时ERROR 2003 (HY000): Can't connect to MySQL server on 'ubuntucmbigdata1' (111)的问题解决(图文详解)
问题详情 相关问题的场景,是在我下面的这篇博客里 Cloudera Manager安装之利用parcels方式(在线或离线)安装3或4节点集群(包含最新稳定版本或指定版本的安装)(添加服务)(Ubun ...
- Spark Mllib里如何将如温度、湿度和风速等数值特征字段用除以***进行标准化(图文详解)
不多说,直接上干货! 具体,见 Hadoop+Spark大数据巨量分析与机器学习整合开发实战的第18章 决策树回归分类Bike Sharing数据集
- 给Clouderamanager集群里安装可视化分析利器工具Hue步骤(图文详解)
扩展博客 以下,是我在手动的CDH版本,安装Hue. CDH版本大数据集群下搭建Hue(hadoop-2.6.0-cdh5.5.4.gz + hue-3.9.0-cdh5.5.4.tar.gz)(博主 ...
- 给Clouderamanager集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
这个很简单,在集群机器里,选择就是了,本来自带就有Impala的. 扩展博客 给Ambari集群里安装基于Hive的大数据实时分析查询引擎工具Impala步骤(图文详解)
随机推荐
- OpengGL中图形绘制先后问题
OpengGL中图形绘制先后问题 在opengl中,场景绘制总有个先后的顺序,也有个程序先后的问题,图形程序在前在后,对最终的图形的影响如何? (1)设置图中的点(蓝色)与线条(浅蓝)z分量都是0,如 ...
- ETL开发
要进入开发阶段,了解不同的ETL产品. 整个ETL系统中,时间或更精确的,吞吐量是主要关心的内容.这种转换处理任务设计的主要目的归根结底是使得数据装载到展现表中最快并使得最终用户能快速的从这些表中得到 ...
- Linux C 网络编程——3. TCP套接口编程
1. 基本流程 2. socket() int socket(int domain, int type, int protocol); socket()打开一个网络通讯端口,如果成功的话,就像open ...
- 深海划水队项目---七天冲刺day1
团队会议: 团队成员的任务认领安排: 张兆敏:登录界面,游戏界面(包含游戏区.控制区.显示信息区). 乐滔:方块的形状.移动(向左或者向右)旋转(顺时针或者逆时针),方块的下落(包含硬着陆和软着陆), ...
- delphi http 403 获取不到服务器返回的错误消息 用浏览器打开url可以返回
用delphi的idhttp Get一个url如下: http://117.135.237.4:9090/agent/api/treatmentModeUpdate?userName=VDAwMIMQ ...
- HBase – 探索HFile索引机制
本文由 网易云发布. 作者: 范欣欣 本篇文章仅限内部分享,如需转载,请联系网易获取授权. 01 HFile索引结构解析 HFile中索引结构根据索引层级的不同分为两种:single-level和m ...
- Android 的一些中文文档
https://blog.csdn.net/qq_36467463/article/details/77990089 //安卓mediaformat api详解 https://www.cnbl ...
- 【OCP-12c】2019年CUUG OCP 071考试题库(79题)
79.Which statement is true about transactions? A. A set of Data Manipulation Language (DML) statemen ...
- “全栈2019”Java异常第八章:throw关键字详解
难度 初级 学习时间 10分钟 适合人群 零基础 开发语言 Java 开发环境 JDK v11 IntelliJ IDEA v2018.3 文章原文链接 "全栈2019"Java异 ...
- HDP Spark2 HIVE3.1 的问题
HDP 上安装了 Hive3.1 和 Spark2, 提交 Spark 作业时,报找不到 Hive 中表的问题 但是查一了下 hive 表,明明是存在这个表的.查看日志,注意到如下的一段日志. 没修改 ...