
Hadoop 学习之路(五)—— Hadoop集群环境搭建
一、集群规划
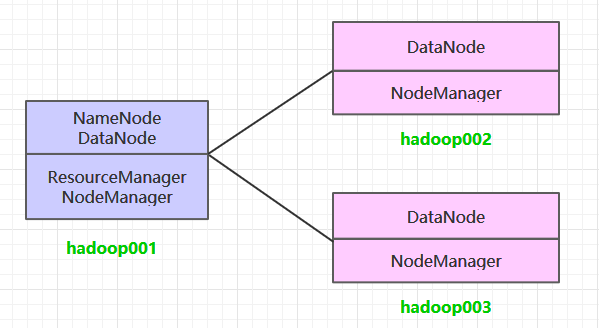
这里搭建一个3节点的Hadoop集群,其中三台主机均部署DataNode和NodeManager服务,但只有hadoop001上部署NameNode和ResourceManager服务。
二、前置条件
Hadoop的运行依赖JDK,需要预先安装。其安装步骤单独整理至:
三、配置免密登录
3.1 生成密匙
在每台主机上使用ssh-keygen命令生成公钥私钥对:
ssh-keygen
3.2 免密登录
将hadoop001的公钥写到本机和远程机器的~/ .ssh/authorized_key文件中:
ssh-copy-id -i ~/.ssh/id_rsa.pub hadoop001
ssh-copy-id -i ~/.ssh/id_rsa.pub hadoop002
ssh-copy-id -i ~/.ssh/id_rsa.pub hadoop003
3.3 验证免密登录
ssh hadoop002
ssh hadoop003
四、集群搭建
3.1 下载并解压
下载Hadoop。这里我下载的是CDH版本Hadoop,下载地址为:http://archive.cloudera.com/cdh5/cdh/5/
# tar -zvxf hadoop-2.6.0-cdh5.15.2.tar.gz
3.2 配置环境变量
编辑profile文件:
# vim /etc/profile
增加如下配置:
export HADOOP_HOME=/usr/app/hadoop-2.6.0-cdh5.15.2
export  PATH=${HADOOP_HOME}/bin:$PATH
执行source命令,使得配置立即生效:
# source /etc/profile
3.3 修改配置
进入${HADOOP_HOME}/etc/hadoop目录下,修改配置文件。各个配置文件内容如下:
1. hadoop-env.sh
# 指定JDK的安装位置
export JAVA_HOME=/usr/java/jdk1.8.0_201/
2. core-site.xml
<configuration>
    <property>
        <!--指定namenode的hdfs协议文件系统的通信地址-->
        <name>fs.defaultFS</name>
        <value>hdfs://hadoop001:8020</value>
    </property>
    <property>
        <!--指定hadoop集群存储临时文件的目录-->
        <name>hadoop.tmp.dir</name>
        <value>/home/hadoop/tmp</value>
    </property>
</configuration>
3. hdfs-site.xml
<property>
      <!--namenode节点数据(即元数据)的存放位置,可以指定多个目录实现容错,多个目录用逗号分隔-->
    <name>dfs.namenode.name.dir</name>
    <value>/home/hadoop/namenode/data</value>
</property>
<property>
      <!--datanode节点数据(即数据块)的存放位置-->
    <name>dfs.datanode.data.dir</name>
    <value>/home/hadoop/datanode/data</value>
</property>
4. yarn-site.xml
<property>
    <!--配置NodeManager上运行的附属服务。需要配置成mapreduce_shuffle后才可以在Yarn上运行MapReduce程序。-->
    <name>yarn.nodemanager.aux-services</name>
    <value>mapreduce_shuffle</value>
</property>
<property>
    <!--resourcemanager的主机名-->
    <name>yarn.resourcemanager.hostname</name>
    <value>hadoop001</value>
</property>
</configuration>
5. mapred-site.xml
<configuration>
    <property>
        <!--指定mapreduce作业运行在yarn上-->
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
</configuration>
5. slaves
配置所有从属节点的主机名或IP地址,每行一个。所有从属节点上的DataNode服务和NodeManager服务都会被启动。
hadoop001
hadoop002
hadoop003
3.4 分发程序
将Hadoop安装包分发到其他两台服务器,分发后建议在这两台服务器上也配置一下Hadoop的环境变量。
# 将安装包分发到hadoop002
scp -r /usr/app/hadoop-2.6.0-cdh5.15.2/  hadoop002:/usr/app/
# 将安装包分发到hadoop003
scp -r /usr/app/hadoop-2.6.0-cdh5.15.2/  hadoop003:/usr/app/
3.5 初始化
在Hadoop001上执行namenode初始化命令:
hdfs namenode -format
3.6 启动集群
进入到Hadoop001的${HADOOP_HOME}/sbin目录下,启动Hadoop。此时hadoop002和hadoop003上的相关服务也会被启动:
# 启动dfs服务
start-dfs.sh
# 启动yarn服务
start-yarn.sh
3.7 查看集群
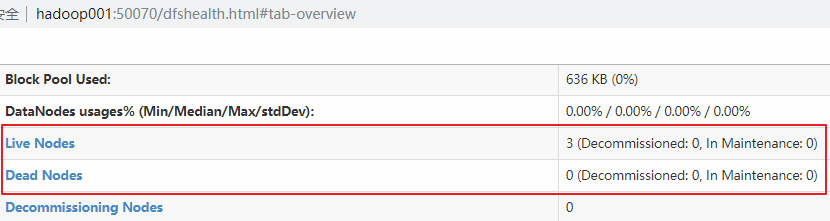
在每台服务器上使用jps命令查看服务进程,或直接进入Web-UI界面进行查看,端口为50070。可以看到此时有三个可用的Datanode:
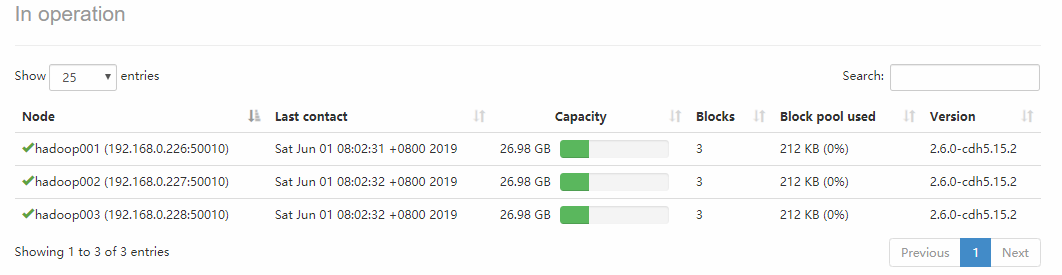
点击Live Nodes进入,可以看到每个DataNode的详细情况:
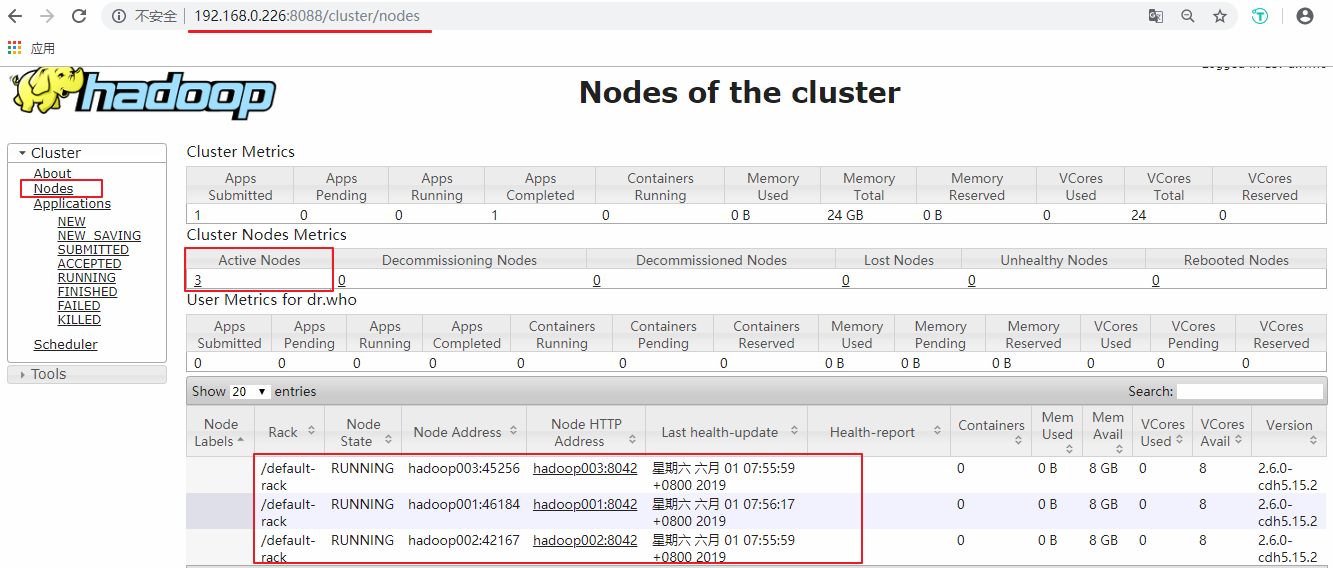
接着可以查看Yarn的情况,端口号为8088 :
五、提交服务到集群
提交作业到集群的方式和单机环境完全一致,这里以提交Hadoop内置的计算Pi的示例程序为例,在任何一个节点上执行都可以,命令如下:
hadoop jar /usr/app/hadoop-2.6.0-cdh5.15.2/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.6.0-cdh5.15.2.jar pi 3 3
更多大数据系列文章可以参见个人 GitHub 开源项目: 程序员大数据入门指南
Hadoop 学习之路(五)—— Hadoop集群环境搭建的更多相关文章
- Hadoop 2.6.0-cdh5.4.0集群环境搭建和Apache-Hive、Sqoop的安装
搭建此环境主要用来hadoop的学习,因此我们的操作直接在root用户下,不涉及HA. Software: Hadoop 2.6.0-cdh5.4.0 Apache-hive-2.1.0-bin Sq ...
- Hadoop 学习之路(八)—— 基于ZooKeeper搭建Hadoop高可用集群
一.高可用简介 Hadoop 高可用 (High Availability) 分为 HDFS 高可用和 YARN 高可用,两者的实现基本类似,但 HDFS NameNode 对数据存储及其一致性的要求 ...
- Hadoop集群环境搭建步骤说明
Hadoop集群环境搭建是很多学习hadoop学习者或者是使用者都必然要面对的一个问题,网上关于hadoop集群环境搭建的博文教程也蛮多的.对于玩hadoop的高手来说肯定没有什么问题,甚至可以说事“ ...
- 大数据 -- Hadoop集群环境搭建
首先我们来认识一下HDFS, HDFS(Hadoop Distributed File System )Hadoop分布式文件系统.它其实是将一个大文件分成若干块保存在不同服务器的多个节点中.通过联网 ...
- Spark集群环境搭建——Hadoop集群环境搭建
Spark其实是Hadoop生态圈的一部分,需要用到Hadoop的HDFS.YARN等组件. 为了方便我们的使用,Spark官方已经为我们将Hadoop与scala组件集成到spark里的安装包,解压 ...
- Hadoop+Spark:集群环境搭建
环境准备: 在虚拟机下,大家三台Linux ubuntu 14.04 server x64 系统(下载地址:http://releases.ubuntu.com/14.04.2/ubuntu-14.0 ...
- hadoop集群环境搭建之zookeeper集群的安装部署
关于hadoop集群搭建有一些准备工作要做,具体请参照hadoop集群环境搭建准备工作 (我成功的按照这个步骤部署成功了,经实际验证,该方法可行) 一.安装zookeeper 1 将zookeeper ...
- hadoop集群环境搭建之安装配置hadoop集群
在安装hadoop集群之前,需要先进行zookeeper的安装,请参照hadoop集群环境搭建之zookeeper集群的安装部署 1 将hadoop安装包解压到 /itcast/ (如果没有这个目录 ...
- hadoop集群环境搭建准备工作
一定要注意hadoop和linux系统的位数一定要相同,就是说如果hadoop是32位的,linux系统也一定要安装32位的. 准备工作: 1 首先在VMware中建立6台虚拟机(配置默认即可).这是 ...
- Hadoop完全分布式集群环境搭建
1. 在Apache官网下载Hadoop 下载地址:http://hadoop.apache.org/releases.html 选择对应版本的二进制文件进行下载 2.解压配置 以hadoop-2.6 ...
随机推荐
- WolframAlpha 的使用
WolframAlpha 1. 求解复杂方程组 a+b=−4ab+c=2ac=1 直接点开网站,在输入框中输入,a+b=-4;ab+c=2;ac=1;(逗号分割开来),
- HDU 4279 Number(2012天津网络游戏---数论分析题)
转载请注明出处:http://blog.csdn.net/u012860063? viewmode=contents 题目链接:pid=4279">http://acm.hdu.edu ...
- Headless Chrome入门
原文地址:Getting Started with Headless Chrome By EricBidelman Engineer @ Google working on web tooling ...
- Kivy A to Z -- Kivy 示例演示自带名单
所有的样品已经在Android 4.04 手机正常进行 1.demo/kivycatalog 这个例子说明了如何使用主控件,例如Layout,Button,MediaPlayer,Progress B ...
- WPF Binding Path妙用
<Window x:Class="XamlTest.Window9" xmlns="http://schemas.microsoft.com/winf ...
- jquery 让图片飞
<!DOCTYPE html><html><head><meta http-equiv="Content-Type" content=&q ...
- 【C#】VS2012+InstallShield2013制作软件更新包
原文:[C#]VS2012+InstallShield2013制作软件更新包 上篇文章介绍了如何使用installshield制作软件的安装包,见地址:http://blog.csdn.net/cat ...
- Kali Linux安装TL-WN821N USB无线网卡驱动(make失败)
主要有下面几个步骤: 1.刚插上网卡,network-manager识别出来了网卡,也能搜索到WiFi,但就是连接不上.查看/var/log/syslog日志或者使用nmcli m查看网络信息,显示认 ...
- Win10《芒果TV》商店版更新v3.2.2:新增对Win10产品专用会员兑换码支持,全新的最具价值用户纪念奖励
在WinHEC2016宣布Win10和ARM历史性结合之际,<芒果TV>UWP版迅速更新v3.2.2版,主要是新增对Win10产品专用会员兑换码支持,推出全新的最具价值用户纪念奖励(具有唯 ...
- 请求通道在等待 00:00:58.9616639 以后答复时超时。增加传递给请求调用的超时值,或者增加绑定上的 SendTimeout 值。分配给此操作的时间可能是更长超时的一部分。
异常信息:请求通道在等待 00:00:58.9616639 以后答复时超时.增加传递给请求调用的超时值,或者增加绑定上的 SendTimeout 值.分配给此操作的时间可能是更长超时的一部分. 开发背 ...