
Python日记:基于Scrapy的爬虫实现
安装 pywin32 和python版本一致
地址 https://sourceforge.net/projects/pywin32/files/pywin32/Build%20221/
安装过程中提示找不到Python2.7
解决方法:http://blog.csdn.net/pppii/article/details/48679403
安装Scrapy 使用pip
1、使用命令行创建爬虫项目
scrapy startproject myspider # cmd进入指定文件夹后创建一个名为 myspider的爬虫
2、启动pyCharm
打开项目 myspider ,在文件夹spiders下创建MySprider.py文件
添加我的爬虫 class Channel9Spider(scrapy.Spider):
name 表示爬虫的名称 属于唯一属性
allowed_domins=[] 爬虫允许的域
start_urls=[] 爬虫开始的页面
def parse(self,response): 访问地址后调用的方法
def details_parse(self,response): 处理详情页面的方法
MySprider.py遇到的问题:
1、windows命令提示符中打印爬取的文件名报错
原因:是命令行字符集和网页字符集不一致
处理方法:print item["title"].encode("gbk","ignore")
2、回调方法报错
原因:PyScrapy默认给回调加了个括号
处理方法:去掉回调方法后的括号,需要传参使用Request(url=.. , meta={'name':'yancl',....},calback=self.details_parse,dont_filter=True)
3、提示访问被拒绝
原因:1、robots 协议问题 2、由于设置了允许爬取的域
处理方法:1、修改settings.py 设置ROBOTSTXT_OBEY = True
2、调用Request方法设置dont_filter=True
打开 items.py
添加在处理页面后要传递给pipeline的item数据对象
用到了下载所以添加 file_urls,files,file_paths
打开 pipeline.py
1、添加一个继承FilesPipeline文件下载管道的实现方法 MyFilesPipeline
2、添加一个记录文件方法 JsonWithEncodingPipeline
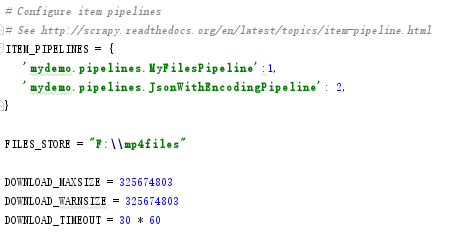
打开settings.py
1、启用我的Item Pipeline组建。我打算下载一个视频就记录一条对应的Json信息
2、添加视频下载保存文件的路径
再次启动爬虫 scrapy crawl myspider
遇到的问题:
1、下载文件过大
2、连接超时
3、文件下载的路径问题,默认添加full的文件夹
4、文件名问题
对于问题1、2、3 修改settings
DOWNLOAD_MAXSIZE = 325674803 #字节
DOWNLOAD_WARNSIZE = 325674803 #字节
DOWNLOAD_TIMEOUT = 30 * 60 #单位秒
FILES_STORE = "F:\\mp4files" #直接使用绝对路径
对于问题3,修改MyFilesPipeline方法 重写file_path方法
再次启动爬虫运行正常,但是还有2个小问题,1、有一个文件自动添加了文件夹 2、有几个文件没有后缀大小为0KB
根据日志分析是文件名导致了 文件名中不能有:/ 等特殊字符
MySpider.py
import scrapy

from mydemo.items import MydemoItem

from scrapy.http import Request

from scrapy.selector import Selector

download_domain = "https://channel9.msdn.com"

class Channel9Spider(scrapy.Spider):

    name = "myspider"

    allowed_domains = [".msdn.com"]

    start_urls = [

        "https://channel9.msdn.com/Events/Ignite/Microsoft-Ignite-China-2016?sort=status&direction=desc"

    ]

    def parse(self,response):

        sale = Selector(response)

        for a in sale.xpath("//h3"):

            title = a.xpath("a/text()").extract()[0]

            line = a.xpath("a/@href").extract()[0]

            fileurl = download_domain + line

            yield Request(url=fileurl,meta={'title':title},callback=self.details_parse,dont_filter=True)

        next_page = sale.xpath("//a[@rel='next']/@href").extract()

        if next_page:

            pagepath =  download_domain+next_page[0]

            yield Request(url=pagepath,callback=self.parse,dont_filter=True)

    def details_parse(self,response):

        sale = Selector(response)

        item = MydemoItem()

        item["title"] = response.meta['title']

        fileurl = sale.xpath("//*[@id='format']/option/@value").extract()[0]

        item["file_urls"] = [fileurl]

        yield item
items.py
class MydemoItem(scrapy.Item):

    # define the fields for your item here like:

    # name = scrapy.Field()

    title = scrapy.Field()

    link = scrapy.Field()

    content = scrapy.Field()

    file_urls = scrapy.Field()

    files = scrapy.Field()

    file_paths = scrapy.Field()

    pass
pipelines.py
# -*- coding: utf-8 -*-

# Define your item pipelines here

#

# Don't forget to add your pipeline to the ITEM_PIPELINES setting

# See: http://doc.scrapy.org/en/latest/topics/item-pipeline.html

import scrapy

import codecs

import json

import time

from scrapy.pipelines.files import FilesPipeline

from scrapy.exceptions import DropItem

class MydemoPipeline(object):

    def process_item(self, item, spider):

        return item

class JsonWithEncodingPipeline(object):

    def __init__(self):

        self.file = codecs.open('file.json','w',encoding='utf-8')

    def process_item(self,item,spider):

        timeSatamp = time.time()

        timeTuple = time.localtime(timeSatamp)

        curTime = time.strftime("%Y-%m-%d %H:%M:%S",timeTuple)

        line = "["+curTime+"] "+json.dumps(dict(item),ensure_ascii=False)+"\n"

        self.file.write(line)

        return item

    def spider_closed(self,spider):

        self.file.close()

class MyFilesPipeline(FilesPipeline):

    def get_media_requests(self,item,info):

        for file_url in item['file_urls']:

            yield scrapy.Request(file_url,meta={'title':item['title']})

    def item_completed(self, results, item, info):

        file_paths = [x['path'] for ok, x in results if ok]

        if not file_paths:

            raise DropItem("Item contains no Files")

        item["file_paths"] = file_paths

        return item

    def file_path(self,request,response=None,info=None):

        title = request.meta['title']

        file_guid = title + '.'+request.url.split('/')[-1].split('.')[-1]

        filename = u'{0}'.format(file_guid)

        return filename
settings.py
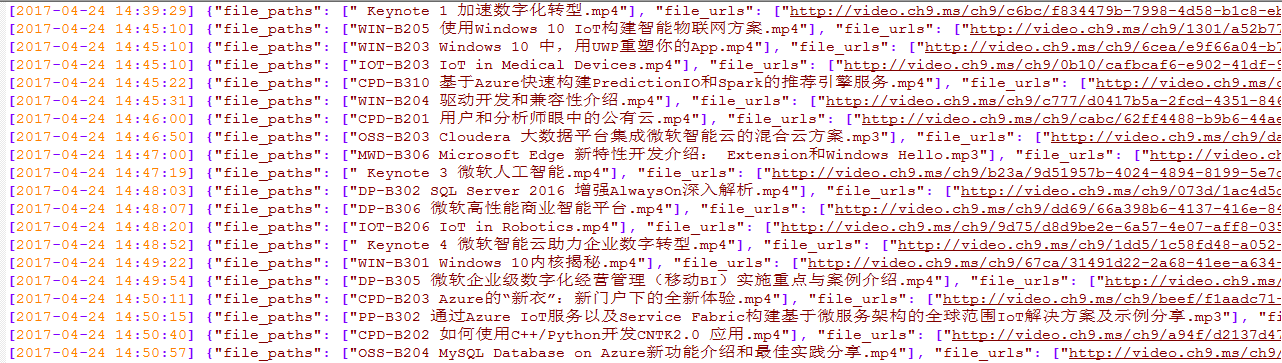
生成的日志截图如下:
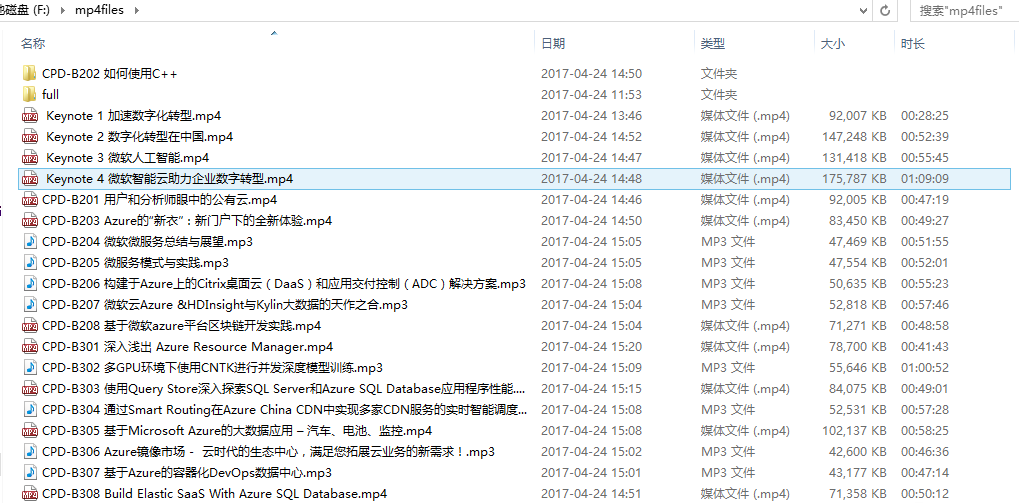
爬取的文件截图:
Python日记:基于Scrapy的爬虫实现的更多相关文章
- 爬虫学习之基于Scrapy的爬虫自动登录
###概述 在前面两篇(爬虫学习之基于Scrapy的网络爬虫和爬虫学习之简单的网络爬虫)文章中我们通过两个实际的案例,采用不同的方式进行了内容提取.我们对网络爬虫有了一个比较初级的认识,只要发起请求获 ...
- Python之(scrapy)爬虫
一.Scrapy是Python开发的一个快速.高层次的屏幕抓取和web抓取框架,用于抓取web站点并从页面中提取结构化的数据.Scrapy用途广泛,可以用于数据挖掘.监测和自动化测试. Scrapy吸 ...
- 基于scrapy爬虫的天气数据采集(python)
基于scrapy爬虫的天气数据采集(python) 一.实验介绍 1.1. 知识点 本节实验中将学习和实践以下知识点: Python基本语法 Scrapy框架 爬虫的概念 二.实验效果 三.项目实战 ...
- 基于Scrapy框架的Python新闻爬虫
概述 该项目是基于Scrapy框架的Python新闻爬虫,能够爬取网易,搜狐,凤凰和澎湃网站上的新闻,将标题,内容,评论,时间等内容整理并保存到本地 详细 代码下载:http://www.demoda ...
- Python分布式爬虫打造搜索引擎完整版-基于Scrapy、Redis、elasticsearch和django打造一个完整的搜索引擎网站
Python分布式爬虫打造搜索引擎 基于Scrapy.Redis.elasticsearch和django打造一个完整的搜索引擎网站 https://github.com/mtianyan/Artic ...
- 基于scrapy框架的爬虫
Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中. scrapy 框架 高性能的网络请求 高性能的数据解析 高性能的 ...
- 基于Scrapy的B站爬虫
基于Scrapy的B站爬虫 最近又被叫去做爬虫了,不得不拾起两年前搞的东西. 说起来那时也是突发奇想,想到做一个B站的爬虫,然后用的都是最基本的Python的各种库. 不过确实,实现起来还是有点麻烦的 ...
- 基于Scrapy的交互式漫画爬虫
Github项目地址 前言 该项目始于个人兴趣,本意为给无代码经验的朋友做到能开箱即用 阅读此文需要少量Scrapy,PyQt 知识,全文仅分享交流 摘要思路,如需可阅读源码,欢迎提 issue 一. ...
- 【Python实战】Scrapy豌豆荚应用市场爬虫
对于给定的大量APP,如何爬取与之对应的(应用市场)分类.描述的信息?且看下面分解. 1. 页面分析 当我们在豌豆荚首页搜索框输入微信后,会跳转到搜索结果的页面,其url为http://www.wan ...
随机推荐
- activity-alias详解及应用
activity-alias标签元素众所周知,AndroidManifest是一个xml文件,它包含很多标签元素,如application.activity.receiver等,其中有一个叫做acti ...
- NOIP2016 天天爱跑步 - 树上差分
传送门 题目分析: 一年前还是个傻子的时候居然直接放弃了这题. 首先列出两个方程:如果i节点的观察员能够观察到由s->t的那个人,那么: \[dep[s] - dep[i] = w[i], de ...
- storm 经常使用类
弄 <dependency> <groupId>org.apache.storm</groupId> <artifactId>storm-core< ...
- android studio报错提示: Gradle DSL method not found: 'android() 解决方案
原文错误提示: Error:(16, 0) Gradle DSL method not found: 'Android()'Possible causes:<ul><li>Th ...
- C# 控制台使用 UAC 权限
原文:C# 控制台使用 UAC 权限 本文告诉大家如何在 C# 控制台项目使用 UAC 权限.这个方法在 WPF 和 控制台都是可以使用. 右击项目,点击添加文件,找到程序清单 在 WPF 使用 UA ...
- 世界卫生组织(WHO)发出最新警告:埃博拉疫情应急响应
10月14r日.世界卫生组织(WHO)发出警告:在未来两个月内,西非国家将面对"could face up to 10 thousand new Ebola cases a week wit ...
- elasticsearch-jdbc
jprante/elasticsearch-jdbc The Java Database Connection (JDBC) importer allows to fetch data from JD ...
- 使用Apache Tiles3.x构建界面布局
Tiles是一个免费的开源模板Java应用程序的框架.基于复合模式简化的用户界面的构建.对于复杂的网站仍是最简单.最优雅的方式与任何MVC技术一起工作.Struts2对Tiles提供了支持,如今Til ...
- javascript中间AJAX
兼容访问XMLHttpRequest物: var xhr = null; if(window.XMLHttpRequest){ //非IE浏览器 xhr = window.XMLHttpRequest ...
- cookie登录功能实现
站点经常使用的记住我,或是一周内自己主动登录,这些功能一般都是是用cookie进行登录的!以下对此功能进行分析: package cookielogin; import java.io.IOExcep ...