
gerapy的初步使用(管理分布式爬虫)
一.简介与安装
Gerapy 是一款分布式爬虫管理框架,支持 Python 3,基于 Scrapy、Scrapyd、Scrapyd-Client、Scrapy-Redis、Scrapyd-API、Scrapy-Splash、Jinjia2、Django、Vue.js 开发。
特点:
更方便地控制爬虫运行

更直观地查看爬虫状态

更实时地查看爬取结果

更简单地实现项目部署

更统一地实现主机管理

更轻松地编写爬虫代码(几乎没用,感觉比较鸡肋)
安装:
pip install gerapy

#gerapy 判断是否安装成功
F:\gerapy>gerapy
Usage:
gerapy init [--folder=<folder>]
gerapy migrate
gerapy createsuperuser
gerapy runserver [<host:port>]
二.使用
1.初始化项目
gerapy  init

#执行完毕之后,便会在当前目录下生成一个名字为 gerapy 的文件夹,接着进入该文件夹,可以看到有一个 projects 文件夹

#或者
gerapy init 指定的绝对目录

#这样会在指定的文件夹生成一个gerapy文件夹
2.初始化数据库
进入新生成的gerapy文件夹
cd 到gerapy目录
cd gerapy

gerapy migrate
3.运行gerapy服务
gerapy runserver
这要命令必须新生成的gerapy文件夹只用,否则以前创建的项目都看不奥到
4.访问gerapy界面
http://127.0.0.1:8000
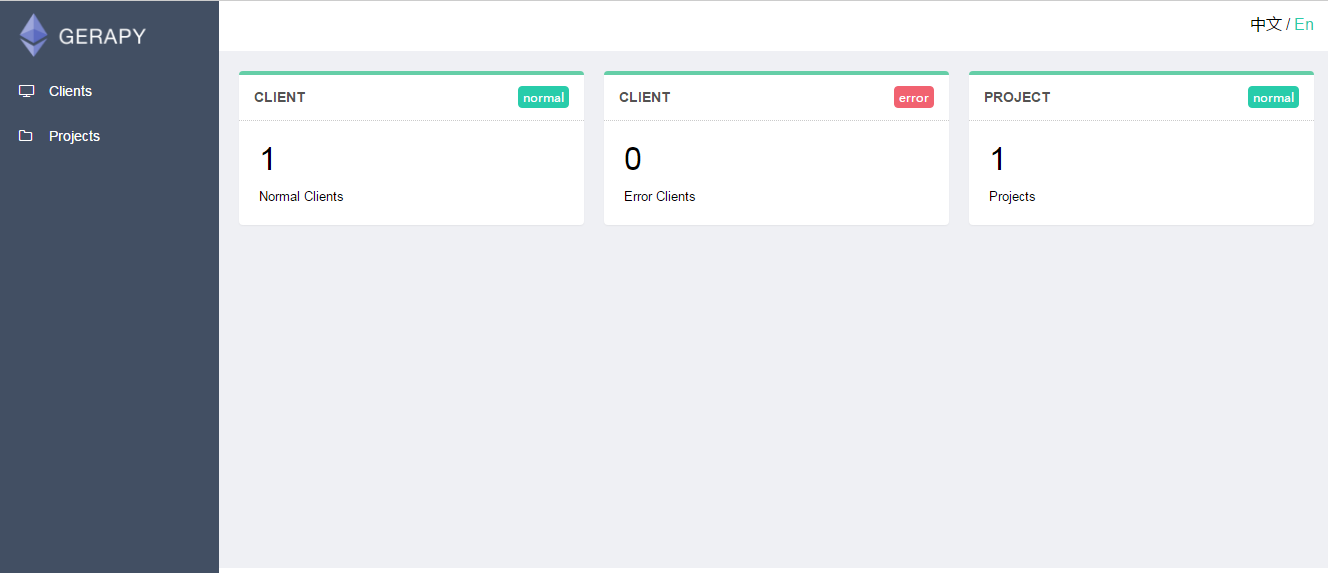
三.gerapy管理界面的使用
1.部署主机
就是配置我们scrapyd 远程服务.(指定远程服务器的ip和端口等等)
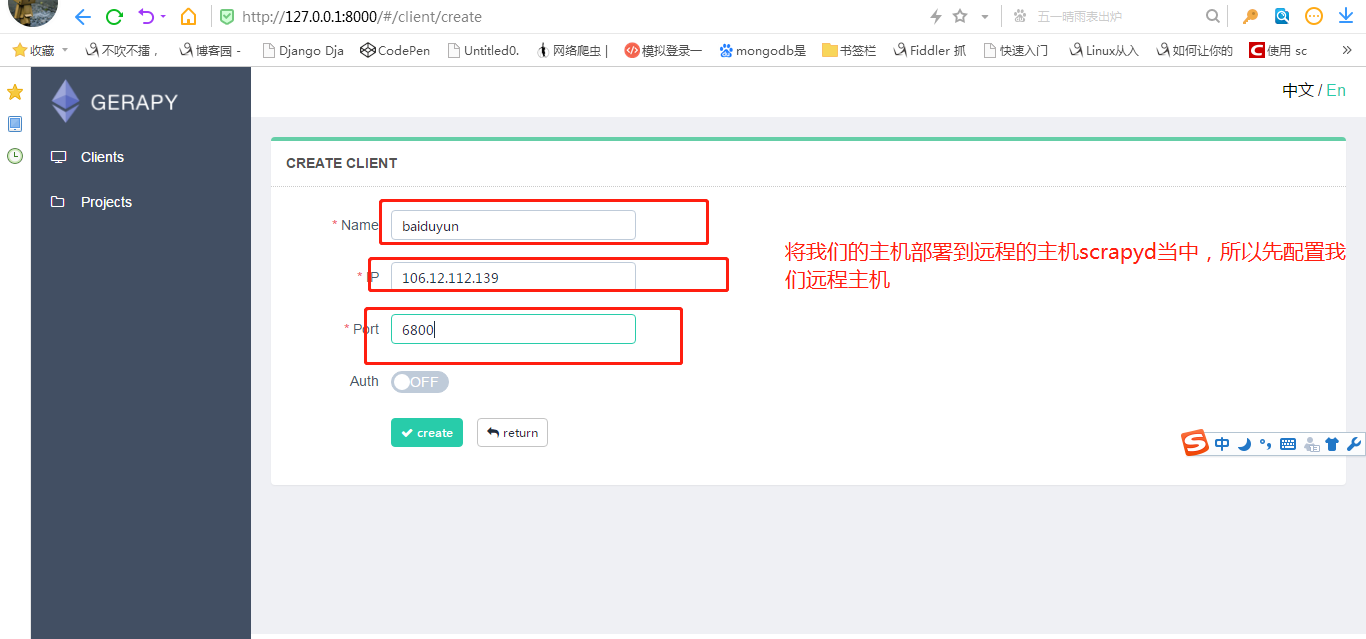
需要添加 IP、端口,以及名称,点击创建即可完成添加,点击返回即可看到当前添加的 Scrapyd 服务列表
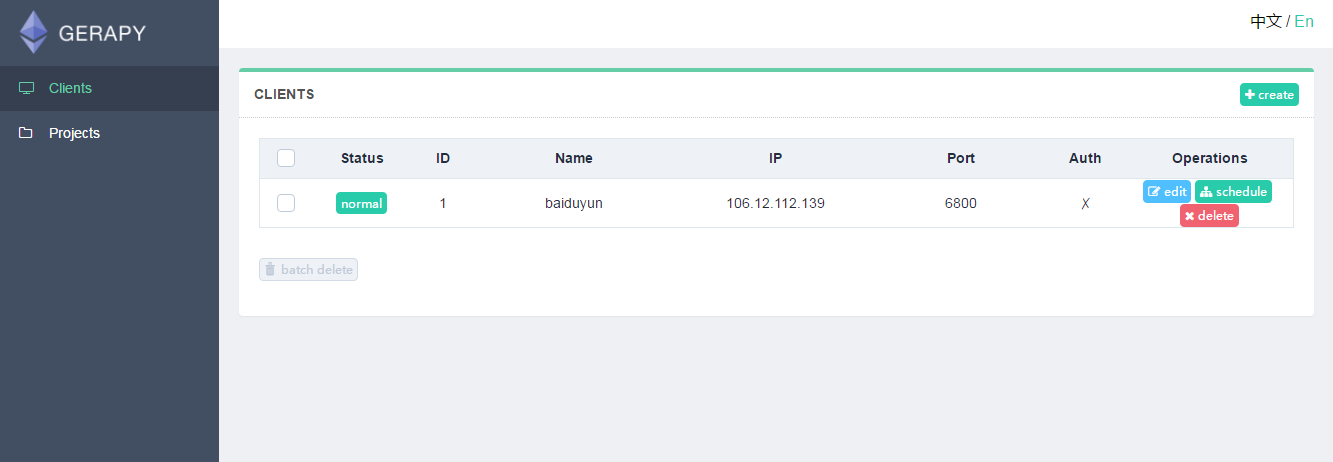
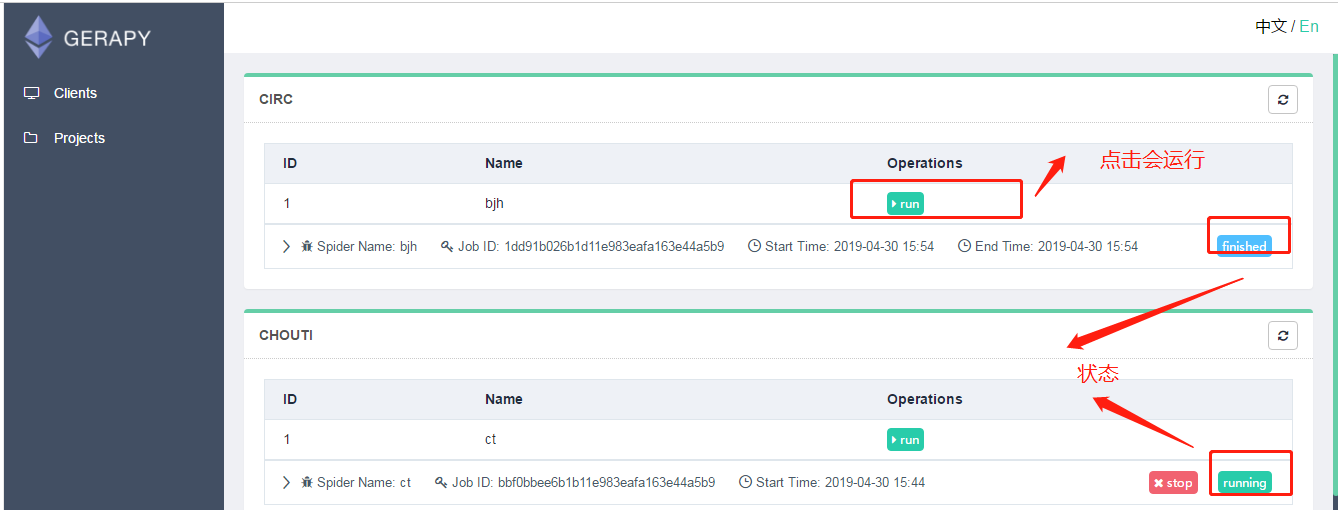
如果想执行爬虫,就点击调度.然后运行.
前提是: 我们配置的scrapyd中,已经发布了 爬虫.
Gerapy 与 scrapyd 有什么关联吗?
我们仅仅使用scrapyd是可以调用scrapy进行爬虫. 只是 需要使用命令行开启爬虫
curl http://127.0.0.1:6800/schedule.json -d project=工程名 -d spider=爬虫名
· 使用Greapy就是为了将使用命令行开启爬虫变成 “小手一点”. 我们在gerapy中配置了scrapyd后,不需要使用命令行,可以通过图形化界面直接开启爬虫.
2.部署项目
我们就可以把我们写好的爬虫文件放在生成的文件夹gerapy下projects内,然后刷新网页就可以发现项目就在里边了
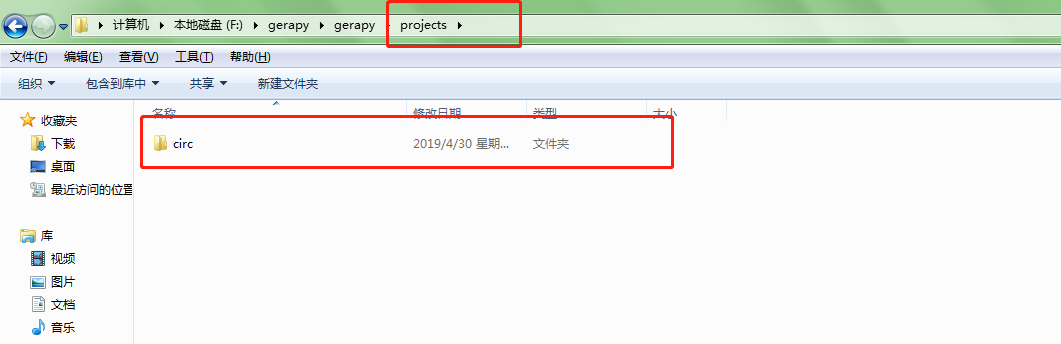
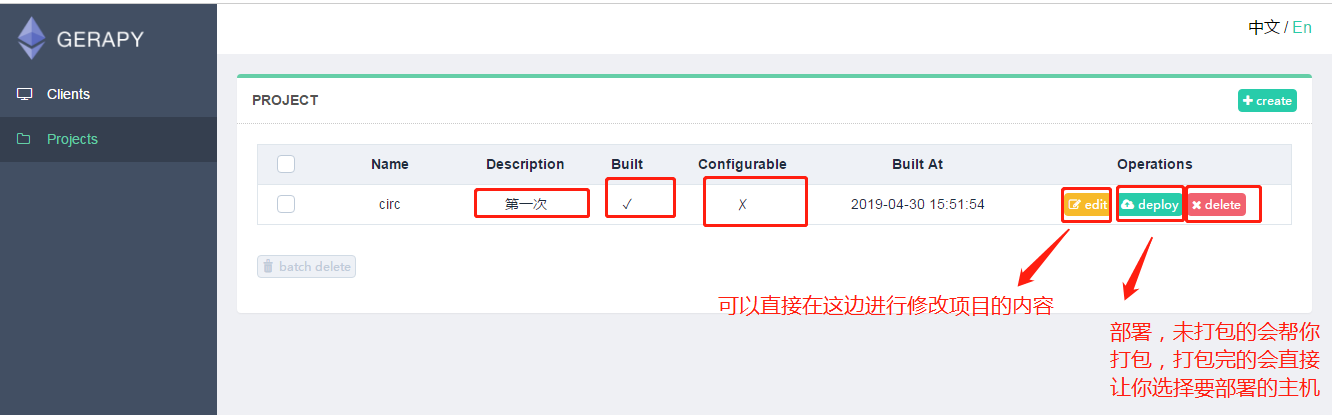
然后我们点击部署按钮就可以进行打包和部署了,描述是自定义的,这个只会在gerapy上显示,然后会提示我们打包成功,同时左侧会显示打包的结果和打包的名称。
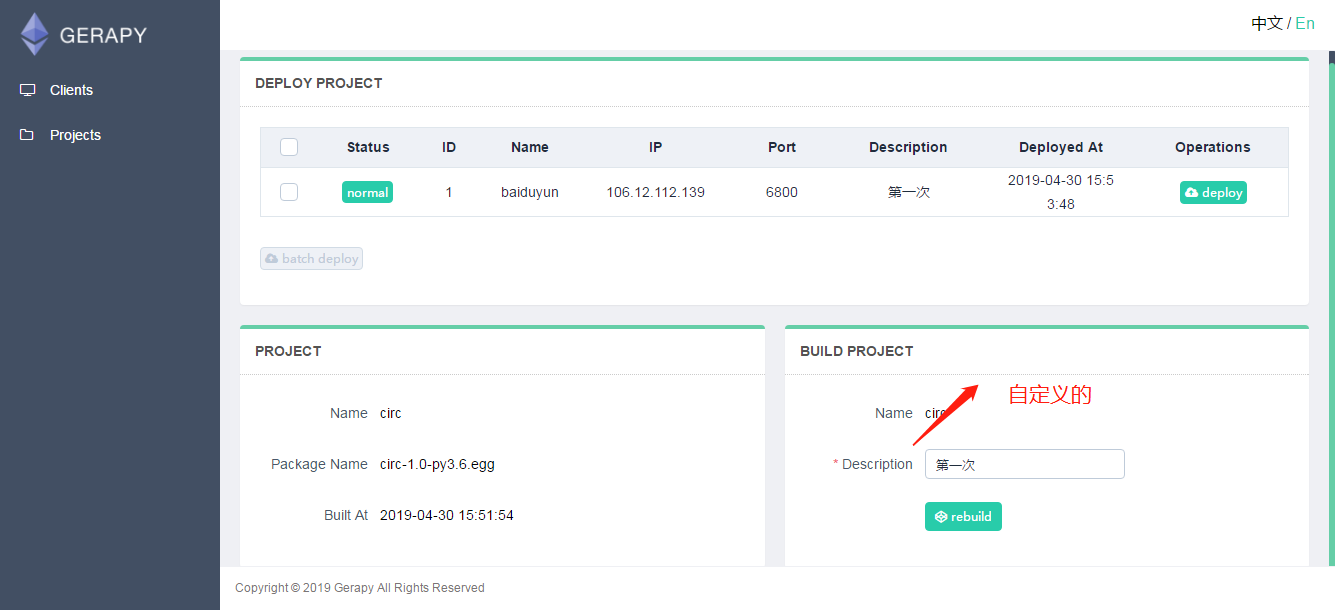
打包成功后我们就可以在进行部署了,如果有多个主机的话,我们就需要选择部署的主机,点击后边部署按钮,也可以同时批量选择主机进行部署。
然后我们就可以在主机的项目页面点击主机,看到爬虫的运行状态,并且不用在cmd中输入命令,通过点击就可以让爬虫
运行,停止,并且查看运行状态。
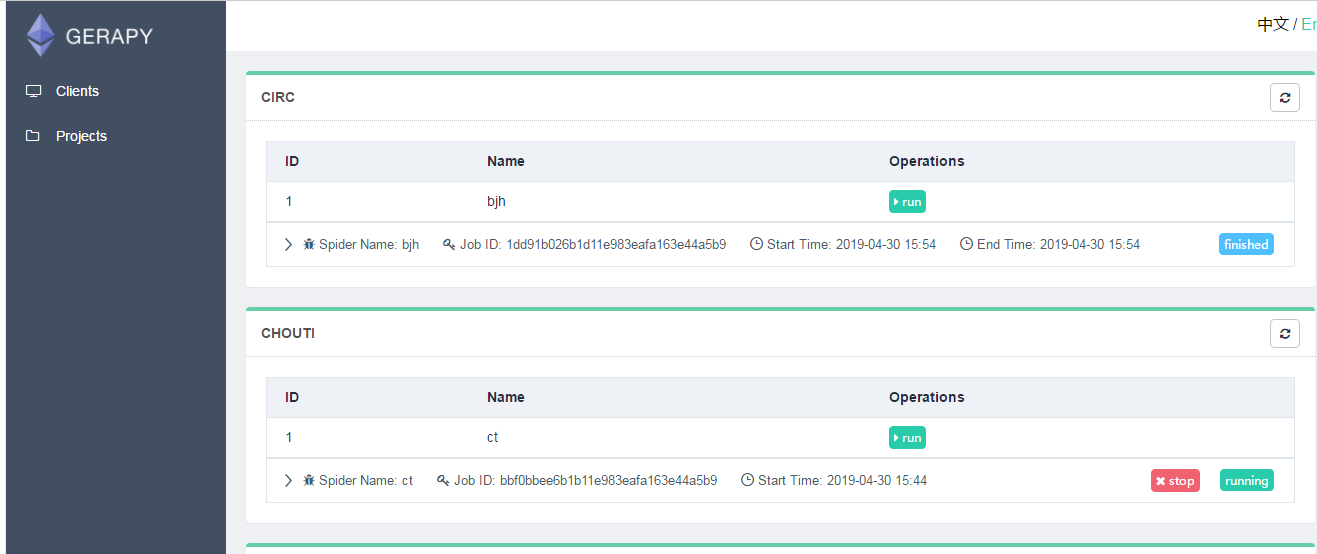
最后,gerapy也支持在其网页上自建爬虫项目,具体这里就不介绍了。
gerapy的初步使用(管理分布式爬虫)的更多相关文章
- gerapy+scrapyd组合管理分布式爬虫
Scrapyd是一款用于管理scrapy爬虫的部署和运行的服务,提供了HTTP JSON形式的API来完成爬虫调度涉及的各项指令.Scrapyd是一款开源软件,代码托管于Github上. 点击此链接h ...
- scrapydweb的初步使用(管理分布式爬虫)
https://github.com/my8100/files/blob/master/scrapydweb/README_CN.md 一.安装配置 1.请先确保所有主机都已经安装和启动 Scrapy ...
- Scrapy+Scrapy-redis+Scrapyd+Gerapy 分布式爬虫框架整合
简介:给正在学习的小伙伴们分享一下自己的感悟,如有理解不正确的地方,望指出,感谢~ 首先介绍一下这个标题吧~ 1. Scrapy:是一个基于Twisted的异步IO框架,有了这个框架,我们就不需要等待 ...
- 跟繁琐的命令行说拜拜!Gerapy分布式爬虫管理框架来袭!
背景 用 Python 做过爬虫的小伙伴可能接触过 Scrapy,GitHub:https://github.com/scrapy/scrapy.Scrapy 的确是一个非常强大的爬虫框架,爬取效率高 ...
- scrapyd部署、使用Gerapy 分布式爬虫管理框架
Scrapyd部署爬虫项目 GitHub:https://github.com/scrapy/scrapyd API 文档:http://scrapyd.readthedocs.io/en/stabl ...
- 第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理
第三百六十四节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理 1.映射(mapping)介绍 映射:创建索引的时候,可以预先定义字 ...
- 四十三 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的mapping映射管理
1.映射(mapping)介绍 映射:创建索引的时候,可以预先定义字段的类型以及相关属性elasticsearch会根据json源数据的基础类型猜测你想要的字段映射,将输入的数据转换成可搜索的索引项, ...
- Python分布式爬虫原理
转载 permike 原文 Python分布式爬虫原理 首先,我们先来看看,如果是人正常的行为,是如何获取网页内容的. (1)打开浏览器,输入URL,打开源网页 (2)选取我们想要的内容,包括标题,作 ...
- 基于Python,scrapy,redis的分布式爬虫实现框架
原文 http://www.xgezhang.com/python_scrapy_redis_crawler.html 爬虫技术,无论是在学术领域,还是在工程领域,都扮演者非常重要的角色.相比于其他 ...
随机推荐
- Golang使用pkg-config自动获取头文件和链接库的方法
为了能够重用已有的C语言库,我们在使用Golang开发项目或系统的时候难免会遇到Go和C语言混合编程,这时很多人都会选择使用cgo. 话说cgo这个东西可算得上是让人又爱又恨,好处在于它可以让你快速重 ...
- Deep learning for visual understanding: A review
https://www.sciencedirect.com/science/article/pii/S0924271618301291?dgcid=raven_sd_recommender_email ...
- jsp中路径的写法
在JavaWeb开发中,常使用绝对路径的方式来引入JavaScript和CSS文件,这样可以避免因为目录变动导致引入文件找不到的情况 代码” ${pageContext.request.context ...
- SqlServer 的一个坑
以前一直以为sqlserver 在做ddl 操作的时候是锁表的,而oracle 是锁行,感觉oracle 要比sqlserver 先进一些,但是这是我的认识错误.其实sqlserver 也是可以锁行的 ...
- 【JAVA 学习笔记1】代码注释
在JAVA中支持单行注释和多行注释 1.单行注释,只要在注释的一行代码中加上双斜杠即可 例如: // int a=2,b=4,c=8; 2.多行注释,在开始位置加上/* 结束位置加上*/ 例如 /* ...
- VR与AR的发展趋势分析
概要 你是否想象过与神秘的深海生物近距离接触?你是否梦想过穿戴钢铁侠那样的超先进科技装备成为超级英雄?你又是否幻想过与梦中的女神面对面的交流?这些可能在以前都只能是存在于脑海中的幻想,可是在如今有一项 ...
- 获取outlook联系人寻呼字段
这称不上一篇技术文. 这边记录解决一个问题的过程和感受.这种感觉每个搞IT的人或多或少都感受过,是程序人独有的快乐之一.只是大部分人没有将这种感觉记录下来.但是当你记录时,这种感觉也早已消失. 需求: ...
- File Path Directory总结
阅读目录 开始 Path 对路径 字符串进行操作 获得后缀 能合并路径 获取文件名 Directory和DirectoryInfo 对目录进行操作 判断目录是否存在 创建目录 删除目录 获取目录下所 ...
- asp.net mvc 3 linq实现数据的增、删、改、查、
添加数据 定义一个对象: public class Student { public int id{get; set;} public string Name{get;set;} public str ...
- Nova 通过Python API 查询,创建,删除flavor
[root@controller ~]# cat flavor.py from novaclient import client as nvclient from novaclient import ...