
【论文阅读】Beyond OCR + VQA: 将OCR融入TextVQA的执行流程中形成更鲁棒更准确的模型
论文题目:Beyond OCR + VQA: Involving OCR into the Flow for Robust and Accurate TextVQA
论文链接:https://dl.acm.org/doi/abs/10.1145/3474085.3475606
一、任务概述
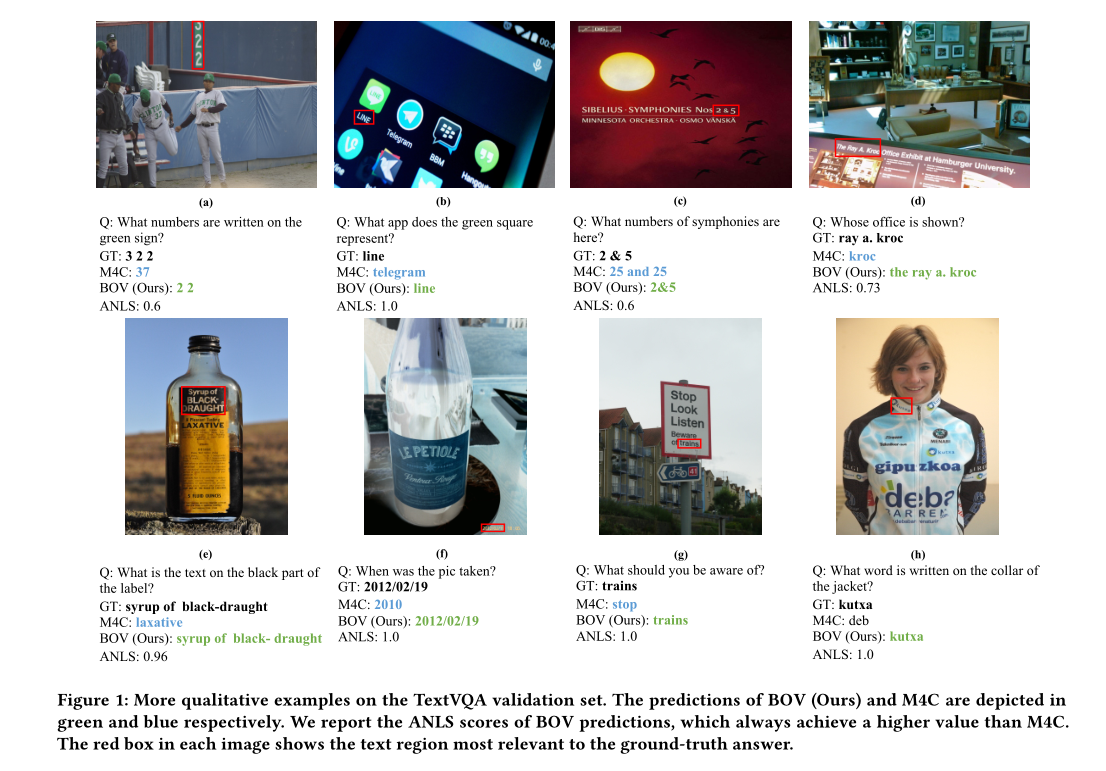
- 视觉问答任务(VQA):将图像和关于图像的自然语言问题作为输入,并生成自然语言答案作为输出。
- 文本视觉问答任务(TextVQA):面向文字识别的问答任务。
二、Baseline
2.1 Baseline 1: Look, Read, Reason & Answer (LoRRA):
- 2019年提出,推出标准数据集,原文地址:https://arxiv.org/abs/1904.08920v2
- 典型的TextVQA:将问题回答建模为分类任务,需要给定答案空间。
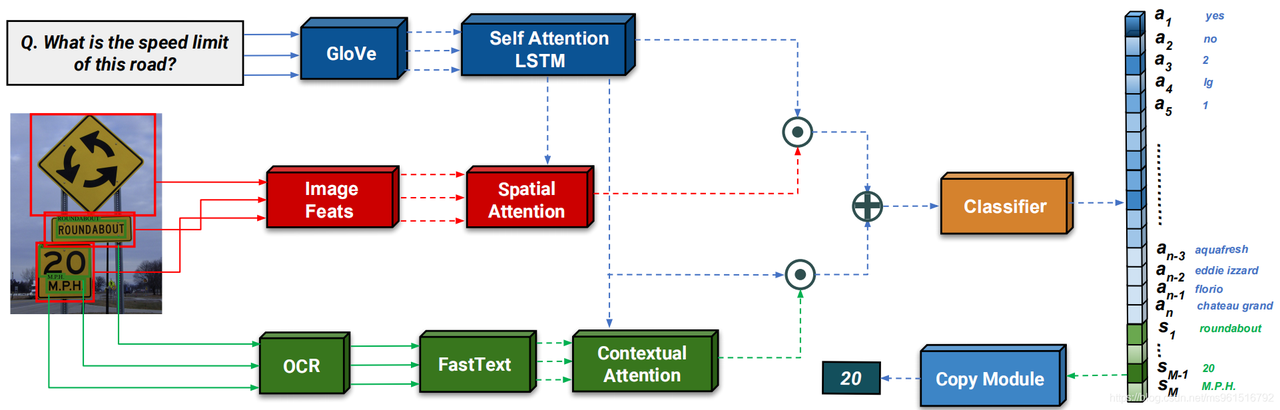
- 多模态嵌入:问题embedding、图像中的物体进行embedding、OCR的结果进行embedding(FastText做pre-train)
- 嵌入方式:
- 对问题进行GloVe Embedding,再通过LSTM得到问题嵌入 fQ(q),用于后续对图片特征以及OCR样本进行注意力加权平均。
- 将图像进行特征提取,提取的特征fI(v)与fQ(q)一起经过注意力机制得到加权的空间注意力,得到的结果与fQ(q)进行组合。
- OCR模块基于预训练模型(Faster RCNN + CTC)进行识别,识别出的结果fO(s)与fQ(q)一起经过注意力机制得到加权的空间注意力,得到的结果与fQ(q)进行组合。
- contact一起之后过分类器(MLP),分类的类别为问题空间a1……an 加上 OCR是识别出的词
2.2 Baseline 2:M4C
- 主贡献:提出了迭代预测的解码方式,但我们更关注特征表示的部分
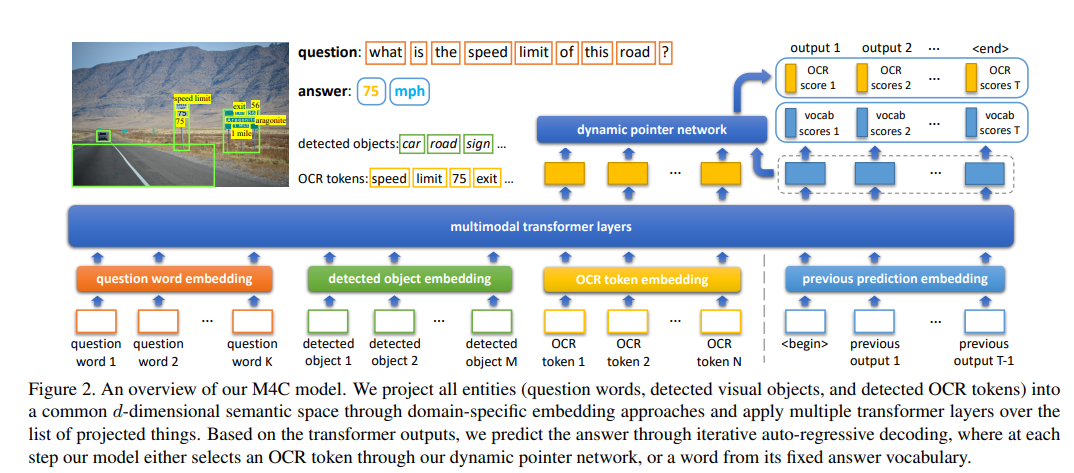
- Question embedding:BERT-base模型的encoder,但只用前3层,得到矩阵shape=(K, d)
- Detected object embedding:Faster-RCNN + Position,shape=(M, d)
- 融合方式:Linear + LayerNorm
- OCR token embedding 由四部分组成:
: 300维的FastText文本特征
: Faster RCNN特征,和detected object的获取方式一样
: 604维的Pyramidal Histogram of Characters(PHOC)特征
: 4维的位置特征,计算方式和detected object一样
- 融合方式:前三个特征过linear后做layernorm,position单独融合,再加起来
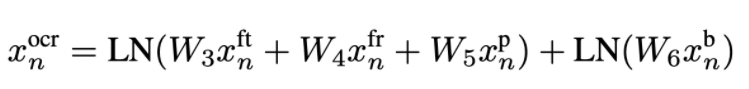
三、Motivation
- OCR的错误识别会较大程度影响多模态信息之间的交互(即fA的过程)
- 因为在表征空间中需要copy OCR识别的token,OCR的错误会较严重的影响解码器的性能(哪怕另两个分支完全准确也没法正确的输出)
四、Method
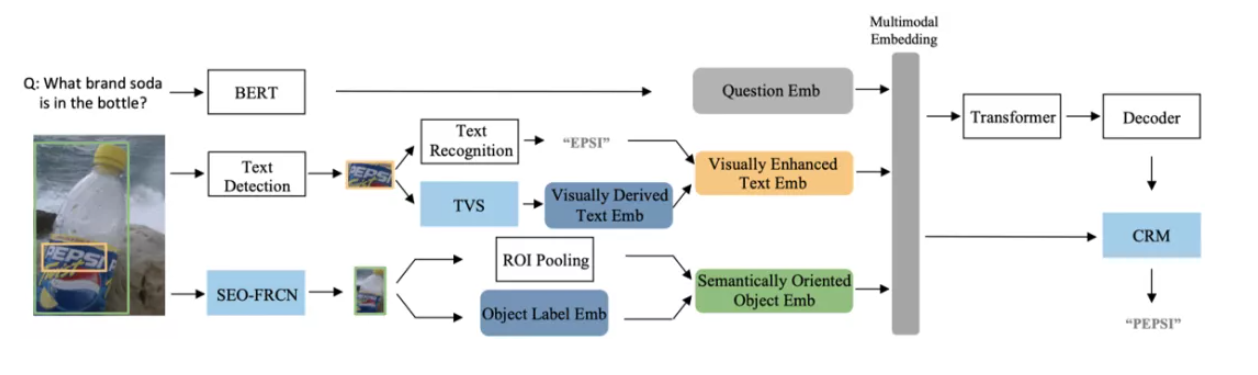
4.1 Contribution
- 增强特征表示的鲁棒性:减小OCR错误和物体识别错误对推理的影响
- 增强解码器的鲁棒性:在答案预测模块提出一个上下文感知的答案修正模块(CRM)对“复制”的答案词进行校正。
4.2 Architectural Details—— 视觉增强的文字表征模块 TVS (OCR增强)
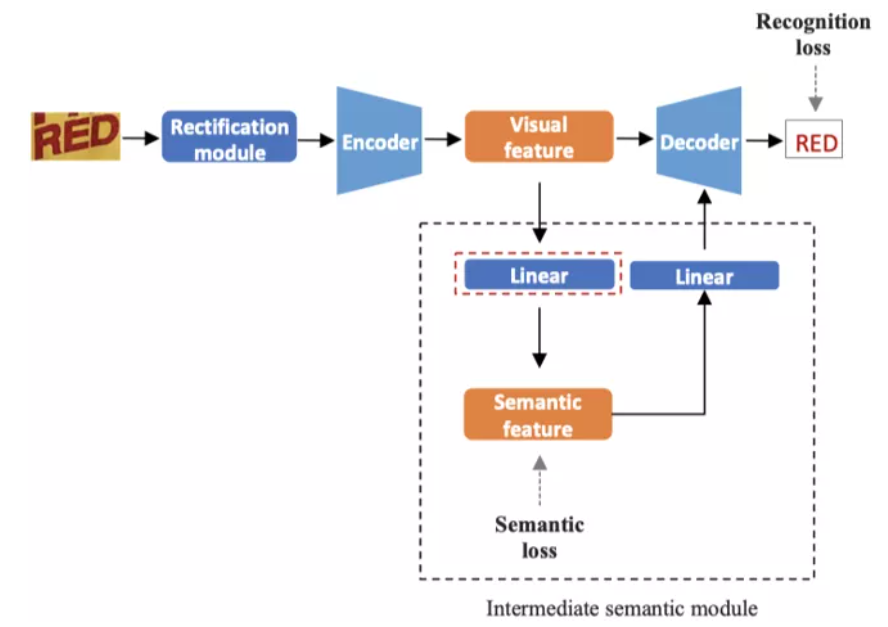
- method:
- 文字图像矫正模块
- 编码模块:45层ResNet+ 2层Bi-LSTM
- 解码模块:单层 注意力机制的GRU
- 中间语义模块:根据文字视觉信息预测语义信息
- train:利用外部数据集训练(SynthText + Synth90K)
- loss: OCR识别损失+语义损失
- 语义损失由真实和预测的语义特征向量间的余弦距离计算得到
- 优势:
- 通过语义损失的监督,编码模块能产生与文字解码更相关的视觉特征
- TVS为直接由文字图像的视觉特性获得语义表示提供可能。
- 整网中推理,OCR token details(n个文本框):
: TVS的视觉特征
- 融合方式:
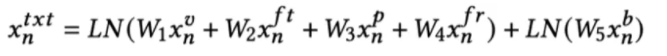
4.3 Architectural Details—— 语义导向的物体表征 SEO-FRCN(Visual增强)

- method:传统的Faster RCNN,在解码环节增加一个分支来 预测物体类别的embedding
- 物体类别embedding的gt 时物体类别名称的语义特征。
- train:使用Visual Genome数据集,backbone resnet101 预训练,新分支fine tune
- loss:RPN loss + 四分支loss
- 优势:能够拉近相似物体的图像相似度(例如 traffic light和traffic sign)
- 整网中推理,Visual token details(m个物体):
:视觉特征
- 特征融合:
4.3 Architectural Details——上下文感知的答案修正 CRM (解码结果增强)

- method:在推理阶段,对于”直接复制OCR结果”进行改进。
- 如果解码的输出指向图像中的文字,则将它视作一个候选词,利用输入的问题、其他文字信息和相关物体信息进行文字修正。
- 使用多个OCR模块输出多个预测结果作为候选集,选出得分最高的结果作为最后的输出。
- 组成:Transformer进行上下文信息融合 + linear&sigmoid 二分类器
- training:如果候选集的结果与gt相同则为1,不同则为0,构建训练数据。二分类预测一个相关分数,最小化交叉熵损失进行训练。
五、Experiment
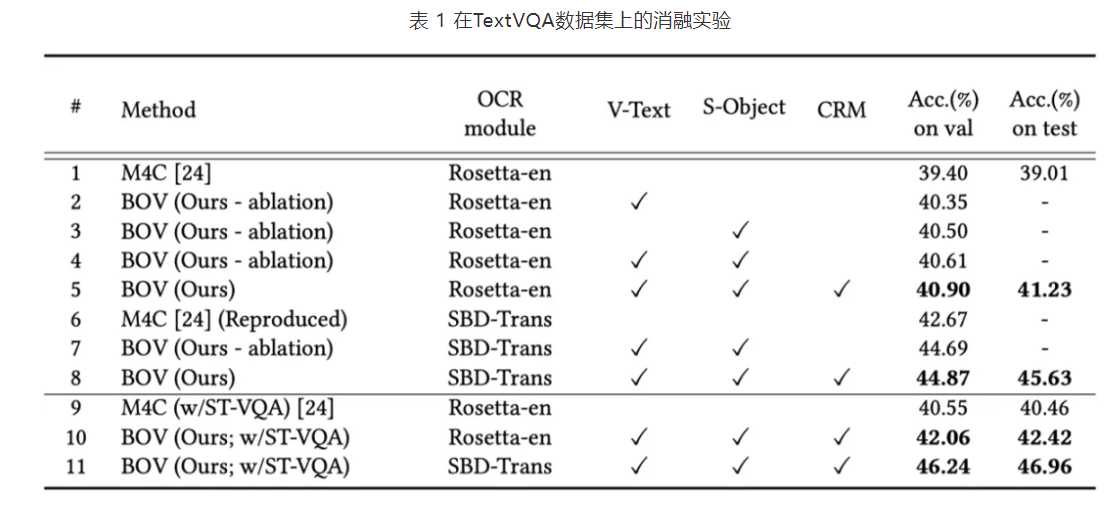
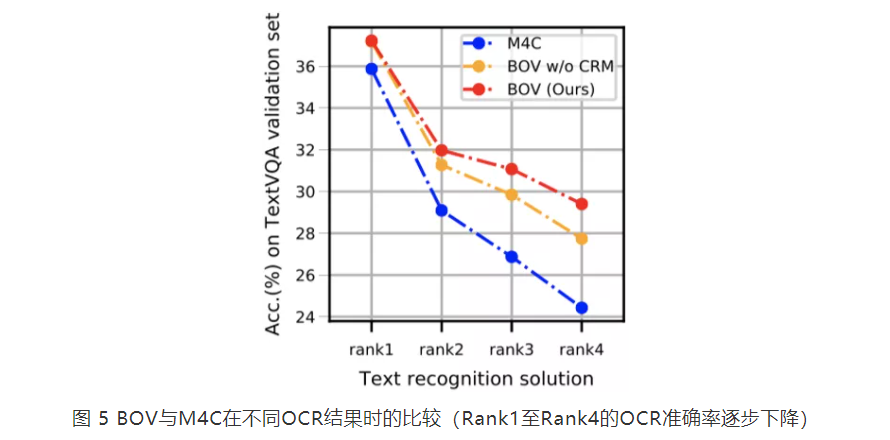
六、结论
- 将OCR融入TextVQA的前向处理流程,构建了一个鲁棒且准确的TextVQA模型
参考博客
【论文阅读】Beyond OCR + VQA: 将OCR融入TextVQA的执行流程中形成更鲁棒更准确的模型的更多相关文章
- 论文阅读:Face Recognition: From Traditional to Deep Learning Methods 《人脸识别综述:从传统方法到深度学习》
论文阅读:Face Recognition: From Traditional to Deep Learning Methods <人脸识别综述:从传统方法到深度学习> 一.引 ...
- 论文阅读(Xiang Bai——【CVPR2015】Symmetry-Based Text Line Detection in Natural Scenes)
Xiang Bai--[CVPR2015]Symmetry-Based Text Line Detection in Natural Scenes 目录 作者和相关链接 方法概括 创新点和贡献 方法细 ...
- 论文阅读笔记四十七:Generalized Intersection over Union: A Metric and A Loss for Bounding Box Regression(CVPR2019)
论文原址:https://arxiv.org/pdf/1902.09630.pdf github:https://github.com/generalized-iou 摘要 在目标检测的评测体系中,I ...
- 【论文阅读】Learning Spatial Regularization with Image-level Supervisions for Multi-label Image Classification
转载请注明出处:https://www.cnblogs.com/White-xzx/ 原文地址:https://arxiv.org/abs/1702.05891 Caffe-code:https:// ...
- 【论文阅读】Deep Mutual Learning
文章:Deep Mutual Learning 出自CVPR2017(18年最佳学生论文) 文章链接:https://arxiv.org/abs/1706.00384 代码链接:https://git ...
- 【阅读SpringMVC源码】手把手带你debug验证SpringMVC执行流程
✿ 阅读源码思路: 先跳过非重点,深入每个方法,进入的时候可以把整个可以理一下方法的执行步骤理一下,也可以,理到某一步,继续深入,回来后,接着理清除下面的步骤. ✿ 阅读本文的准备工作,预习一下Spr ...
- 论文阅读(Weilin Huang——【AAAI2016】Reading Scene Text in Deep Convolutional Sequences)
Weilin Huang--[AAAI2016]Reading Scene Text in Deep Convolutional Sequences 目录 作者和相关链接 方法概括 创新点和贡献 方法 ...
- 论文阅读(Xiang Bai——【TIP2014】A Unified Framework for Multi-Oriented Text Detection and Recognition)
Xiang Bai--[TIP2014]A Unified Framework for Multi-Oriented Text Detection and Recognition 目录 作者和相关链接 ...
- [论文阅读笔记] Fast Network Embedding Enhancement via High Order Proximity Approximati
[论文阅读笔记] Fast Network Embedding Enhancement via High Order Proximity Approximation 本文结构 解决问题 主要贡献 主要 ...
随机推荐
- 洛谷4606 SDOI2018战略游戏(圆方树+虚树)
QWQ深受其害 当时在现场是真的绝望...... 现在再重新来看这个题 QWQ 根据题目所说,我们可以发现,对于每一个集合中的节点,我们实际上就是要求两两路径上的割点的数目 考虑到又是关于点双的题目, ...
- 洛谷luogu3957跳房子(单调队列优化)
QwQ被普及组的题折磨的死去活来. 硬是卡线段树,没卡过QwQ oi生涯,第一道正经的单调队列dp题 进入正题 题目大意: 其中\(n \le 500000\) 看到这个题的第一感觉就是二分金币数 很 ...
- Mac录屏同时录制系统声音和画外音(Soundflower无法安装解决方案)
个人博客地址:xzajyjs.cn 前言 以前一直有录屏的需求,但苦于自带的QuickTime 无法录制内屏声音,一直使用的是第三方的app.近期开腾讯会议需要录屏,但主持人本身没有开启录屏权限,只好 ...
- Redis:学习笔记-04
Redis:学习笔记-04 该部分内容,参考了 bilibili 上讲解 Redis 中,观看数最多的课程 Redis最新超详细版教程通俗易懂,来自 UP主 遇见狂神说 10. Redis主从复制 1 ...
- Python使用阿里云OSS服务
Python使用阿里云OSS服务 前言: 在远程搭建了一个平台,通过改远程平台进行数据的采集,需要将数据内容传送至本地进行处理:为了实现该功能,考虑了阿里云的OSS对象储存的服务. 40G包月只需1元 ...
- 技术博客--微信小程序canvas实现图片编辑
技术博客--微信小程序canvas实现图片编辑 我们的这个小程序不仅仅是想给用户提供一个保存和查找的平台,还希望能给用户一个展示自己创意的舞台,因此我们实现了图片的编辑部分.我们对对图片的编辑集成了很 ...
- spring cloud zuul的回退
当我们使用 @EnableZuulProxy 注解来开启zuul的路由时,默认在@EnableZuulProxy注解上就包含了@EnableCircuitBreaker注解,即开启了断路器功能.那么在 ...
- 洛谷 P5658 [CSP-S2019] 括号树
链接: P5658 分析: 显然我们应该在dfs树的同时维护每个点的答案. 注意到第 \(u\) 个点的答案可以分成两部分,不包含 \(u\) 点时的答案,和加入 \(u\) 点后新增的答案,前者可以 ...
- 助你上手Vue3全家桶之VueX4教程
目录 1,前言 2,State 2.1,直接使用 2.2,结合computed 3,Getter 3.1,直接使用 3.2,结合computed 4,Mutation 4.1,直接使用 4.2,结合c ...
- 《手把手教你》系列技巧篇(三十六)-java+ selenium自动化测试-单选和多选按钮操作-番外篇(详解教程)
1.简介 前边几篇文章是宏哥自己在本地弄了一个单选和多选的demo,然后又找了网上相关联的例子给小伙伴或童鞋们演示了一下如何自动化测试,这一篇宏哥在网上找了一个问卷调查,给小伙伴或童鞋们来演示一下.上 ...