
Python爬虫教程-实现百度翻译
使用python爬虫实现百度翻译功能
python爬虫实现百度翻译: python解释器【模拟浏览器】,发送【post请求】,传入待【翻译的内容】作为参数,获取【百度翻译的结果】
通过开发者工具,获取发送请求的地址
提示: 翻译内容发送的请求地址,绝对不是打开百度翻译的那个地址,想要抓取地址,就要借助【浏览器的开发者工具】,或者其他抓包工具
下面介绍获取请求地址的具体方法
以Chrome为例
打开百度翻译:http://fanyi.baidu.com/
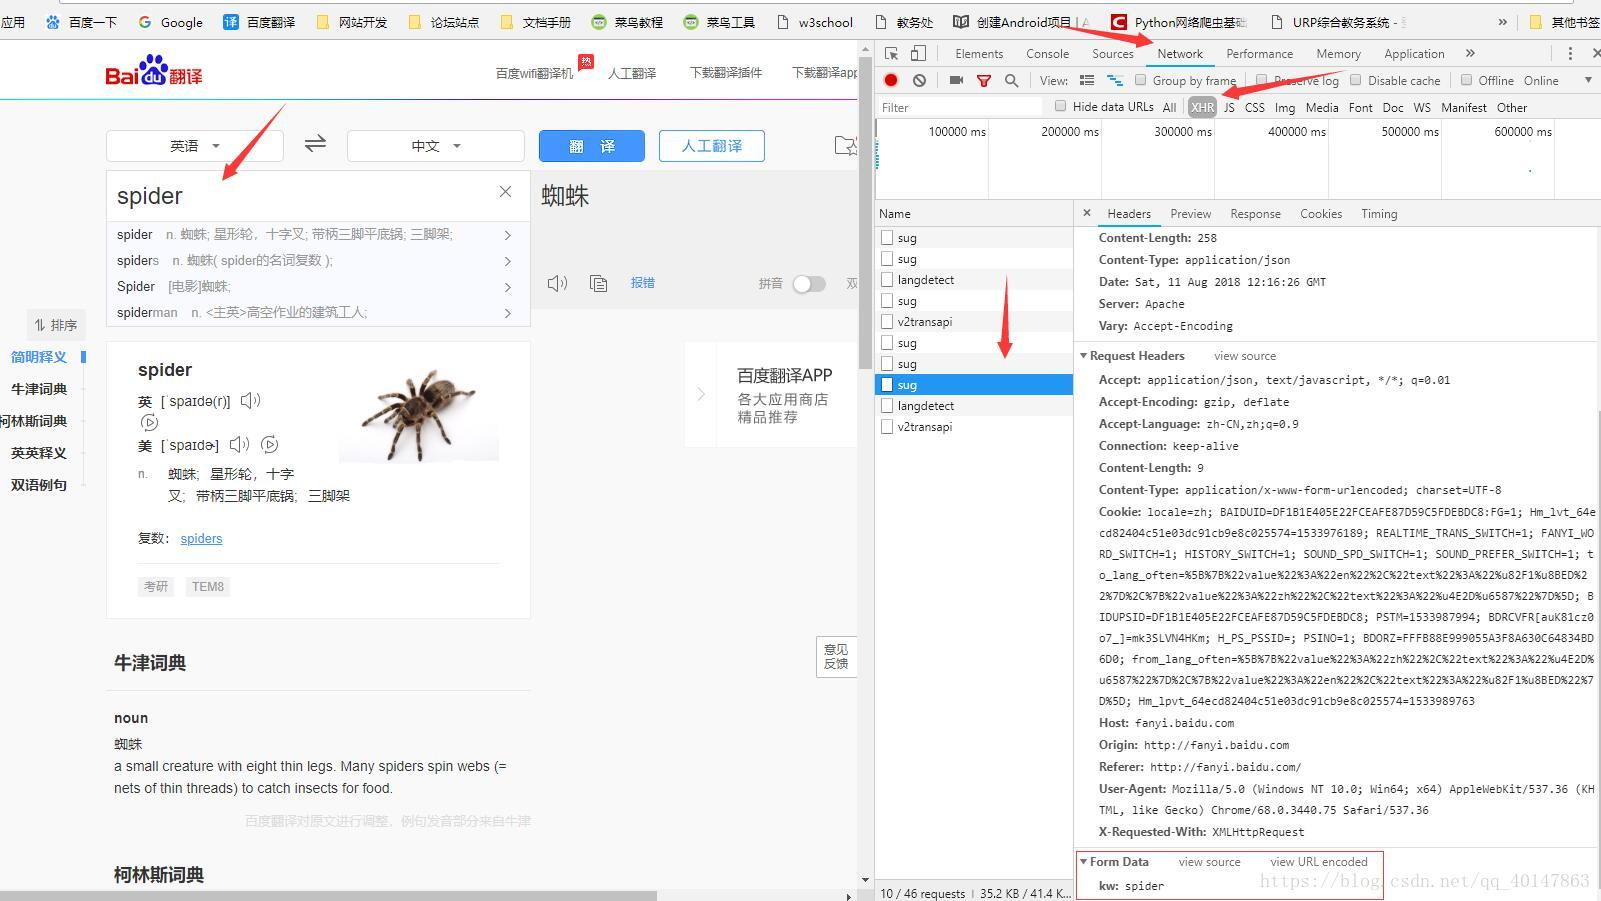
【点击右键】>【检查】>【network】(如果是火狐浏览器,点击【网络】)
点击【XHR】项,(有些需要刷新,有些异步的请求不需要刷新)
在页面【输入翻译的词汇】
在XHR项下,查找包含【输入需要翻译的词汇】的请求
查看请求的参数,需要【点击请求】>【Headers】>最下面的【Form Data】
(这里有一个坑:我们会发现有多个sug项,其实是因为百度翻译只要每输入一个字母就会发送一次请求,所以虽然多个请求的地址都是一样的,但是只有最后一个sug项的参数才是最后的词汇)
操作截图 :
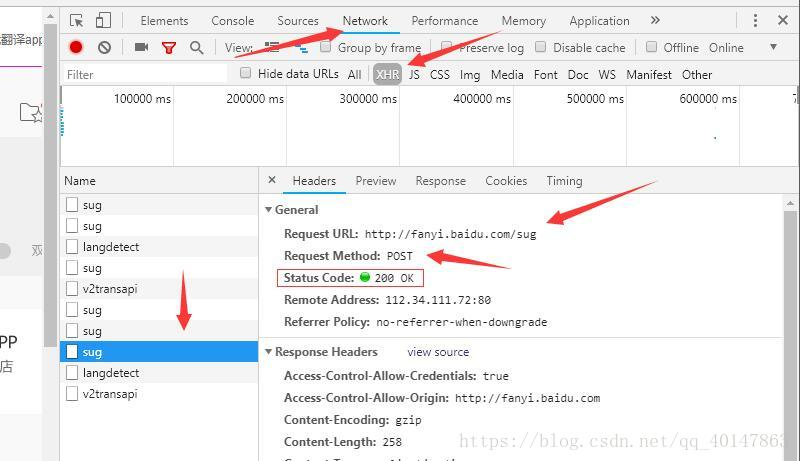
请求地址在这里
献上实现的代码
直接上代码,具体步骤下载注释上了
不会配置环境,安装python的包,请参考下一篇:
https://i-beta.cnblogs.com/posts/edit-done;postId=11945465
py05bdfanyi.py文件:https://xpwi.github.io/py/py%E7%88%AC%E8%99%AB/py05bdfanyi.py
 # python爬虫实现百度翻译

 # urllib和request POST参数提交

 # 缺少包请自行查看之前的笔记

 from urllib import request,parse

 import json

 def fanyi(keyword):

     base_url = 'http://fanyi.baidu.com/sug'

     # 构建请求对象

     data = {

         'kw': keyword

     }

     data = parse.urlencode(data)

     # 模拟浏览器

     header = {"User-Agent": "mozilla/4.0 (compatible; MSIE 5.5; Windows NT)"}

     req = request.Request(url=base_url,data=bytes(data,encoding='utf-8'),headers=header)

     res = request.urlopen(req)

     # 获取响应的json字符串

     str_json = res.read().decode('utf-8')

     # 把json转换成字典

     myjson = json.loads(str_json)

     info = myjson['data'][0]['v']

     print(info)

 if __name__=='__main__':

     while True:

         keyword = input('请输入翻译的单词:')

         if keyword == 'q':

             break

         fanyi(keyword)
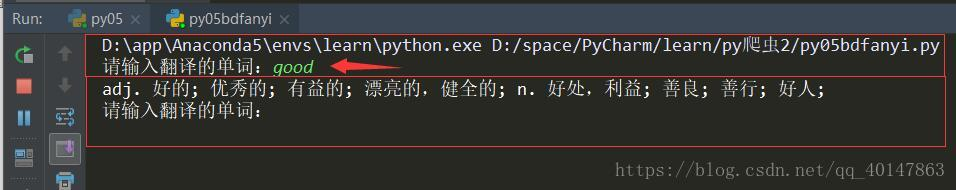
代码运行
如果还有问题未能得到解决,搜索887934385交流群,进入后下载资料工具安装包等。最后,感谢观看!
Python爬虫教程-实现百度翻译的更多相关文章
- Python爬虫爬取百度翻译之数据提取方法json
工具:Python 3.6.5.PyCharm开发工具.Windows 10 操作系统 说明:本例为实现输入中文翻译为英文的小程序,适合Python爬虫的初学者一起学习,感兴趣的可以做英文翻译为中文的 ...
- python --爬虫--爬取百度翻译
import requestsimport json class baidufanyi: def __init__(self, trans_str): self.lang_detect_url = ' ...
- Python爬虫教程-08-post介绍(百度翻译)(下)
Python爬虫教程-08-post介绍(下) 为了更多的设置请求信息,单纯的通过urlopen已经不太能满足需求,此时需要使用request.Request类 构造Request 实例 req = ...
- Python爬虫教程-07-post介绍(百度翻译)(上)
Python爬虫教程-07-post介绍(百度翻译)(上) 访问网络两种方法 get: 利用参数给服务器传递信息 参数为dict,使用parse编码 post :(今天给大家介绍的post) 一般向服 ...
- Python爬虫教程-06-爬虫实现百度翻译(requests)
使用python爬虫实现百度翻译(requests) python爬虫 上一篇介绍了怎么使用浏览器的[开发者工具]获取请求的[地址.状态.参数]以及使用python爬虫实现百度翻译功能[urllib] ...
- Python爬虫教程-16-破解js加密实例(有道在线翻译)
python爬虫教程-16-破解js加密实例(有道在线翻译) 在爬虫爬取网站的时候,经常遇到一些反爬虫技术,比如: 加cookie,身份验证UserAgent 图形验证,还有很难破解的滑动验证 js签 ...
- Python爬虫教程-01-爬虫介绍
Spider-01-爬虫介绍 Python 爬虫的知识量不是特别大,但是需要不停和网页打交道,每个网页情况都有所差异,所以对应变能力有些要求 爬虫准备工作 参考资料 精通Python爬虫框架Scrap ...
- Python爬虫教程-00-写在前面
鉴于好多人想学Python爬虫,缺没有简单易学的教程,我将在CSDN和大家分享Python爬虫的学习笔记,不定期更新 基础要求 Python 基础知识 Python 的基础知识,大家可以去菜鸟教程进行 ...
- 简单的python爬虫教程:批量爬取图片
python编程语言,可以说是新型语言,也是这两年来发展比较快的一种语言,而且不管是少儿还是成年人都可以学习这个新型编程语言,今天南京小码王python培训机构变为大家分享了一个python爬虫教程. ...
随机推荐
- java基础 - 泛型的使用
泛型的使用方式有泛型类,泛型接口,泛型方法. 泛型的意思是把参数类型也当成参数传入,也就是在使用时(类实例化或调用方法时)传入类型. 泛型类 在实例化时传入参数类型,不能对泛型类使用instancec ...
- Github(第一次尝试)
重要提示:项目中的文件最好最好不要出现中文,尤其是复杂的中文文件名. 前提:本地已经用git 管理 一个测试项目(项目一),分支为master. 1.注册 github: http://git.osc ...
- mysql数据库多表查询where与内连接inner join的区别
按理说where是对前面的笛卡尔积进行过滤,工作量大增,inner join则不会.但我实际测试了一下,两种查询耗时基本相等,甚至where还快一些,多次测试后基本如此. 如下图: where: in ...
- 上手OrangePi Zero+
一.安装系统 所需材料:系统镜像文件.镜像烧录工具.至少2G的内存卡(推荐8G以上).读卡器 1.下载系统镜像 官方系统下载地址,由于官方系统更新截止到17年,所以我选择的是Armbian系统.下载地 ...
- gmail 批量删除邮件
前几天我在 github上 star 了一下 angular 项目,然后8,9 天的时间收到了很多邮件,起初我没注意看具体数量,直接全选-删除.结果删了 3,4 页了还有很多.再仔细一看,一万多封邮件 ...
- 最强Linux shell工具Oh My Zsh 指南
引言 笔者已经使用zsh一年多了,发现这个东东的功能太强大了.接下来,给大家推荐一下. 以下是oh-my-zsh部分功能 命令验证 在所有正在运行的shell中共享命令历史记录 拼写纠正 主题提示(A ...
- 转载-Archunit的使用
Archunit的使用 注:开发的编辑器: Intellij Idea,JDK版本是JDK8 Archunit是什么,官网的英文介绍很好,建议阅读原文,"ArchUnit is a ...
- go源码解析-Println的故事
本文主要通过平常常用的go的一个函数,深入源码,了解其底层到底是如何实现的. Println Println函数接受参数a,其类型为-interface{}.用过Java的对这个应该比较熟悉,Java ...
- Jupyter Notebook 使用小记
简介 Jupyter Notebook 是一款几乎综合所有编程语言,能够把软件代码.计算输出.解释文档.多媒体资源整合在一起的多功能科学计算平台.具有如下优点: 整合所有资源 交互性编程体验 零成本重 ...
- 双链表算法原理【Java实现】(八)
前言 前面两节内容我们详细介绍了ArrayList,一是手写实现ArrayList数据结构,而是通过分析ArrayList源码看看内置实现,关于集合内容一如既往,本节课我们继续学习集合LinkedLi ...