
将scrapy爬取数据通过django入到SQLite数据库
1. 在django项目根目录位置创建scrapy项目,django_12是django项目,ABCkg是scrapy爬虫项目,app1是django的子应用
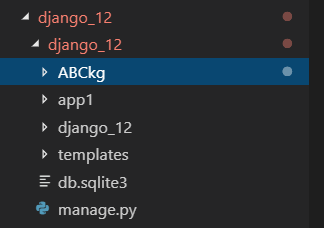
2.在Scrapy的settings.py中加入以下代码
import os

import sys

sys.path.append(os.path.dirname(os.path.abspath('.')))

os.environ['DJANGO_SETTINGS_MODULE'] = 'django_12.settings'    # 项目名.settings

import django

django.setup()
3.编写爬虫,下面代码以ABCkg为例,abckg.py
# -*- coding: utf-8 -*-

import scrapy

from ABCkg.items import AbckgItem

class AbckgSpider(scrapy.Spider):

    name = 'abckg'   #爬虫名称

    allowed_domains = ['www.abckg.com'] # 允许爬取的范围

    start_urls = ['http://www.abckg.com/'] # 第一次请求的地址

    def parse(self, response):

        print('返回内容:{}'.format(response))

        """

        解析函数

        :param response: 响应内容

        :return:

        """

        listtile = response.xpath('//*[@id="container"]/div/div/h2/a/text()').extract()

        listurl = response.xpath('//*[@id="container"]/div/div/h2/a/@href').extract()

        for index in range(len(listtile)):

            item = AbckgItem()

            item['title'] = listtile[index]

            item['url'] = listurl[index]

            yield scrapy.Request(url=listurl[index],callback=self.parse_content,method='GET',dont_filter=True,meta={'item':item})

        # 获取下一页

        nextpage = response.xpath('//*[@id="container"]/div[1]/div[10]/a[last()]/@href').extract_first()

        print('即将请求:{}'.format(nextpage))

        yield scrapy.Request(url=nextpage,callback=self.parse,method='GET',dont_filter=True)

        # 获取详情页

    def parse_content(self,response):

        item = response.meta['item']

        item['content'] = response.xpath('//*[@id="post-1192"]/dd/p').extract()

        print('内容为:{}'.format(item))

        yield item
4.scrapy中item.py 中引入django模型类
pip install scrapy-djangoitem
from app1 import models

from scrapy_djangoitem import DjangoItem

class AbckgItem(DjangoItem):

    # define the fields for your item here like:

    # name = scrapy.Field()           # 普通scrapy爬虫写法

    # title = scrapy.Field()

    # url = scrapy.Field()

    # content = scrapy.Field()

    django_model = models.ABCkg     # 注入django项目的固定写法,必须起名为django_model  =django中models.ABCkg表
5.pipelines.py中调用save()
import json

from pymongo import MongoClient

# 用于接收parse函数发过来的item

class AbckgPipeline(object):

    # i = 0

    def open_spider(self,spider):

        # print('打开文件')

        if spider.name == 'abckg':

            self.f = open('abckg.json',mode='w')

    def process_item(self, item, spider):

        # # print('ABC管道接收:{}'.format(item))

        # if spider.name == 'abckg':

        #     self.f.write(json.dumps(dict(item),ensure_ascii=False))

        # # elif spider.name == 'cctv':

        # #     img = requests.get(item['img'])

        # #     if img != '':

        # #         with open('图片\%d.png'%self.i,mode='wb')as f:

        # #             f.write(img.content)

        # #     self.i += 1

        item.save()

        return item    # 将item传给下一个管道执行

    def close_spider(self,spider):

        # print('关闭文件')

        self.f.close()
6.在django中models.py中一个模型类,字段对应爬取到的数据,选择适当的类型与长度
class ABCkg(models.Model):

    title = models.CharField(max_length=30,verbose_name='标题')

    url = models.CharField(max_length=100,verbose_name='网址')

    content = models.CharField(max_length=200,verbose_name='内容')

    class Meta:

        verbose_name_plural = '爬虫ABCkg'

    def __str__(self):

        return self.title
7.通过命令启动爬虫:scrapy crawl 爬虫名称
8.django进入admin后台即可看到爬取到的数据。
将scrapy爬取数据通过django入到SQLite数据库的更多相关文章
- 如何提升scrapy爬取数据的效率
在配置文件中修改相关参数: 增加并发 默认的scrapy开启的并发线程为32个,可以适当的进行增加,再配置文件中修改CONCURRENT_REQUESTS = 100值为100,并发设置成了为100. ...
- scrapy爬取数据的基本流程及url地址拼接
说明:初学者,整理后方便能及时完善,冗余之处请多提建议,感谢! 了解内容: Scrapy :抓取数据的爬虫框架 异步与非阻塞的区别 异步:指的是整个过程,中间如果是非阻塞的,那就是异步 ...
- python之scrapy爬取数据保存到mysql数据库
1.创建工程 scrapy startproject tencent 2.创建项目 scrapy genspider mahuateng 3.既然保存到数据库,自然要安装pymsql pip inst ...
- 42.scrapy爬取数据入库mongodb
scrapy爬虫采集数据存入mongodb采集效果如图: 1.首先开启服务切换到mongodb的bin目录下 命令:mongod --dbpath e:\data\db 另开黑窗口 命令:mongo. ...
- scrapy爬取数据进行数据库存储和本地存储
今天记录下scrapy将数据存储到本地和数据库中,不是不会写,因为小编每次都写觉得都一样,所以记录下,以后直接用就可以了-^o^- 1.本地存储 设置pipel ines.py class Ak17P ...
- scrapy爬取数据保存csv、mysql、mongodb、json
目录 前言 Items Pipelines 前言 用Scrapy进行数据的保存进行一个常用的方法进行解析 Items item 是我们保存数据的容器,其类似于 python 中的字典.使用 item ...
- 信息技术手册可视化进度报告 基于BeautifulSoup框架的python3爬取数据并连接保存到MySQL数据库
老师给我们提供了一个word文档,里面是一份信息行业热词解释手册,要求我们把里面的文字存进数据库里面,然后在前台展示出来. 首先面临的问题是怎么把数据导进MySQL数据库,大家都有自己的方法,我采用了 ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 爬虫必知必会(6)_提升scrapy框架爬取数据的效率之配置篇
如何提升scrapy爬取数据的效率:只需要将如下五个步骤配置在配置文件中即可 增加并发:默认scrapy开启的并发线程为32个,可以适当进行增加.在settings配置文件中修改CONCURRENT_ ...
随机推荐
- Github访问速度很慢的原因,以及解决方法
1,CDN,Content Distribute Network,可以直译成内容分发网络,CDN解决的是如何将数据快速可靠从源站传递到用户的问题.用户获取数据时,不需要直接从源站获取,通过CDN对于数 ...
- ORA-14061: 不能更改索引分区列的数据类型或长度
修改分区表主键时报错: 在行: 2 上开始执行命令时出错 -alter table KC23 modify AAZ210 VARCHAR2(50)错误报告 -SQL 错误: ORA-14061: 不能 ...
- C#中巧用妙法避免嵌套方式使用两个foreach循环
问题:需要对DataGridViewRow的下拉框列Item2所选内容进行判断,看是否跟数据库里面某个配置表的数据列Item1匹配.如果用两个foreach循环进行匹配,会导致逻辑复杂而且容易只bre ...
- 线上cpu使用率过高解决方案
一个应用占用CPU很高,除了确实是计算密集型应用之外,通常原因都是出现了死循环. 下面我们将一步步定位问题,详尽的介绍每一步骤的相关知识. 一.通过top命令定位占用cpu高的进程 执行top命令得到 ...
- RN调试坑点总结(不定期更新)
前言 我感觉,如果模拟器是个人的话,我已经想打死他了 大家不要催我学flutter啦,哈哈哈,学了后跟大家分享下 RN报错的终极解决办法 众所周知,RN经常遇到无可奈何的超级Bug, 那么对于这些问题 ...
- github用户注册和仓库创建
访问github官网:https://github.com/,点击注册进入注册页面 输入用户名,电子邮箱和密码后点击下一步 邮箱验证,收到github的验证邮箱,打开后点击验证 选择个人计划 创建仓库 ...
- JavaScript -- 筑基
本片博客记录了我JavaScript筑基阶段的学习内容,JavaScript不是Java,但是我下意识的把它和java对比学习,有些地方比较有趣,有些地方从java角度看,简直匪夷所思,不过现在总体感 ...
- InfluxDB从原理到实战 - 一篇文章搞懂InfluxDB时区
0x00 简介 InfluxDB默认以UTC时间存储并返回时间戳,当接收到一个时序数据记录时,InfluxDB将时间戳从本地时区时间转换为UTC时间并存储,查询时,InfluxDB返回的时间戳对 ...
- 对python中等值和大小比较
等值.大小比较 在python中,只要两个对象的类型相同,且它们是内置类型(字典除外),那么这两个对象就能进行比较.关键词:内置类型.同类型.所以,两个对象如果类型不同,就没法比较,比如数值类型的数值 ...
- Python爬虫,你是否真的了解它?
程序员有时候很难和外行人讲明白自己的工作是什么,甚至有些时候,跟同行的人讲清楚“你是干什么的”也很困难.比如我自己,就对Daivd在搞的语义网一头雾水.所以我打算写一篇博客,讲一下“爬虫工程师”的工作 ...