
scrapy爬取数据的基本流程及url地址拼接
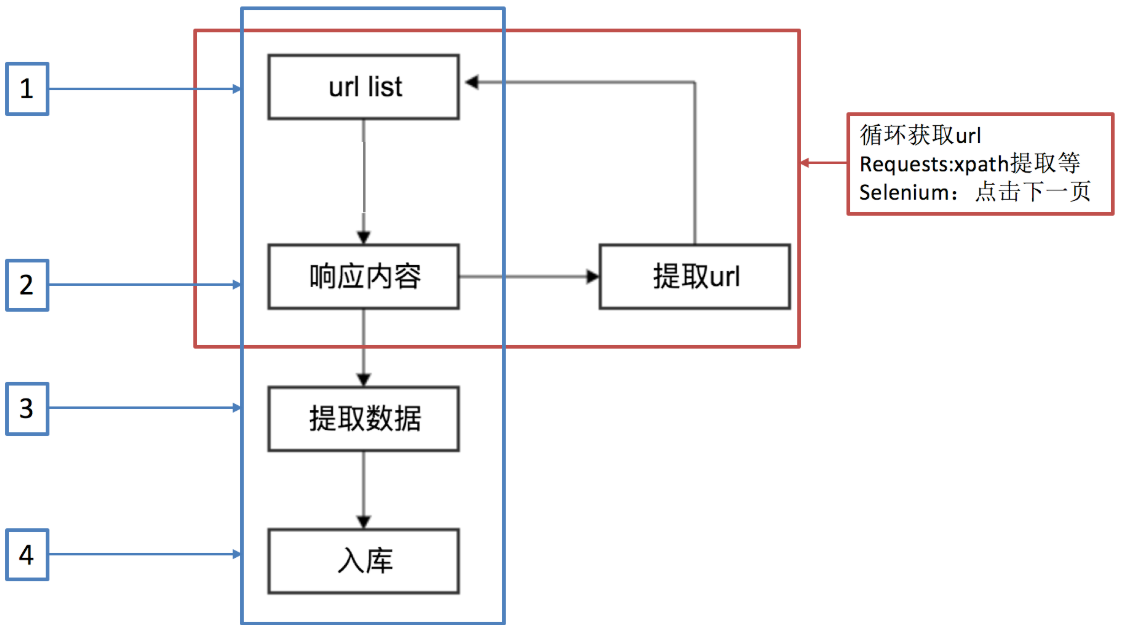
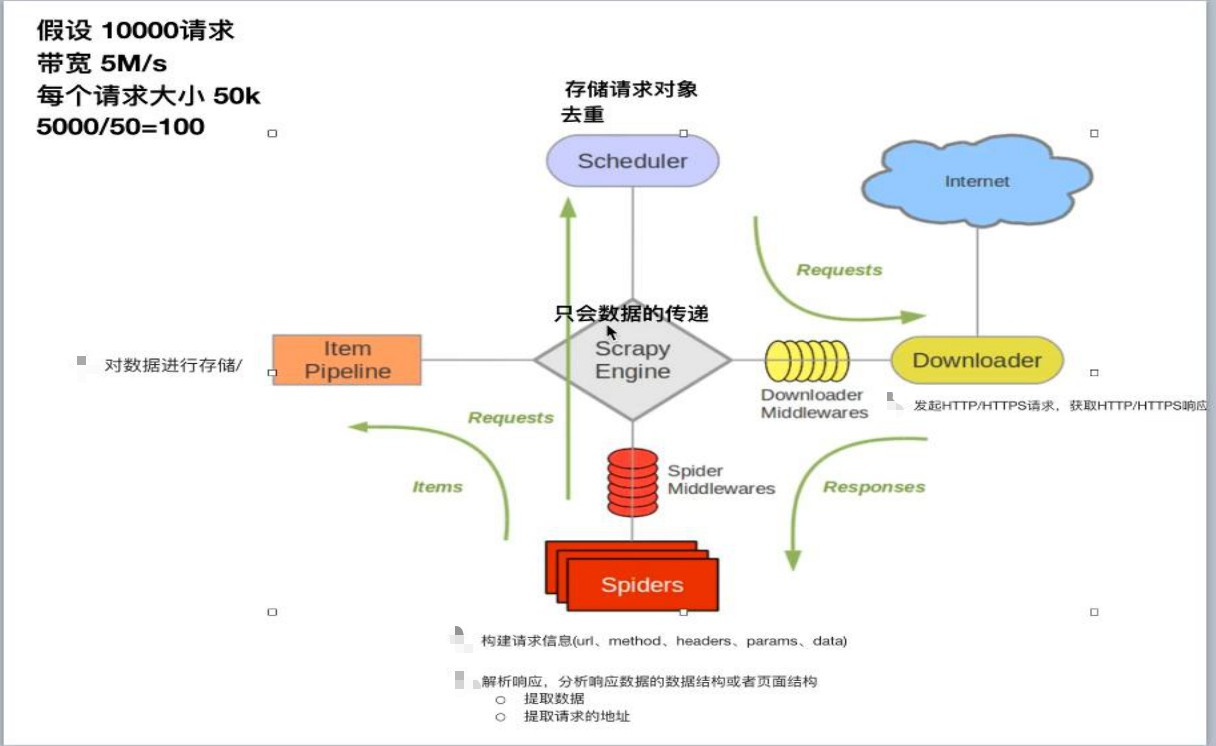
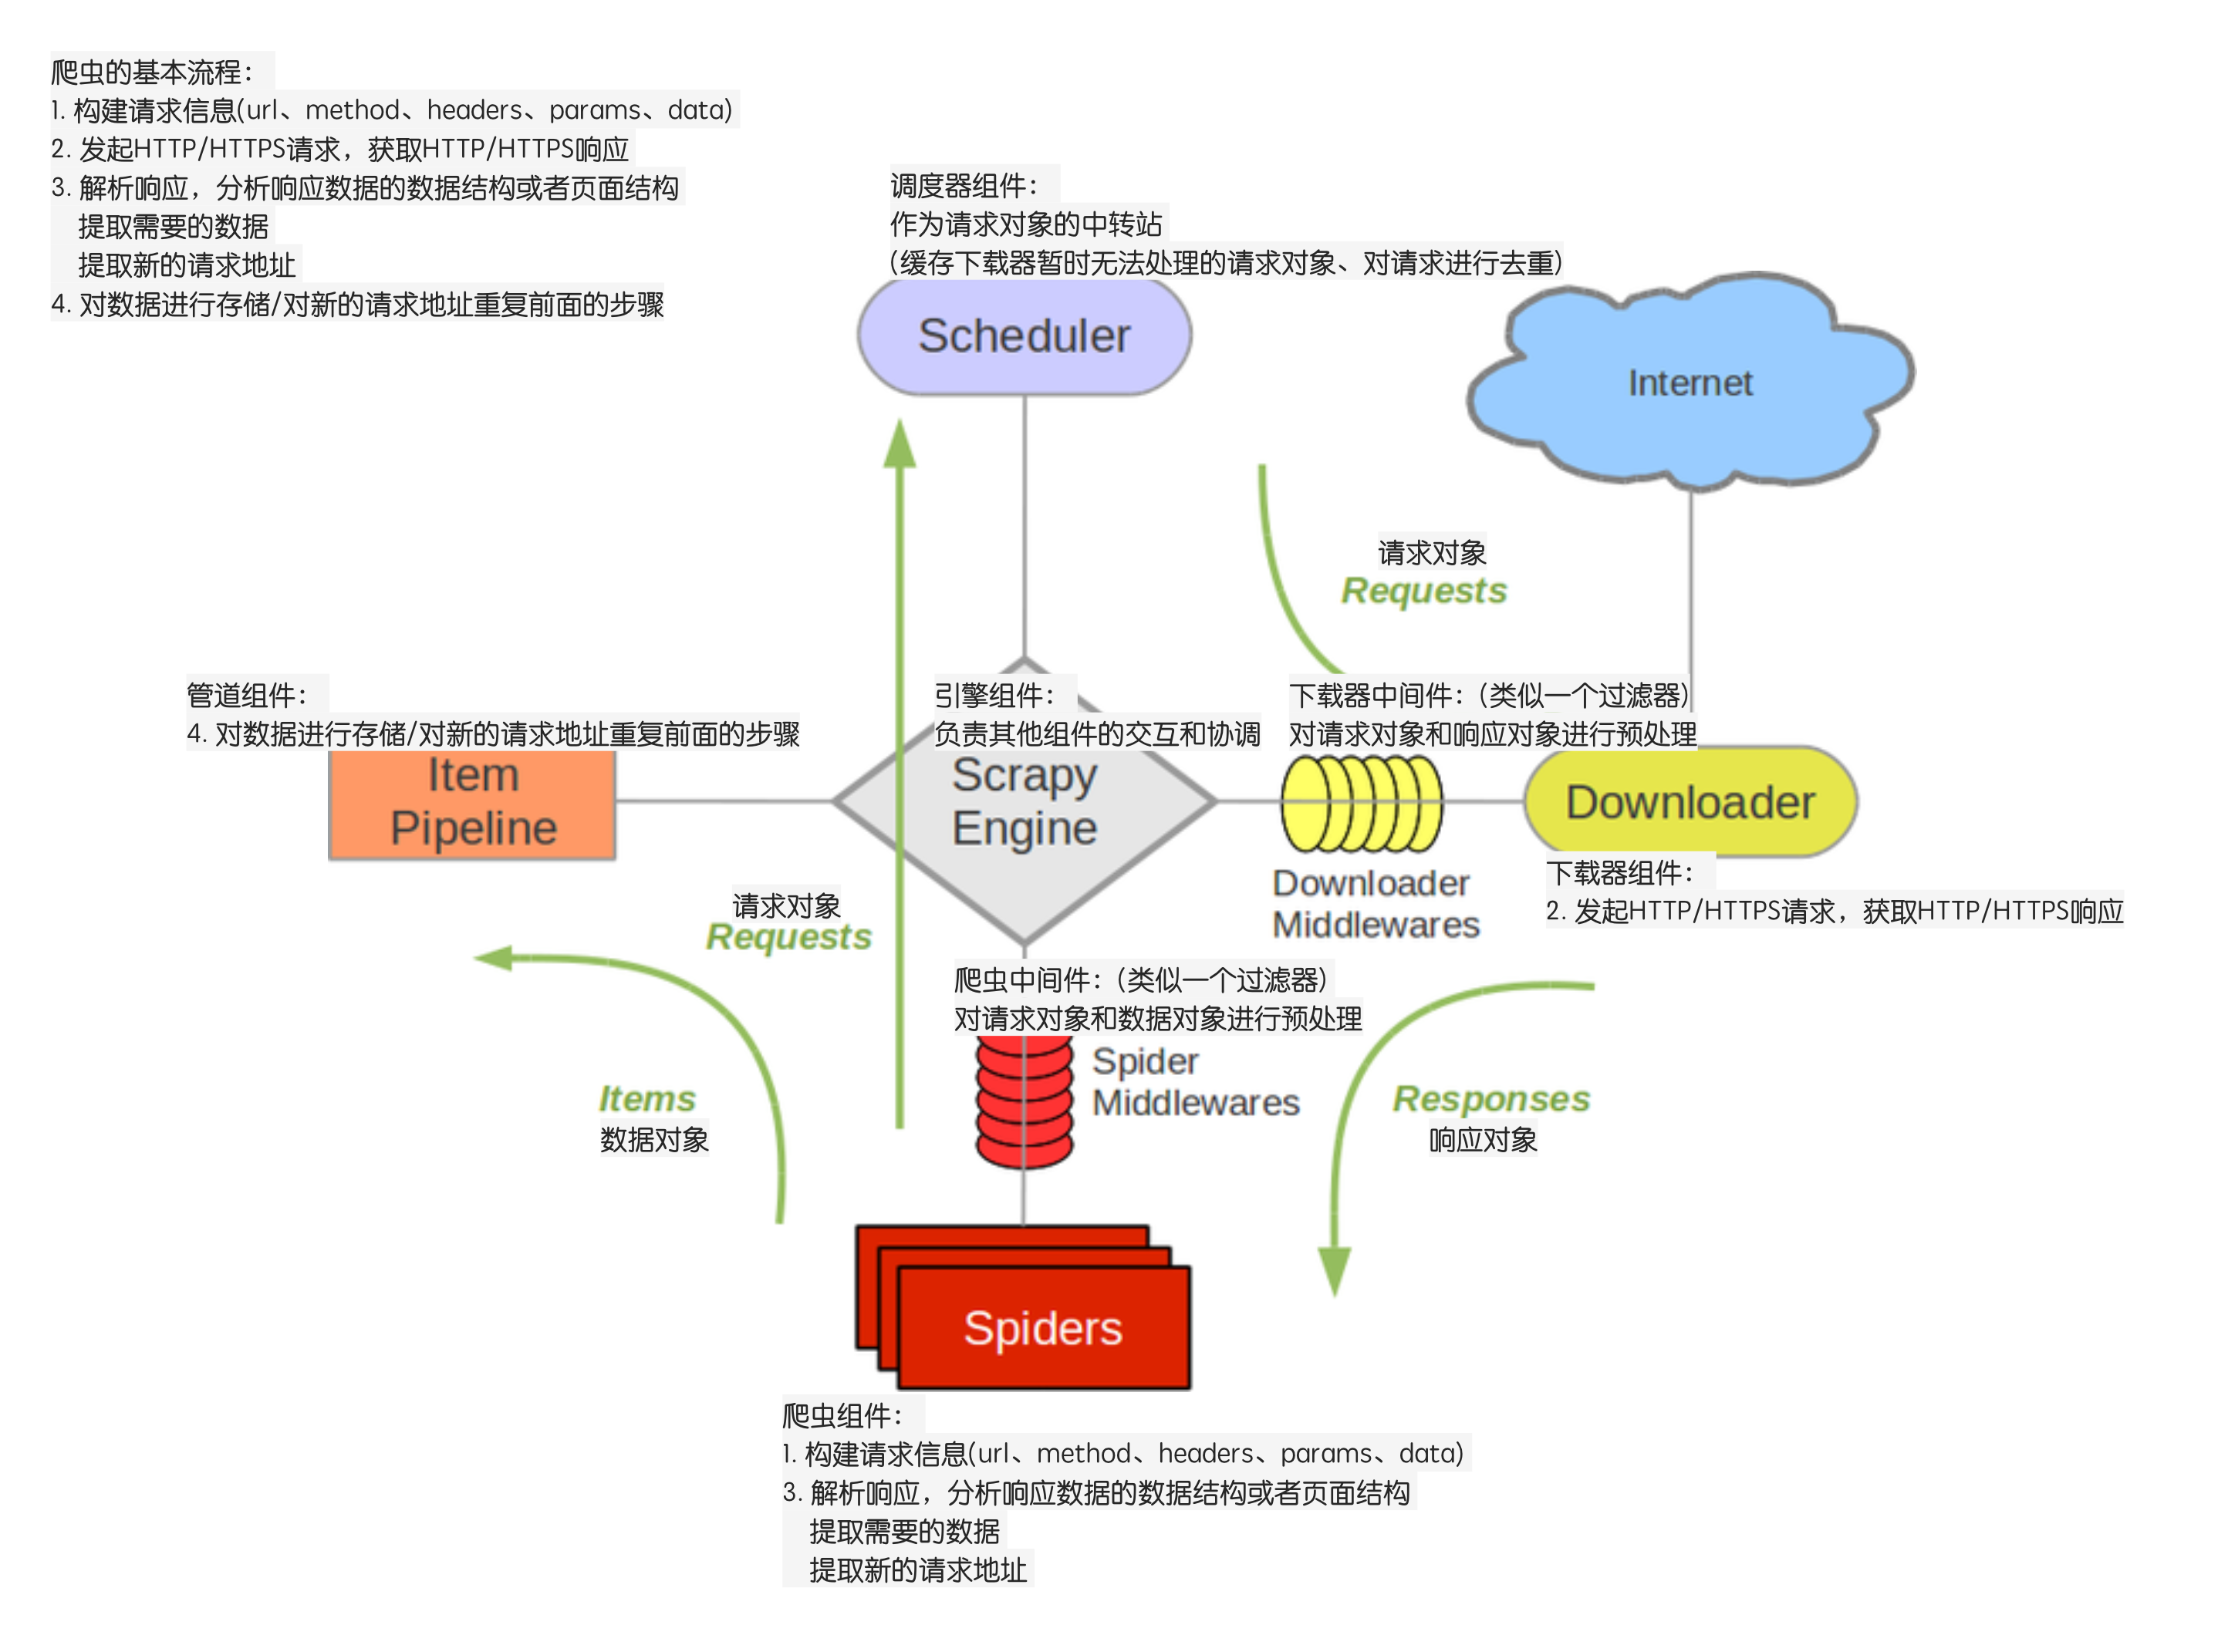
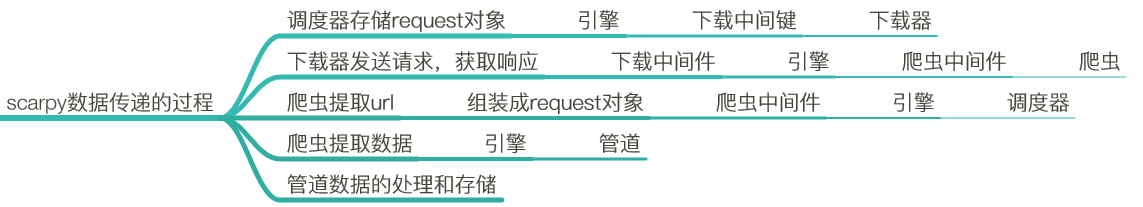
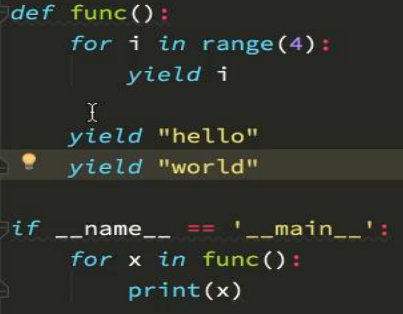

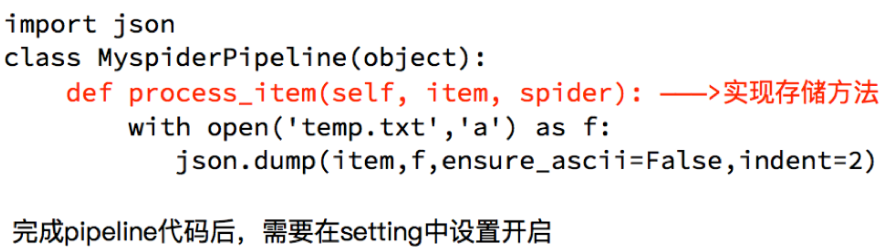
上面的代码应该改成:yield item
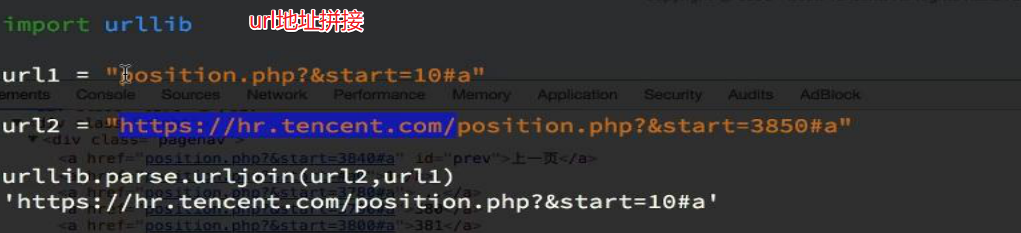
#主站链接 用来拼接

    base_site = 'https://www.jpdd.com'

def parse(self,response):

    book_urls = response.xpath('//table[@class="p-list"]//a/@href').extract()

    for book_url in book_urls:

         url = self.base_site + book_url

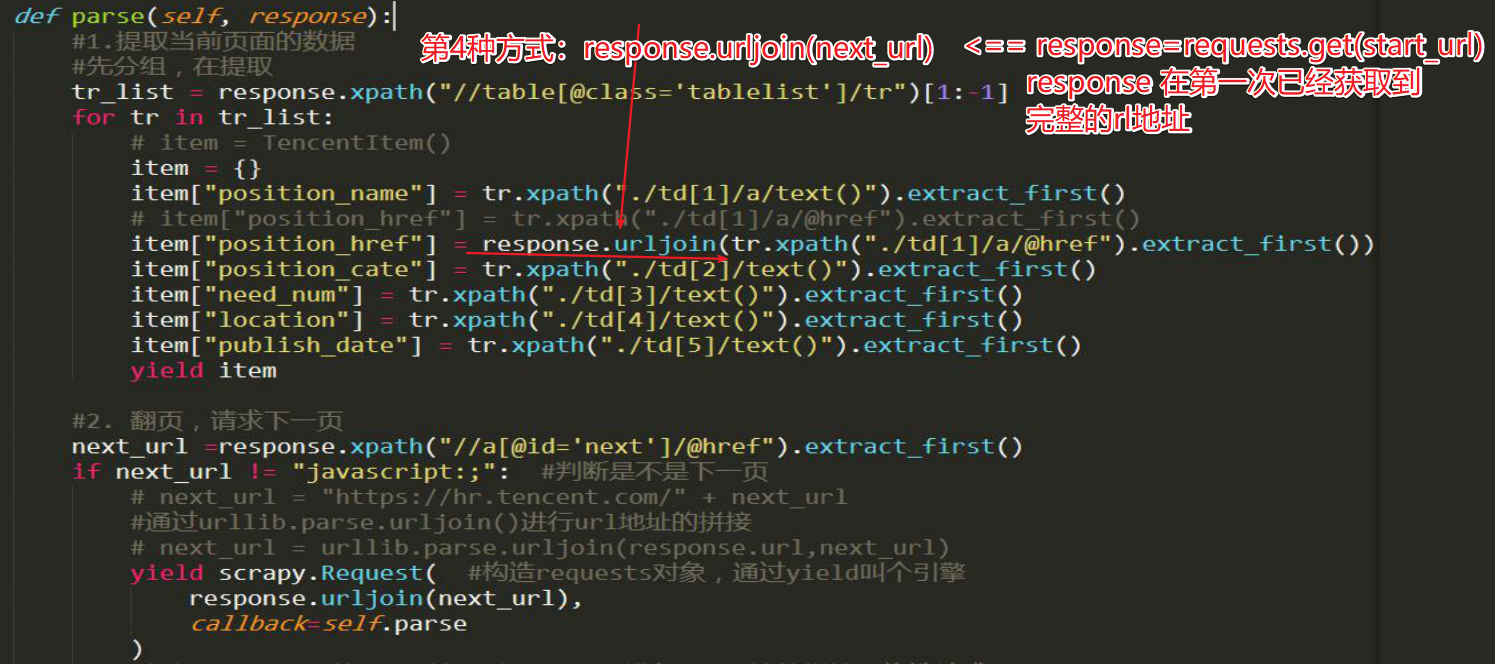
         yield scrapy.Request(url, callback=self.getInfo)

    #获取下一页

    next_page_url = self.base_site + response.xpath(

            '//table[@class="p-name"]//a[contains(text(),"下一页")]/@href'

            ).extract()[0]

    yield scrapy.Request(next_page_url, callback=self.parse)
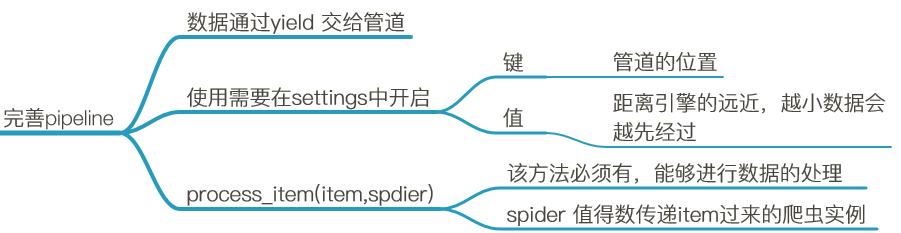
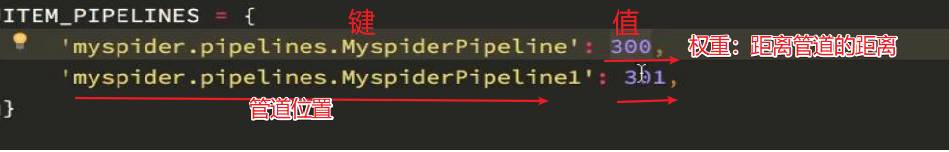
------数字越小,表示离引擎越近,数据越先经过处理,反之 。
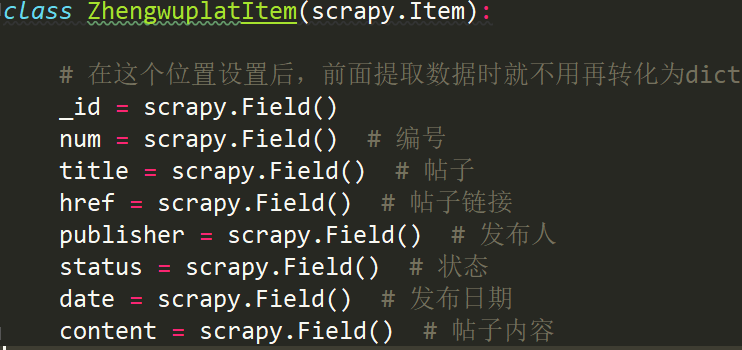
    from yanguan.items import YanguanItem

    item = YanguanItem() #实例化
参数说明:
括号中的参数为可选参数
callback:表示当前的url的响应交给哪个函数去处理
meta:实现数据在不同的解析函数中传递,meta默认带有部分数据,比如下载延迟,请求深度等
dont_filter:默认会过滤请求的url地址,即请求过的url地址不会继续被请求,对需要重复请求的url地址可以把它设置为Ture,比如贴吧的翻页请求,页面的数据总是在变化;start_urls中的地址会被反复请求,否则程序不会启动
scrapy爬取数据的基本流程及url地址拼接的更多相关文章
- 如何提升scrapy爬取数据的效率
在配置文件中修改相关参数: 增加并发 默认的scrapy开启的并发线程为32个,可以适当的进行增加,再配置文件中修改CONCURRENT_REQUESTS = 100值为100,并发设置成了为100. ...
- 将scrapy爬取数据通过django入到SQLite数据库
1. 在django项目根目录位置创建scrapy项目,django_12是django项目,ABCkg是scrapy爬虫项目,app1是django的子应用 2.在Scrapy的settings.p ...
- python之scrapy爬取数据保存到mysql数据库
1.创建工程 scrapy startproject tencent 2.创建项目 scrapy genspider mahuateng 3.既然保存到数据库,自然要安装pymsql pip inst ...
- 42.scrapy爬取数据入库mongodb
scrapy爬虫采集数据存入mongodb采集效果如图: 1.首先开启服务切换到mongodb的bin目录下 命令:mongod --dbpath e:\data\db 另开黑窗口 命令:mongo. ...
- scrapy爬取数据进行数据库存储和本地存储
今天记录下scrapy将数据存储到本地和数据库中,不是不会写,因为小编每次都写觉得都一样,所以记录下,以后直接用就可以了-^o^- 1.本地存储 设置pipel ines.py class Ak17P ...
- scrapy爬取数据保存csv、mysql、mongodb、json
目录 前言 Items Pipelines 前言 用Scrapy进行数据的保存进行一个常用的方法进行解析 Items item 是我们保存数据的容器,其类似于 python 中的字典.使用 item ...
- Python使用Scrapy框架爬取数据存入CSV文件(Python爬虫实战4)
1. Scrapy框架 Scrapy是python下实现爬虫功能的框架,能够将数据解析.数据处理.数据存储合为一体功能的爬虫框架. 2. Scrapy安装 1. 安装依赖包 yum install g ...
- 爬虫必知必会(6)_提升scrapy框架爬取数据的效率之配置篇
如何提升scrapy爬取数据的效率:只需要将如下五个步骤配置在配置文件中即可 增加并发:默认scrapy开启的并发线程为32个,可以适当进行增加.在settings配置文件中修改CONCURRENT_ ...
- 提高Scrapy爬取效率
1.增加并发: 默认scrapy开启的并发线程为32个,可以适当进行增加.在settings配置文件中修改CONCURRENT_REQUESTS = 100值为100,并发设置成了为100. 2.降低 ...
随机推荐
- maven GroupID和ArtifactID
GroupID是项目组织唯一的标识符,实际对应JAVA的包的结构,是main目录里java的目录结构. ArtifactID就是项目的唯一的标识符,实际对应项目的名称,就是项目根目录的名称.一般Gro ...
- jzyz集训 0612
今天闵神找的题,题目质量还算不错,就是有些偏套路了. 第一题:定义一个排列是合法当且仅当这个排列中不存在大于2的循环节,询问有多少长度为n的排列是合法的且B排列是该排列的子序列. 恩...这题目其实不 ...
- 《CSS权威指南(第三版)》---第二章 选择器
本章的主要内容是,怎么获取文档中的元素给予渲染: 1.元素选择器: 2.ID选择器: 3.CLSSS选择器: 4.通配选择器:*; 5.属性选择器:selector[] 6.部分属性选择器: sele ...
- ping: sendto: Network is unreachable【转】
本文转载自:http://blog.sina.com.cn/s/blog_640531380102wmzb.html 在我的板子上ping路由上的IP的时候可以ping通,但是ping外网的IP的时候 ...
- smokeping再次部署遇到的问题记录
问题1: Can't locate Sys/Syslog.pm in @INC (@INC contains: /opt/smokeping_workspace/thirdparty/lib/perl ...
- Centos6.4 相关配置记录
1.手动开启eth0网卡 在虚拟机里装完CentOS6.4之后,使用NAT模式,输入ifconfig发现没有IP地址,查找了一下资料,原来是: 在CentOS 6.x的版本中,默认网卡是不开启的,需要 ...
- Go丨语言对数据库操作报错 panic: dial tcp 127.0.0.1:3306: connectex: No connection could be made because the target machine actively refused it.
panic: dial tcp 127.0.0.1:3306: connectex: No connection could be made because the target machine ac ...
- cookie的保存与提取
爬虫过程中,cookie可以保留用户与服务器之间的交互信息,使服务器与用户相互能够识别.由于HTTP协议是无状态协议,即不能够识别客户端身份,即使客户端多次请求同一个url服务器仍然响应.这种协议导致 ...
- unity3d: how to display the obj behind the wall
透墙显示,遮挡显示,使用ztest Tags { "Queue"="Overlay+1" "RenderType"="Transp ...
- CodeForces - 884F :Anti-Palindromize(贪心&费用流)
A string a of length m is called antipalindromic iff m is even, and for each i (1 ≤ i ≤ m) ai ≠ am - ...