
Java使用Jsoup之爬取博客数据应用实例
导入Maven依赖
<!-- https://mvnrepository.com/artifact/org.jsoup/jsoup -->

    <dependency>

        <groupId>org.jsoup</groupId>

        <artifactId>jsoup</artifactId>

        <version>1.11.</version>

    </dependency>
选择你要爬取网站(这里我以爬取自己的博客文章为例)
通过浏览器进入这个网址
如我的博客
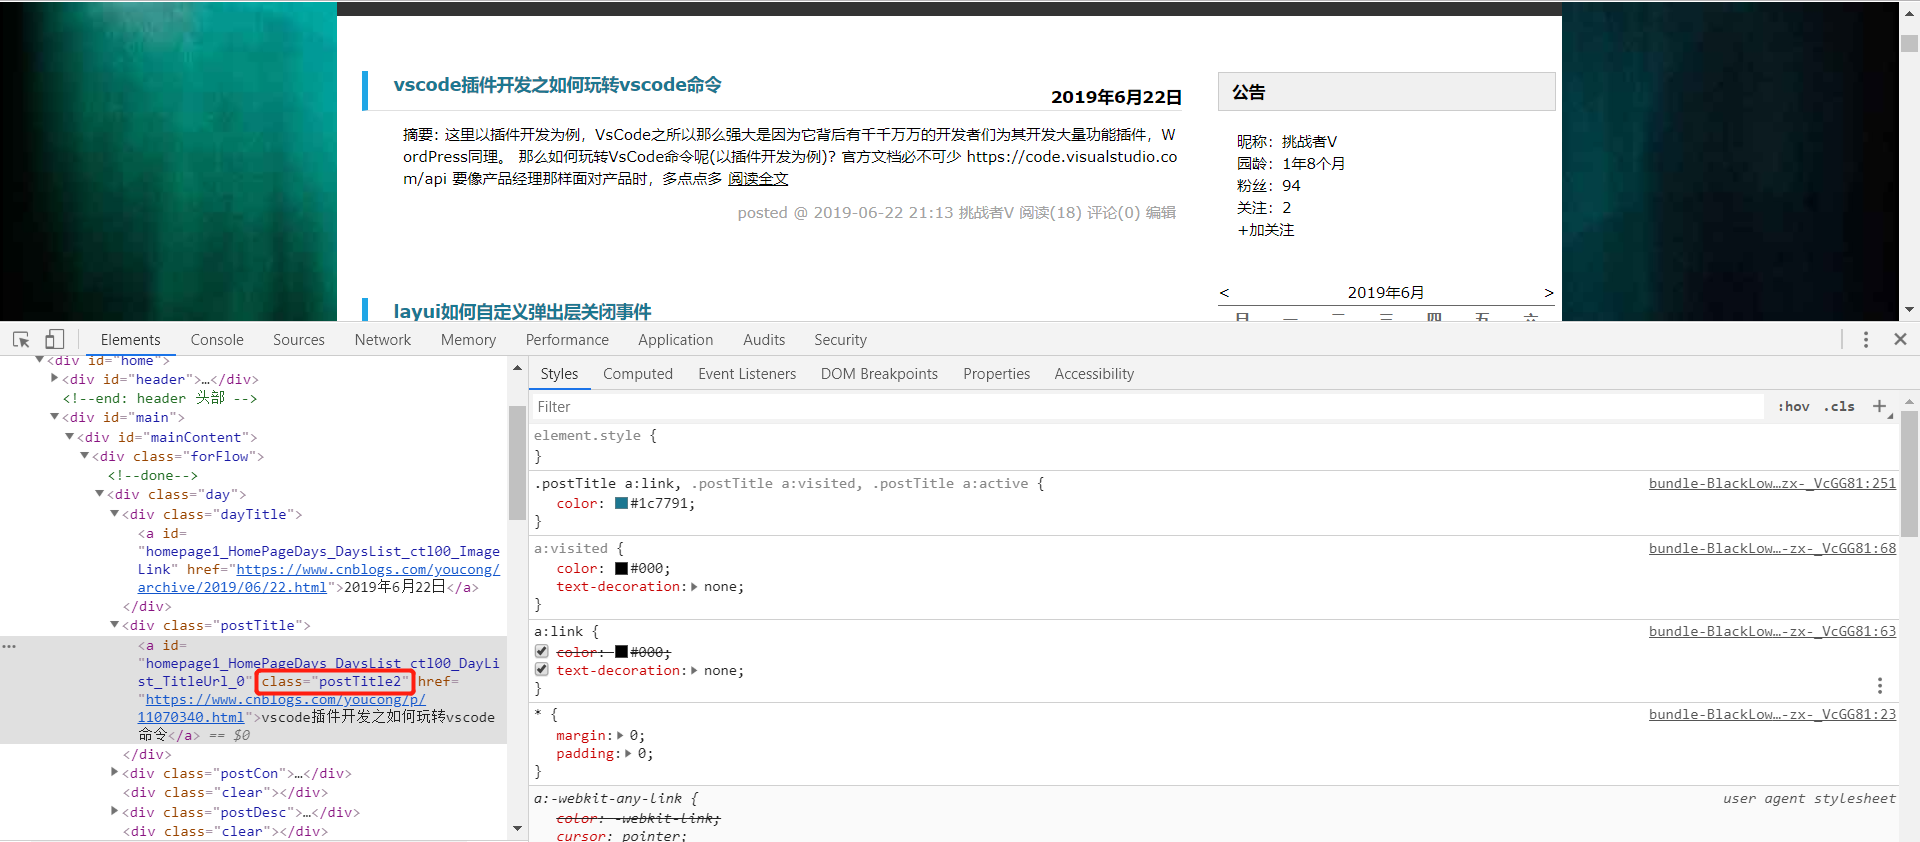
使用浏览器调试工具(后面会说到这个目的)
编写对应的Java的代码
package cn.test;

import org.jsoup.Connection;

import org.jsoup.Jsoup;

import org.jsoup.nodes.Document;

import org.jsoup.nodes.Element;

import org.jsoup.select.Elements;

import java.io.IOException;

import java.util.ArrayList;

import java.util.List;

/**

 * A simple example, used on the jsoup website.

 */

public class BlogJsoup {

    /**

     * 获取博客最近十篇文章

     * @param args

     * @throws IOException

     */

    public static void main(String[] args) throws IOException {

        Connection connection = Jsoup.connect("https://www.cnblogs.com/youcong/");

        connection.header("User-Agent", "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/52.0.2743.116 Safari/537.36");

        try {

            Document document = connection.timeout(100000).get();

            //包含所有列表的文章

            Elements elements = document.getElementsByClass("postTitle2");

            for (Element element : elements) {

                String path = element.attr("href");

                String text = element.text();

                String msg = text+" "+path;

                System.out.println(msg);

            }

        } catch (IOException e) {

            e.printStackTrace();

        }

}

}
上面的代码,用流程可以梳理为如下:
连接爬取的网站->设置浏览器请求头(防止因浏览器的限制导致爬取数据失败)->获取整个HTML(实际就是一个html)->选择HTML中的某一个元素(如类选择器postTitle2,如果不指定对应的元素选择器,那么直接爬取的就是整个HTML)->爬取数据并输出
输出结果如图:

Java使用Jsoup之爬取博客数据应用实例的更多相关文章
- python爬取博客圆首页文章链接+标题
新人一枚,初来乍到,请多关照 来到博客园,不知道写点啥,那就去瞄一瞄大家都在干什么好了. 使用python 爬取博客园首页文章链接和标题. 首先当然是环境了,爬虫在window10系统下,python ...
- 爬虫---lxml爬取博客文章
上一篇大概写了下lxml的用法,今天我们通过案例来实践,爬取我的博客博客并保存在本地 爬取博客园博客 爬取思路: 1.首先找到需要爬取的博客园地址 2.解析博客园地址 # coding:utf-8 i ...
- 使用JAVA爬取博客里面的所有文章
主要思路: 1.找到列表页. 2.找到文章页. 3.用一个队列来保存将要爬取的网页,爬取队头的url,如果队列非空,则一直爬取. 4.如果是列表页,则抽取里面所有的文章url进队:如果是文章页,则直接 ...
- Python开发爬虫之动态网页抓取篇:爬取博客评论数据——通过Selenium模拟浏览器抓取
区别于上篇动态网页抓取,这里介绍另一种方法,即使用浏览器渲染引擎.直接用浏览器在显示网页时解析 HTML.应用 CSS 样式并执行 JavaScript 的语句. 这个方法在爬虫过程中会打开一个浏览器 ...
- python 小爬虫爬取博客文章初体验
最近学习 python 走火入魔,趁着热情继续初级体验一下下爬虫,以前用 java也写过,这里还是最初级的爬取html,都没有用html解析器,正则等...而且一直在循环效率肯定### 很低下 imp ...
- (java)Jsoup爬虫学习--获取智联招聘(老网站)的全国java职位信息,爬取10页
Jsoup爬虫学习--获取智联招聘(老网站)的全国java职位信息,爬取10页,输出 职位名称*****公司名称*****职位月薪*****工作地点*****发布日期 import java.io.I ...
- Jsoup-基于Java实现网络爬虫-爬取笔趣阁小说
注意!仅供学习交流使用,请勿用在歪门邪道的地方!技术只是工具!关键在于用途! 今天接触了一款有意思的框架,作用是网络爬虫,他可以像操作JS一样对网页内容进行提取 初体验Jsoup <!-- Ma ...
- 【Android 我的博客APP】1.抓取博客首页文章列表内容——网页数据抓取
打算做个自己在博客园的博客APP,首先要能访问首页获取数据获取首页的文章列表,第一步抓取博客首页文章列表内容的功能已实现,在小米2S上的效果图如下: 思路是:通过编写的工具类访问网页,获取页面源代码, ...
- [js高手之路]Node.js实现简易的爬虫-抓取博客文章列表信息
抓取目标:就是我自己的博客:http://www.cnblogs.com/ghostwu/ 需要实现的功能: 抓取文章标题,超链接,文章摘要,发布时间 需要用到的库: node.js自带的http库 ...
随机推荐
- 获取form表单默认提交的返回值
1.经常用form表单提交的小伙伴有没有发现,form表单默认的提交是没有返回值的,而且默认提交成功之后是跳转,跳转的action的路径,下面写一下默认的提交如何获取到form表单的返回值json,并 ...
- webdriver切换frame的方法
iframe: iframe 就是一个特殊的html 元素, 它在原来的html 范围内,开辟了一个新的HTML. iframe 元素会创建包含另外一个文档的内联框架(即行内框架) 理解:网页嵌套网页 ...
- cpython多进程
四 同步\异步and阻塞\非阻塞(重点) 同步: #所谓同步,就是在发出一个功能调用时,在没有得到结果之前,该调用就不会返回.按照这个定义,其实绝大多数函数都是同步调用.但是一般而言,我们在说同步.异 ...
- jmeter的简单使用0723
一.添加http请求 1.右击线程组---添加---取样器---http请求,具体内容如下图所示.如果请求带参数,则要点击下方的添加按钮来添加参数 2.查看请求结果,同样右击线程组-添加---监听器- ...
- tac命令以及各种linux文件查看命令
有许多命令都可以查看文件,不同的命令有不同的优点,可以针对不同的需要分别选择命令以提高效率: cat 由第一行开始显示内容,并将所有内容输出 tac 从最后一行倒序显示内容 ...
- windows10 进入BIOS
windows10开机进入不了BIOS 原因 上网查了电脑固件所应该有的进入键,什么F1.F2.F12.Delete以及什么要配置Fn+F1...等等方法就是开机进入不了BIOS. 解决办法 最后发现 ...
- Matplotlib:mpl_toolkits.mplot3d工具包
简介 mpl_toolkits.mplot3d是Matplotlib里面专门用来画三维图的工具包,官方指南请点击此处<mplot3d tutorial> 使用 导入 使用from mpl_ ...
- HDU - 5823:color II (状压DP 反演DP)
题意:给定连通图,求出连通图的所有子图的颜色数. 一个图的颜色数,指最少的颜色数,给图染色,使得有边相邻的点之间颜色不同. 思路:首先想法是DFS枚举,然后计算颜色,发现对于给定图,求颜色不会求? 毕 ...
- python面试题&练习题之运算符与if控制
1.任意的输入10个数字,按从大到小排序 l2 = [] for i in range(1,11): num = input('输入第{}个数字'.format(i)) if num.isdigit( ...
- [Codeforces 1251F]Red-White Fence
Description 题库链接 给你 \(n\) 块白木板,\(k\) 块红木板,分别有各自的长度 \(h_i\).让你用这些木板组成一段围栏,要满足: 只用一块红木板,且所有白木板的长度均严格小于 ...