
python爬取博客圆首页文章链接+标题
新人一枚,初来乍到,请多关照
来到博客园,不知道写点啥,那就去瞄一瞄大家都在干什么好了。
使用python 爬取博客园首页文章链接和标题。
首先当然是环境了,爬虫在window10系统下,python3.6.5环境中运行。使用python中的requests模块和BeautifulSoup模块。
通过包管理工具pip3安装requests和BeautifulSoup:
pip3 install requests
pip3 install bs4
贴代码:
import requests

from bs4 import BeautifulSoup
import time

def getlinktitle():

    counts=0

    index=0

    f=open('down.txt','w',encoding='utf-8')

    postData={

        "CategoryType":"SiteHome",

        "ParentCategoryId":0,

        "CategoryId":808,

        "PageIndex":1,#pageIndex确定是第几页,博客园首页共有200页

        "TotalPostCount":4000,

        "ItemListActionName":"PostList"

        }#博客园请求页面使用post请求的请求数据

    try:

        for i in range(0,200):                                                      #博客园首页内容只有200页

            time.sleep(0.2)

            r=requests.post('https://www.cnblogs.com/mvc/AggSite/PostList.aspx',data=postData)

            index+=1

            postData['PageIndex']=index#通过改变PageIndex的值改变请求页

            if r.status_code==200:

                html='<html><head><meta charest="utf-8"><title>自定义标题</title></head><body>'+r.content.decode()+'</body></html>'#将页面补充完整

                soup=BeautifulSoup(html,'lxml')

                links=soup.select('.post_item_body  h3 a')                      #xpath 路径是 //*[@id="post_list"]/div[1]/div[2]/h3

                for i in range(0,len(links)):

                    f.write(links[i].get_text())

            else:

                print(r.status_code)

            r.close()

    except Exception as e:

        print(e)

    finally:

        f.close()
我们将结果保存在文本中了,打开文本可以看到内容都被保存了下来.
能不能让结果更直观一点呢?当然可以,我们可以用词云工具制作一个词云图片。
本次使用wordcloud词云制作工具和jieba分词
首先当然是安装了工具了:
pip3 install wordcloud
pip3 install jieba
pip3 install opencv-python(也可以使用matplotlib的pyplot )
最后贴代码:
import jieba

from  wordcloud import WordCloud,ImageColorGenerator,STOPWORDS

import cv2

def feci():

    img=cv2.imread('bky.jpg')

    with open('down.txt','r',encoding='utf-8') as f:

        fctxt=' '.join(jieba.cut(f.read()))

    wd=WordCloud(background_color='white',width=480,height=480,mask=img,stopwords=STOPWORDS,font_path="C:/windows/字体管家方萌.ttf")

    wd.generate(fctxt)

    imgcolor=ImageColorGenerator(img)

    wd.recolor(color_func=imgcolor)

    wd.to_file('final.jpg')
掩模使用一张博客园的logo(图片来自百度,侵删)

最终效果
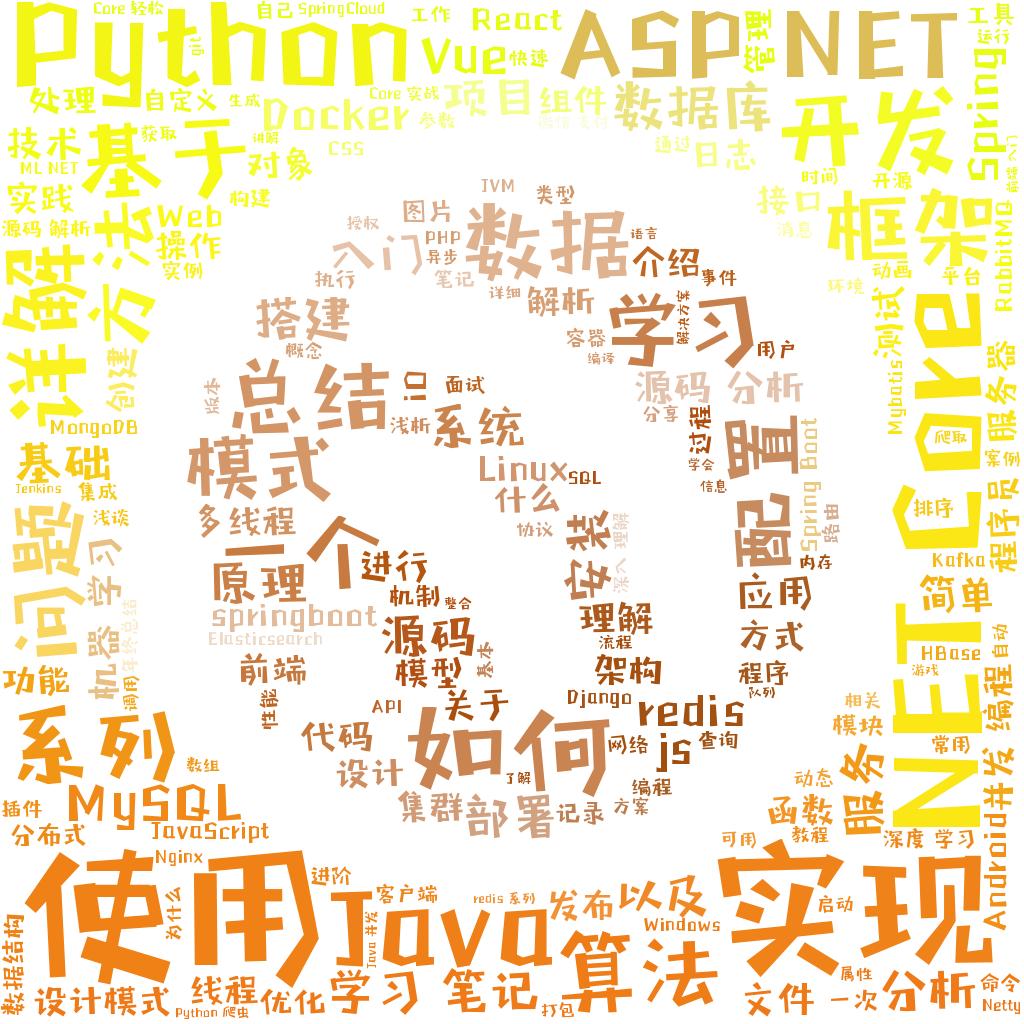
我们可以看到近两个月python,ASP.NET,.NET Core这几个词出现的频率最高(别问我为什么是两个月,因为博客园首页只有200页),感觉自己也是其中的一员呢,感觉以后自己可以放心写了,需要说明一点就是博客园的每一页是psot请求,请求拿到的数据是被<div>标签包围的,并不是完整的html页面,使用beautifulSoup的同学要注意,给得到的数据加上html页面的头部。这样BeautifulSoup才能正常解析。博客园没有反爬虫机制是真的好啊。
最后贴完整代码:
#coding:utf-8

#date:2018-12-27

#author:零度热冰

#content:爬取博客圆首页文章标题

import requests

import time

from bs4 import BeautifulSoup

import jieba

from  wordcloud import WordCloud,ImageColorGenerator,STOPWORDS

import cv2

def getlinktitle():

    counts=0

    index=0

    f=open('down.txt','w',encoding='utf-8')

    postData={

        "CategoryType":"SiteHome",

        "ParentCategoryId":0,

        "CategoryId":808,

        "PageIndex":1,

        "TotalPostCount":4000,

        "ItemListActionName":"PostList"

        }#博客园请求页面使用post请求的请求数据

    try:

        for i in range(0,200):                                                      #博客园首页内容只有200页

            time.sleep(0.2)

            r=requests.post('https://www.cnblogs.com/mvc/AggSite/PostList.aspx',data=postData)

            index+=1

            postData['PageIndex']=index#通过改变PageIndex的值改变请求页

            if r.status_code==200:

                html='<html><head><meta charest="utf-8"><title>自定义标题</title></head><body>'+r.content.decode()+'</body></html>'

                soup=BeautifulSoup(html,'lxml')

                links=soup.select('.post_item_body  h3 a')                      #xpath is //*[@id="post_list"]/div[1]/div[2]/h3

                for i in range(0,len(links)):

                    f.write(links[i].get_text())

            else:

                print(r.status_code)

            r.close()

    except Exception as e:

        print(e)

    finally:

        f.close()

def feci():

    img=cv2.imread('bky.jpg')#使用opencv读取图片

    with open('down.txt','r',encoding='utf-8') as f:

        fctxt=' '.join(jieba.cut(f.read()))

    wd=WordCloud(background_color='white',width=480,height=480,mask=img,stopwords=STOPWORDS,font_path="C:/windows/fonts/字体管家方萌.ttf")

    wd.generate(fctxt)

    imgcolor=ImageColorGenerator(img)

    wd.recolor(color_func=imgcolor)

    wd.to_file('final.jpg')

if __name__=="__main__":

    getlinktitle()

    feci()
python爬取博客圆首页文章链接+标题的更多相关文章
- 爬虫---lxml爬取博客文章
上一篇大概写了下lxml的用法,今天我们通过案例来实践,爬取我的博客博客并保存在本地 爬取博客园博客 爬取思路: 1.首先找到需要爬取的博客园地址 2.解析博客园地址 # coding:utf-8 i ...
- Python爬取腾讯新闻首页所有新闻及评论
前言 这篇博客写的是实现的一个爬取腾讯新闻首页所有的新闻及其所有评论的爬虫.选用Python的Scrapy框架.这篇文章主要讨论使用Chrome浏览器的开发者工具获取新闻及评论的来源地址. Chrom ...
- python 小爬虫爬取博客文章初体验
最近学习 python 走火入魔,趁着热情继续初级体验一下下爬虫,以前用 java也写过,这里还是最初级的爬取html,都没有用html解析器,正则等...而且一直在循环效率肯定### 很低下 imp ...
- Python开发爬虫之动态网页抓取篇:爬取博客评论数据——通过Selenium模拟浏览器抓取
区别于上篇动态网页抓取,这里介绍另一种方法,即使用浏览器渲染引擎.直接用浏览器在显示网页时解析 HTML.应用 CSS 样式并执行 JavaScript 的语句. 这个方法在爬虫过程中会打开一个浏览器 ...
- 使用JAVA爬取博客里面的所有文章
主要思路: 1.找到列表页. 2.找到文章页. 3.用一个队列来保存将要爬取的网页,爬取队头的url,如果队列非空,则一直爬取. 4.如果是列表页,则抽取里面所有的文章url进队:如果是文章页,则直接 ...
- python:爬取博主的所有文章的链接、标题和内容
以爬取我自己的博客为例:https://www.cnblogs.com/Mr-choa/ 1.获取所有的文章的链接: 博客文章总共占两页,比如打开第一页:https://www.cnblogs.com ...
- 爬取博主的所有文章并保存为PDF文件
继续改进上一个项目,上次我们爬取了所有文章,但是保存为TXT文件,查看不方便,而且还无法保存文章中的代码和图片. 所以这次保存为PDF文件,方便查看. 需要的工具: 1.wkhtmltopdf安装包, ...
- Java使用Jsoup之爬取博客数据应用实例
导入Maven依赖 <!-- https://mvnrepository.com/artifact/org.jsoup/jsoup --> <dependency> <g ...
- python爬取安居客二手房网站数据(转)
之前没课的时候写过安居客的爬虫,但那也是小打小闹,那这次呢, 还是小打小闹 哈哈,现在开始正式进行爬虫书写 首先,需要分析一下要爬取的网站的结构: 作为一名河南的学生,那就看看郑州的二手房信息吧! 在 ...
随机推荐
- 浅谈算法——AC自动机
在学习AC自动机之前,你需要两个前置知识:Trie树,KMP 首先我们需要明白,AC自动机是干什么的(用来自动AC的) 大家都知道KMP算法是求单字符串对单字符串的匹配问题的,那么多字符在单字符上匹配 ...
- python入门之三元运算,存址方式,深浅拷贝
三元运算 格式: name = 值1 if 条件 else 值2 如果条件为True,那么将值1赋值给name,条件为False,那么将值2赋值给name 存址方式 不同的数据类型在内存中的存址方式不 ...
- 接口测试03 - Python HTTP库requests
概述: 整理一些requests的相关知识,及如何使用requests进行接口测试. requests号称:是唯一的一个非转基因的Python HTTP库,人类可以安全享用. 安装: 先看下怎么安装r ...
- AQS及其前置知识总结
CLH队列锁 及自旋锁 乐观锁及CAS 独占锁与共享锁 LockSupport与wait ,join和notify 这里截取内部类Node的部分代码,节点的状态值如下: /** waitStatus ...
- nodejs express 设置html后缀模板
express 框架的默认渲染模板的后缀是 ejs ,由于编译器在ejs的文件里写html代码没有高亮显示,所以使用html模板. 示例: var app = express(); app.set(' ...
- POJ 1998 Cube Stacking
Description Farmer John and Betsy are playing a game with N (1 <= N <= 30,000)identical cubes ...
- 解决VS2013无法安装ArcObjects10.2的问题
之前在网上看到的10.1在vs2012安装不上的问题,解决办法是改注册表HKEY_LOCAL_MACHINE\SOFTWARE\Wow6432Node\Microsoft\VisualStudio\1 ...
- windows10 下安装、配置、启动mysql
下载mysql 可以自行去百度 或者 https://dev.mysql.com/downloads/mysql/5.7.html#downloads 解压mysql-5.7.26-winx64.zi ...
- AR报表控件的常见问题汇总
1)字符串格式不正确 原因是建立报表时未使用分页报表 导致拖动数据为sum()表达式,sum运算字符串当然会出问题 2)超出索引 顾名思义 数据为空或不匹配 3)图片使用远程图片时记得把属性修改为远程 ...
- 编写shellcode的几种姿势
今天开始在做hitcon-training的题目,做到lab2就发现了自己的知识盲区,遇到无法执行shell的情况,需要自己打shellcode执行cat flag 操作 经过一系列的搜索,发现了几种 ...